Scrivi il numero di prove n, la probabilità di successo in ogni prova p e il numero di successi k. Ottieni la probabilità di esattamente k successi, le probabilità cumulate di al massimo k e di almeno k, la media, la varianza e la deviazione standard, e un grafico a barre dell’intera distribuzione.
Indice
-
Cosa puoi fare in questa pagina
-
A cosa serve questo calcolo?
-
Come si usa
-
Formule e grafici
-
Simboli e termini
-
Cosa conviene sapere prima
-
Come calcolarlo con Excel
-
Come calcolarlo con Fogli Google
-
Come calcolarlo con Python
-
La formula in LaTeX e in altre notazioni matematiche (da copiare)
-
Come chiedere a ChatGPT di fare il calcolo
-
I punti di forza di DataChef
-
Funzioni correlate
-
Tutte le calcolatrici di NumberChef
Cosa puoi fare in questa pagina
- Scrivi solo 3 numeri per trovare «la probabilità che qualcosa con probabilità \(p\) accada esattamente \(k\) volte in \(n\) tentativi», \(P(X = k) = {}_{n}\mathrm{C}_{k}\, p^{k} (1-p)^{n-k}\), subito
- La risposta compare sia come frazione ridotta ai minimi termini, per esempio \(\dfrac{3}{8}\) (il valore esatto), sia come numero decimale e percentuale. Puoi vedere anche i passaggi per il numero di combinazioni \({}_{n}\mathrm{C}_{k}\)
- Trova anche, nello stesso momento, le probabilità cumulate «al massimo \(k\) volte» \(P(X \le k)\) e «almeno \(k\) volte» \(P(X \ge k)\)
- Mostra il valore atteso \(E(X) = np\), la varianza \(V(X) = np(1-p)\) e la deviazione standard \(\sigma\), e controlla la regola pratica per usare l’approssimazione normale
- L’intera distribuzione, da 0 fino a \(n\) successi, è disegnata come grafico a barre, così vedi a colpo d’occhio quali numeri di successi sono più probabili
A cosa serve questo calcolo?
Se apri 100 loot box (o fai 100 tentativi di gacha) con una probabilità di ottenimento dell’1%, il numero di oggetti rari ottenuti segue la distribuzione binomiale \(B(100,\ 0{,}01)\) (supponendo, come dichiarato, che ogni tentativo abbia la stessa probabilità e sia indipendente). La probabilità di non ottenere nulla è \(0{,}99^{100} \approx 36{,}6\%\), quindi la distribuzione mostra che l’intuizione «100 tentativi all’1% sono quasi una certezza» è rischiosa.
Stimare «il valore atteso \(np\) più la dispersione» quando pianifichi quanto spendere è esattamente il calcolo di questa pagina.
Invece di controllare ogni pezzo, le fabbriche usano il controllo a campione: «prendi \(n\) pezzi da un lotto e accetta il lotto se i difetti sono \(c\) o meno». La probabilità che un lotto con tasso di difetti \(p\) venga accettato è proprio la probabilità binomiale cumulata \(P(X \le c)\). Per esempio, se prendi 20 pezzi da un lotto con l’1% di difetti e lo accetti solo con 0 difetti, la probabilità di accettazione è \(0{,}99^{20} \approx 81{,}8\%\).
Questo calcolo serve a progettare regole di controllo che accettano i lotti buoni con alta probabilità e rifiutano quelli cattivi.
Se rispondi a caso a tutte le 20 domande di un test con 4 opzioni ciascuna, il numero di risposte esatte segue la distribuzione binomiale \(B(20,\ 0{,}25)\) e il valore atteso è \(20 \times 0{,}25 = 5\) domande. La probabilità di azzeccarne 8 o più per caso è solo di circa il 10%, il che conferma con la probabilità che indovinare a caso raramente basta per raggiungere la sufficienza.
Anche chi prepara i test tiene presente questa distribuzione quando stabilisce il numero di domande e il punteggio minimo, così da rendere difficile superare la prova per fortuna.
Quando un giocatore con il 70% ai tiri liberi fa 10 tiri, la probabilità di segnarne esattamente 7 è solo \({}_{10}\mathrm{C}_{7} \times 0{,}7^{7} \times 0{,}3^{3} \approx 26{,}7\%\) (considerando ogni tiro indipendente con una percentuale di successo fissa). Un giocatore al 70% che segna esattamente 7 tiri su 10 non è così ordinario come sembra. Segnarne 6 o 8 capita di continuo.
La distribuzione binomiale ti aiuta a capire quanta parte di una «serie positiva» o di un «periodo no» sia solo normale variazione casuale.
Nei sondaggi sul gradimento e negli ascolti TV (come la rilevazione Auditel), il numero di persone, tra le \(n\) intervistate, che danno una certa risposta si considera distribuito secondo una distribuzione binomiale. Il margine di errore «più o meno qualche punto» si calcola dalla deviazione standard \(\sqrt{np(1-p)}\) e dall’approssimazione normale.
Decidere quante persone intervistare per portare il margine di errore alla dimensione voluta si basa direttamente sulle proprietà della distribuzione binomiale.
Formule e grafici
Simboli e termini
Simboli
| \(X\) | X | La variabile casuale che indica il numero di successi. Per convenzione i numeri decisi dal caso si scrivono con lettere maiuscole della fine dell’alfabeto, come \(X,\ Y,\ Z\). |
| \(P(X = k)\) | P di X uguale a k | La probabilità che il numero di successi \(X\) sia esattamente \(k\). \(P\) è l’iniziale di «probabilità». |
| \({}_{n}\mathrm{C}_{k}\) | n su k | Il numero di combinazioni di \(k\) elementi scelti tra \(n\). \(C\) è l’iniziale di «combinazione». Molti libri la scrivono \(\dbinom{n}{k}\) (coefficiente binomiale) o \(C_{n,k}\). |
| \(n\) | enne | Il numero di prove (quante volte lo ripeti). Per indicare una quantità si usa spesso la lettera \(n\), da «numero». |
| \(p\) | pi | La probabilità di successo in una prova. Viene da «probabilità» e la lettera minuscola si usa spesso per la probabilità di un singolo tentativo. |
| \(1 - p\) | uno meno p | La probabilità di insuccesso in una prova (non avere successo). Accade sempre o il successo o l’insuccesso, quindi è ciò che resta togliendo \(p\) dal totale \(1\). Si scrive anche \(q\). |
| \(k\) | cappa | Il numero di successi, un numero intero da \(0\) a \(n\). La lettera \(k\) si usa spesso per dire «quante volte». |
| \(P(X \le k)\) | P di X minore o uguale a k | La probabilità di al massimo \(k\) successi (uno qualsiasi tra 0 e \(k\)). È una probabilità cumulata, cioè le probabilità esatte sommate fino a \(k\). |
| \(P(X \ge k)\) | P di X maggiore o uguale a k | La probabilità di almeno \(k\) successi (uno qualsiasi tra \(k\) e \(n\)). Sottraendo \(P(X \le k-1)\) dal totale \(1\) (l’evento contrario) la somma si accorcia. |
| \(E(X)\) | E di X | Il valore atteso (il numero medio di successi). \(E\) è l’iniziale di «expectation». Per la distribuzione binomiale, \(E(X) = np\). Si chiama anche media e si scrive \(\mu\). |
| \(V(X)\) | V di X | La varianza (quanto sono dispersi i risultati). \(V\) è l’iniziale di «varianza». Per la distribuzione binomiale, \(V(X) = np(1-p)\). Si scrive anche \(\mathrm{Var}(X)\) o \(\sigma^2\). |
| \(\sigma\) | sigma | La deviazione standard. È la lettera greca minuscola sigma, la «s» greca di «deviazione standard». È la radice quadrata della varianza, \(\sigma = \sqrt{V(X)}\), e mostra la distanza tipica dal valore atteso. |
| \(B(n,\ p)\) | B di n, p | La distribuzione binomiale con \(n\) prove e probabilità di successo \(p\). \(B\) è l’iniziale di «binomiale». «\(X\) segue una distribuzione binomiale» si scrive \(X \sim B(n,\ p)\). |
| \(N(\mu,\ \sigma^2)\) | N di mu, sigma al quadrato | La distribuzione normale con media \(\mu\) e varianza \(\sigma^2\). \(N\) è l’iniziale di «normale». Per convenzione l’ordine tra parentesi è «media, varianza». |
| \(\approx\) | circa uguale a | Il simbolo di «circa uguale». In questa pagina mostra che la distribuzione binomiale si può sostituire in modo approssimato con la distribuzione normale. |
Termini
| distribuzione binomiale | La distribuzione di probabilità di «quante volte accade qualcosa con probabilità \(p\) in \(n\) tentativi». Il nome deriva dal fatto che il \({}_{n}\mathrm{C}_{k}\) della formula è lo stesso del coefficiente binomiale (i coefficienti dello sviluppo del binomio \((a+b)^n\)). Si studia di solito nella scuola secondaria di secondo grado (probabilità e statistica). |
| variabile casuale | Una variabile il cui valore è deciso dal caso. In questa pagina la variabile casuale è il numero di successi. Assume i valori da 0 fino a n, ciascuno con la propria probabilità. |
| prova | Una singola esecuzione di un esperimento o di un’osservazione il cui risultato è deciso dal caso, come un lancio di moneta o l’estrazione di un biglietto. |
| prove ripetute | Ripetere la stessa prova con la stessa probabilità ogni volta, con risultati che non si influenzano (in modo indipendente). Si chiamano anche prove di Bernoulli (o schema di Bernoulli). La distribuzione binomiale è la distribuzione del numero di successi in prove ripetute. |
| indipendente | Quando il risultato di una prova non influisce sul risultato di un’altra. Il primo e il secondo lancio di un dado sono indipendenti, mentre estrarre biglietti senza rimetterli dentro non lo è (i risultati precedenti cambiano quanti biglietti vincenti restano). |
| combinazione | Un modo di scegliere \(k\) elementi tra \(n\) in cui l’ordine non conta. Il loro numero totale è \({}_{n}\mathrm{C}_{k}\). Nella distribuzione binomiale conta i modi di scegliere quali tra le \(n\) prove hanno successo. |
| probabilità cumulata | Le probabilità esatte sommate fino a un certo numero. La probabilità di al massimo \(k\), \(P(X \le k)\), ne è l’esempio tipico. |
| evento contrario | L’evento in cui qualcosa non accade. Le probabilità sommano sempre 1, quindi una probabilità come «almeno \(k\)» si trova facilmente sottraendo da 1 il lato opposto (al massimo \(k-1\)). |
| valore atteso | Il valore medio quando ripeti le prove molte volte. Per la distribuzione binomiale è il numero medio di successi, dato dalla semplice formula \(np\). |
| varianza | Una misura di quanto i valori effettivi tendono a distanziarsi dal valore atteso (la dispersione). È definita come la media dei quadrati delle differenze. |
| deviazione standard | La radice quadrata della varianza. La varianza è in unità al quadrato, quindi con la radice quadrata si torna all’unità originale (qui, il numero di successi) come misura della dispersione. |
| distribuzione normale | Una distribuzione simmetrica a forma di campana in cui i valori vicini alla media sono i più probabili e quelli più lontani sono meno probabili. Molte grandezze reali, come le altezze e gli errori di misura, si avvicinano a questa forma e anche la distribuzione binomiale le si avvicina quando \(n\) è grande. |
| approssimazione normale | Sostituire la distribuzione binomiale con la distribuzione normale \(N(np,\ np(1-p))\) quando \(n\) è grande. La regola pratica più comune è \(np \ge 5\) e \(n(1-p) \ge 5\). |
Cosa conviene sapere prima
Ecco cosa ti aiuta a usare il calcolo di questa pagina capendolo davvero, e non solo premendo il pulsante.
Se ti blocchi, ripassare gli argomenti di questa tabella è la via più rapida per andare avanti.
| Probabilità di base (scuola secondaria di primo grado, 11-14 anni) |
|
| Frazioni (classi 4ª–5ª della primaria e 1ª della secondaria di primo grado, 9-12 anni) |
|
| Potenze ed esponenti (scuola secondaria di primo grado, 11-14 anni) |
|
| Calcolo combinatorio e combinazioni (scuola secondaria di secondo grado) |
|
| Probabilità di prove ripetute ed evento contrario (scuola secondaria di secondo grado) |
|
| Variabili casuali, valore atteso e varianza (scuola secondaria di secondo grado) |
|
| La distribuzione normale (scuola secondaria di secondo grado) |
|
Come calcolarlo con Excel
| Numero di prove n | 4 |
| Probabilità di successo p | 0,5 |
| Numero di successi k | 2 |
| Probabilità di esattamente k P(X=k) | =DISTRIB.BINOM.N(B3;B1;B2;FALSO) |
| Numero di prove n | 4 |
| Probabilità di successo p | 0,5 |
| Numero di successi k | 2 |
| Probabilità di al massimo k P(X≤k) | =DISTRIB.BINOM.N(B3;B1;B2;VERO) |
| Probabilità di almeno k P(X≥k) | =1-DISTRIB.BINOM.N(B3-1;B1;B2;VERO) |
| Numero di prove n | 30 |
| Probabilità di successo p | =1/6 |
| Media E(X) = np | =B1*B2 |
| Varianza V(X) = np(1-p) | =B1*B2*(1-B2) |
| Deviazione standard σ | =RADQ(B4) |
| Numero di prove n | 20 |
| Probabilità di successo p | 0,5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| Regola pratica rispettata? | =E(B3>=5;B4>=5) |
DISTRIB.BINOM.N è la funzione della distribuzione binomiale. I suoi argomenti sono, nell’ordine, «numero di successi, numero di prove, probabilità di successo, cumulativa o no». FALSO alla fine dà la probabilità esatta e VERO dà la probabilità cumulata di quel numero o meno.
La prima tabella è l’esempio di esattamente 2 teste in 4 lanci di moneta e la risposta è 0,375 (= 3/8).
Le due risposte della seconda tabella sono entrambe 0,6875. «Almeno k» si trova sottraendo da 1 «al massimo k−1» (questa formula dà un errore se k è 0, ma la probabilità di 0 o più è sempre 1).
La terza tabella è il numero di 1 in 30 lanci di un dado: media 5, varianza 4,1667 e deviazione standard 2,0412.
La quarta tabella mostra VERO quando np e n(1−p) sono entrambi 5 o più (la regola pratica per l’approssimazione normale è rispettata) e FALSO altrimenti.
Come calcolarlo con Fogli Google
| Numero di prove n | 4 |
| Probabilità di successo p | 0,5 |
| Numero di successi k | 2 |
| Probabilità di esattamente k P(X=k) | =DISTRIB.BINOM(B3;B1;B2;FALSO) |
| Numero di prove n | 4 |
| Probabilità di successo p | 0,5 |
| Numero di successi k | 2 |
| Probabilità di al massimo k P(X≤k) | =DISTRIB.BINOM(B3;B1;B2;VERO) |
| Probabilità di almeno k P(X≥k) | =1-DISTRIB.BINOM(B3-1;B1;B2;VERO) |
| Numero di prove n | 30 |
| Probabilità di successo p | =1/6 |
| Media E(X) = np | =B1*B2 |
| Varianza V(X) = np(1-p) | =B1*B2*(1-B2) |
| Deviazione standard σ | =RADQ(B4) |
| Numero di prove n | 20 |
| Probabilità di successo p | 0,5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| Regola pratica rispettata? | =E(B3>=5;B4>=5) |
Come in Excel, la formula «almeno k» dà un errore se k è 0 (la probabilità di 0 o più è sempre 1).
Come calcolarlo con Python
from fractions import Fraction
from math import comb, sqrt

trial_count = 4                  # numero di prove n
success_prob = Fraction(1, 2)    # probabilità di successo p (funziona anche un decimale come 0.3)
success_count = 2                # numero di successi k

failure_prob = 1 - success_prob

# probabilità di esattamente k successi P(X=k) = nCk × p^k × (1−p)^(n−k)
exact_prob = (comb(trial_count, success_count)
              * success_prob ** success_count
              * failure_prob ** (trial_count - success_count))
print(f"Probabilità di esattamente {success_count}: {exact_prob} = {float(exact_prob)}")

# probabilità cumulate (al massimo k, almeno k)
prob_le = sum(comb(trial_count, i) * success_prob ** i * failure_prob ** (trial_count - i)
              for i in range(success_count + 1))
prob_ge = 1 - prob_le + exact_prob
print(f"Probabilità di al massimo {success_count}: {prob_le} = {float(prob_le)}")
print(f"Probabilità di almeno {success_count}: {prob_ge} = {float(prob_ge)}")

# media, varianza e deviazione standard
mean = trial_count * success_prob
variance = mean * failure_prob
print(f"Media: {mean}  Varianza: {variance}  Deviazione standard: {sqrt(variance)}")
La formula in LaTeX e in altre notazioni matematiche (da copiare)
P(X = k) = nCk pᵏ (1 − p)ⁿ⁻ᵏ
P(X = k) = \binom{n}{k} p^{k} (1 - p)^{n - k}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>=</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>k</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>k</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>k</mi></mrow>
</msup>
</mrow>
</math>
P(X = k) = C(n,k) p^k (1-p)^(n-k)
PDF[BinomialDistribution[n, p], k]
binomial(n, k)*p^k*(1-p)^(n-k);
binopdf(k, n, p)
P(X=k) = C(n,k) p^k (1-p)^(n-k)
P(X ≤ k) = Σ[i=0→k] nCi pⁱ (1 − p)ⁿ⁻ⁱ
P(X \le k) = \sum_{i=0}^{k} \binom{n}{i} p^{i} (1 - p)^{n - i}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>≤</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>0</mn></mrow>
<mi>k</mi>
</munderover>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>i</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>i</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>i</mi></mrow>
</msup>
</mrow>
</math>
P(X <= k) = sum_(i=0)^k C(n,i) p^i (1-p)^(n-i)
CDF[BinomialDistribution[n, p], k]
add(binomial(n, i)*p^i*(1-p)^(n-i), i = 0..k);
binocdf(k, n, p)
P(X≤k) = Σ_(i=0)^k C(n,i) p^i (1-p)^(n-i)
E(X) = np, V(X) = np(1 − p), σ = √(np(1 − p))
E(X) = np, \quad V(X) = np(1 - p), \quad \sigma = \sqrt{np(1 - p)}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo><mi>n</mi><mi>p</mi>
<mo>,</mo>
<mi>V</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>,</mo>
<mi>σ</mi><mo>=</mo>
<msqrt><mi>n</mi><mi>p</mi><mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow></msqrt>
</mrow>
</math>
E(X) = np, V(X) = np(1-p), sigma = sqrt(np(1-p))
{Mean[BinomialDistribution[n, p]], Variance[BinomialDistribution[n, p]], StandardDeviation[BinomialDistribution[n, p]]}
n*p; n*p*(1-p); sqrt(n*p*(1-p));
[m, v] = binostat(n, p); s = sqrt(v);
E(X) = np, V(X) = np(1-p), σ = √(np(1-p))
B(n, p) ≈ N(np, np(1 − p))
B(n,\ p) \approx N(np,\ np(1 - p))
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>B</mi><mo>(</mo><mi>n</mi><mo>,</mo><mi>p</mi><mo>)</mo>
<mo>≈</mo>
<mi>N</mi><mo>(</mo><mi>n</mi><mi>p</mi><mo>,</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>)</mo>
</mrow>
</math>
B(n, p) ~~ N(np, np(1-p))
NormalDistribution[n p, Sqrt[n p (1 - p)]]
Normal(n*p, sqrt(n*p*(1-p)));
pd = makedist('Normal', 'mu', n*p, 'sigma', sqrt(n*p*(1-p)));
B(n, p) ≈ N(np, np(1-p))
Come chiedere a ChatGPT di fare il calcolo
Sei un assistente per il calcolo di matematica (probabilità e statistica). Fai il calcolo seguente eseguendo davvero codice Python e basa la risposta solo sui numeri del risultato dell’esecuzione (non rispondere con calcoli a mente o a caso).

Partecipi 10 volte a un’estrazione e a ogni partecipazione hai 1/6 di probabilità di vincere. Per la distribuzione binomiale del numero di vincite, trova:
1. La probabilità di vincere esattamente 2 volte, P(X=2) (come frazione ridotta ai minimi termini e come numero decimale)
2. La probabilità di al massimo 2 vincite, P(X≤2), e di almeno 2 vincite, P(X≥2)
3. La media E(X), la varianza V(X) e la deviazione standard σ
4. Se la regola pratica per l’approssimazione normale, np ≥ 5 e n(1−p) ≥ 5, è rispettata

In Python calcola in modo esatto con le frazioni e con math.comb della libreria standard e mostra le formule che hai usato e i numeri del risultato dell’esecuzione.
Come si usa
-
1Inserisci i numeriScrivi nei campi i numeri con cui vuoi fare il calcolo
-
2CalcolaFai clic sul pulsante «Calcola»
-
3Guarda il risultatoIl risultato compare subito. Nella stessa pagina trovi anche lo svolgimento del calcolo e la spiegazione della formula
I punti di forza di DataChef

Nessuna competenza richiesta, semplice e intuitivo

Nessun dato personale richiesto

Il file viene eliminato automaticamente dopo il download


Nessun obbligo di attribuzione

Nessuna autorizzazione preventiva necessaria
Funzioni correlate
Probabilità di prove ripetute (n volte di fila, almeno una volta)
Calcola la probabilità che qualcosa accada n volte di fila, almeno una volta o mai
Calcolatrice del valore atteso (media, varianza, deviazione standard)
Calcola il valore atteso E(X), la varianza V(X) e la deviazione standard da una tabella della distribuzione di probabilità. Vale per qualsiasi distribuzione, non solo per la binomiale
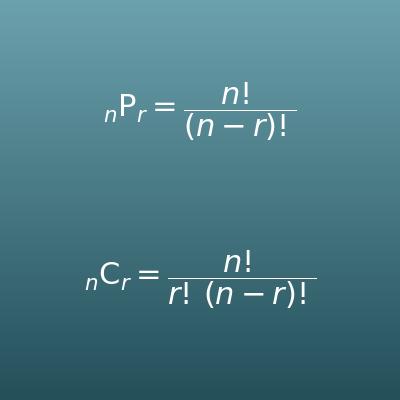
Calcolatrice di disposizioni e combinazioni (nPr, nCr)
Calcola da solo il numero di combinazioni nCr (nCk) che compare nella formula binomiale, con i passaggi