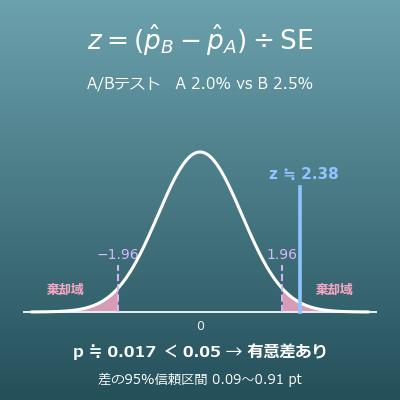
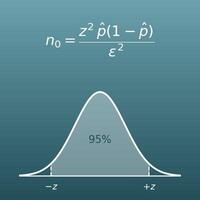
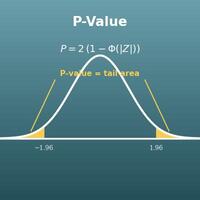
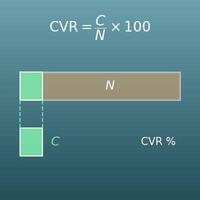
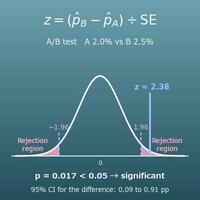
Per trovare la numerosità, inserisci il CVR di base, l’MDE, il livello di significatività e la potenza, poi fai clic su «Calcola». Ottieni la numerosità per gruppo per A e B (arrotondata per eccesso) e il totale, più i giorni necessari se inserisci i visitatori giornalieri. Cambia «Che cosa cercare» in potenza per fissare la numerosità per gruppo e ricavare invece la potenza 1 − β.
Indice
-
Cosa puoi fare in questa pagina
-
A cosa serve questo calcolo?
-
Come si usa
-
Formule e figure
-
Simboli e termini
-
Cosa conviene sapere prima
-
Come calcolarlo con Excel
-
Come calcolarlo con Fogli Google
-
Come calcolarlo con Python
-
La formula in LaTeX e in altre notazioni matematiche (da copiare)
-
Come chiedere a ChatGPT di fare il calcolo
-
I punti di forza di DataChef
-
Funzioni correlate
-
Tutte le calcolatrici di NumberChef
Cosa puoi fare in questa pagina
- Inserisci il CVR di base (il tasso di conversione della versione A attuale), l’effetto minimo rilevabile (MDE, come incremento relativo in % o in punti percentuali), il livello di significatività \(\alpha\) (due code o una coda) e la potenza \(1-\beta\). Ottieni la numerosità che serve a ciascun gruppo del tuo test A/B (arrotondata per eccesso) e il totale
- «La mia pagina converte al 3%. Quanti visitatori servono ad A e a B per rilevare un incremento del 10% (dal 3% al 3,3%)?» Questa pagina risponde alla domanda più importante da farsi prima di iniziare un test
- Se aggiungi i visitatori giornalieri (facoltativo) vedi anche in quanti giorni raggiungi quella numerosità (arrotondata per eccesso)
- Se puoi raccogliere solo un certo numero di visitatori per gruppo, fissa la numerosità e ricava la potenza \(1-\beta\) (la probabilità di trovare una differenza quando c’è davvero)
- In questa pagina trovi anche un grafico di come cambia la numerosità al variare dell’MDE, una spiegazione semplice delle formule e le formule da copiare e incollare per Excel, Fogli Google e Python
A cosa serve questo calcolo?
Supponi che la pagina di un prodotto di un negozio online converta al 2% e che tu voglia rilevare un incremento relativo del 10% (dal 2% al 2,2%) con un nuovo testo del pulsante. Con un livello di significatività del 5% (due code) e una potenza dell’80%, servono circa 80.682 visitatori per gruppo, circa 161.364 in totale.
Confrontare qualche decina o qualche centinaio di visitatori («la settimana scorsa B è andato meglio») non permette di distinguere una differenza casuale da una reale. Calcolare la numerosità prima di iniziare ti evita di passare settimane su un test che non può dare una risposta.
Una pagina di destinazione riceve richieste di demo con un CVR del 5%. Per rilevare un incremento di 1 punto (dal 5% al 6%) servono 8158 visitatori per gruppo, 16.316 in totale. Con 300 visite al giorno sono \(16316 \div 300 \approx 54{,}4\), quindi 55 giorni, oppure 8 settimane se vuoi uniformare i giorni della settimana.
Se qualcuno chiede i risultati in 2 settimane, questo calcolo ti permette di spiegare con i numeri: «In 2 settimane (4200 visitatori, 2100 per gruppo) servirebbe un MDE molto più grande, intorno a 3 punti (dal 5% all’8%, che richiede 1059 per gruppo)».
Se la tua newsletter ha un tasso di apertura del 20% e vuoi rilevare un incremento di 2 punti (dal 20% al 22%) con un nuovo oggetto, devi inviarla a 6510 persone per gruppo, 13.020 in totale (livello di significatività del 5%, potenza dell’80%).
Un indicatore con una percentuale alta, come il tasso di apertura, richiede meno persone per mostrare una differenza di un CVR di pochi punti percentuali. Il motivo è che cambia la parte \(p(1-p)\) della formula: gli stessi «2 punti» richiedono una numerosità diversa per ogni indicatore.
Supponi che un test mirato a un incremento relativo del 10% su una pagina con un CVR del 3% sia stato eseguito con 5000 visitatori per gruppo e abbia mostrato «nessuna differenza significativa». Ricavando la potenza a ritroso si ottiene solo circa il 13,5%. Il test era impostato per perdere un miglioramento reale più di 8 volte su 10.
La conclusione giusta qui non è «non ha avuto effetto» ma «con questa numerosità non si poteva dire». Ricavare la potenza a ritroso ti evita di leggere male un test e di buttare via una buona idea.
Un’app ha una fidelizzazione del 40% il giorno dopo. Per rilevare un incremento relativo del 10% (dal 40% al 44%) con un nuovo tutorial bastano circa 2389 nuovi utenti per gruppo, circa 4778 in totale (livello di significatività del 5%, potenza dell’80%).
Un indicatore vicino al 50%, come la fidelizzazione, ha una variabilità grande, ma anche la differenza dei tassi (4 punti) è grande, quindi i risultati arrivano più in fretta che in un test su un CVR di pochi punti percentuali. Stimare la numerosità per ogni indicatore ti aiuta anche a decidere su quale miglioramento lavorare per primo.
Per un test in cui perdere una buona idea costerebbe caro, come un cambiamento nel modo di mostrare i prezzi, puoi alzare la potenza dall’80% al 90%. Con un CVR del 3% e un incremento relativo del 10%, la numerosità per gruppo sale da 53.211 a 71.233 (circa 1,34 volte).
Questo calcolo mostra esattamente quanti visitatori in più servono per dimezzare le mancate rilevazioni (dal 20% al 10%), così puoi adeguare la numerosità e la durata del test all’importanza del test.
Formule e figure
Simboli e termini
Simboli
| \(p_1\) | pi uno | Il CVR di base (il tasso di conversione della versione A attuale). \(p\) sta per proporzione o probabilità. Nelle formule il 3% si scrive come il decimale 0,03. |
| \(p_2\) | pi due | Il CVR obiettivo (il tasso di conversione che speri raggiunga la versione B). È \(p_1 (1 + r/100)\) per un incremento relativo in % e \(p_1 + d\) per i punti percentuali. |
| \(\bar{p}\) | pi con barra | La media dei due CVR, \((p_1 + p_2) \div 2\). È il CVR comune che supponi quando non c’è differenza. In statistica la barra in alto indica una media. |
| \(r\) | erre | L’MDE indicato come incremento relativo in %. Sta per «rapporto» e dice di quanto per cento migliora il CVR di base (dal 3% al 3,3% si ha \(r = 10\)). |
| \(d\) | di | L’MDE indicato in punti percentuali. Sta per «differenza» ed è la semplice differenza di CVR (dal 3% al 3,3% si ha \(d = 0{,}3\) punti). |
| \(p_2 - p_1\) | pi due meno pi uno | La differenza da rilevare, in punti percentuali scritti come decimale (0,3 punti sono 0,003). La numerosità si divide per il suo quadrato, quindi più la differenza è piccola, più la numerosità cresce in fretta. |
| \(\alpha\) | alfa | Il livello di significatività: la probabilità di dichiarare reale una differenza che non c’è (la probabilità di un errore di primo tipo). Il 5% (0,05) è la scelta più comune. Alfa è la prima lettera dell’alfabeto greco e in statistica indica la probabilità del «primo» tipo di errore. |
| \(\beta\) | beta | La probabilità di non vedere una differenza che c’è davvero (la probabilità di un errore di secondo tipo). Beta è la seconda lettera dell’alfabeto greco e indica la probabilità del «secondo» tipo di errore. |
| \(1-\beta\) | uno meno beta | La potenza: la probabilità di trovare una differenza quando c’è davvero. Si usa di solito l’80% o il 90%. |
| \(z_{\alpha/2}\) | zeta con pedice alfa mezzi | Il punteggio z per il livello di significatività \(\alpha\) in un test a due code (il punto con \(\alpha/2\) della distribuzione normale standard sopra di sé). Vale 1,9600 al 5%, 2,5758 all’1% e 1,6449 al 10%. Un test a una coda usa invece \(z_{\alpha}\) (1,6449 al 5%). |
| \(z_{\beta}\) | zeta con pedice beta | Il punteggio z per la potenza \(1-\beta\) (il punto con probabilità \(1-\beta\) della distribuzione normale standard sotto di sé). Vale 0,8416 all’80% e 1,2816 al 90%. |
| \(z_{1-\beta}\) | zeta con pedice uno meno beta | Nella formula della potenza, il punteggio z ricavato a ritroso dalla numerosità. Mettilo in \(\Phi\) e ottieni la potenza. (È la stessa cosa di \(z_{\beta}\), scritta dal lato del valore che stai cercando.) |
| \(\Phi\) | fi maiuscola | La funzione di ripartizione della distribuzione normale standard. Restituisce la probabilità che un punteggio z sia uguale o minore di un dato valore: \(\Phi(1{,}96) \approx 0{,}975\) e \(\Phi(0{,}8416) \approx 0{,}80\). La lettera greca fi maiuscola è il simbolo abituale di questa funzione. |
| \(n\) | enne | La numerosità per gruppo (per ciascuna delle versioni A e B). Sta per «numero». Il totale di A e B è \(2n\). |
| \(\sqrt{\ \ }\) | radice quadrata | La radice quadrata: il numero positivo che elevato al quadrato dà il numero sotto la radice, per esempio \(\sqrt{30000} \approx 173{,}205\). Compare quando si trova la variabilità (la deviazione standard) di un CVR. |
| \(V\) | vu | I visitatori giornalieri (tutte le visite alla pagina testata, A e B insieme). Sta per «visite». |
| \(D\) | di maiuscola | I giorni necessari. Sta per «giorni». |
| \(\lceil\ \rceil\) | parte intera superiore | Il simbolo dell’arrotondamento per eccesso (la funzione parte intera superiore). Dà il più piccolo numero intero uguale o maggiore del numero all’interno (\(\lceil 53{,}211 \rceil = 54\)). |
Termini
| test A/B | Un esperimento che divide a caso (assegnazione casuale) i visitatori tra la versione attuale (A) e una nuova versione (B) nello stesso periodo, per vedere quale rende meglio (per esempio ha un CVR più alto). Serve a verificare con i dati, e non a intuito, se un cambiamento come il colore di un pulsante, un titolo, il modo di mostrare un prezzo o la struttura di una pagina di destinazione aiuta davvero. |
| tasso di conversione (CVR) | La quota di visitatori o di clic che portano a un’azione obiettivo (una conversione), come un acquisto o un’iscrizione. Nelle formule di questa pagina il CVR della versione A è \(p_1\) e quello della versione B è \(p_2\). |
| MDE (effetto minimo rilevabile) | Il più piccolo incremento che vuoi riuscire a rilevare. È il primo valore da decidere quando progetti un test A/B. Più è piccolo, più la numerosità cresce in fretta (è inversamente proporzionale al quadrato della differenza), quindi scegli il più piccolo incremento che conterebbe per la tua attività. |
| livello di significatività | La probabilità \(\alpha\) dell’errore che sei disposto ad accettare, cioè vedere una differenza casuale e dichiararla reale quando non c’è alcuna differenza. Il 5% è lo standard e ammette un falso allarme circa una volta su 20. Un livello più severo (1%) richiede una numerosità maggiore. |
| potenza statistica | La probabilità \(1-\beta\) di trovare una differenza quando c’è davvero. L’80% è lo standard e ammette di perdere un incremento reale circa una volta su 5. Se un test con poca potenza dice «nessuna differenza», non è una prova che la differenza non esista. |
| errore di primo tipo | L’errore di dichiarare reale una differenza che non c’è (un falso positivo). La probabilità che ammetti è il livello di significatività \(\alpha\). È l’altra faccia di un errore di secondo tipo (una mancata rilevazione): abbassare uno tende ad alzare l’altro. Il modo più semplice per ridurli entrambi è una numerosità maggiore. |
| errore di secondo tipo | L’errore di non vedere una differenza che c’è davvero (un falso negativo). La sua probabilità è \(\beta\) e \(1-\beta\) è la potenza. È l’altra faccia di un errore di primo tipo (un falso allarme): abbassare uno tende ad alzare l’altro. Il modo più semplice per ridurli entrambi è una numerosità maggiore. |
| ipotesi nulla | L’ipotesi che «le versioni A e B abbiano lo stesso CVR», che il test cerca di rifiutare. Il test si chiede quanto sarebbero insoliti i dati se l’ipotesi nulla fosse vera. Se lo sono abbastanza, l’ipotesi nulla viene rifiutata e il risultato è «c’è una differenza». |
| ipotesi alternativa | L’ipotesi che «le versioni A e B abbiano CVR diversi», che il test cerca di mostrare. Viene accettata quando l’ipotesi nulla (nessuna differenza) viene rifiutata. |
| test a due code | Un test che conta come differenza sia «B è più alto» sia «B è più basso». Si usa in un normale test A/B, in cui non sai da che parte andrà. Richiede una numerosità maggiore di un test a una coda, ma coglie anche il caso in cui B va peggio. |
| test a una coda | Un test che cerca solo «B è più alto». Richiede una numerosità minore di un test a due code, ma non coglie il caso in cui B va peggio, quindi devi sceglierlo prima dell’inizio del test. (Passare a una coda dopo aver visto i risultati non è valido.) |
| test z per due proporzioni | Un test che verifica se due gruppi differiscono in una proporzione (come il CVR), usando un punteggio z (la differenza standardizzata) e la distribuzione normale standard. Le formule di questa pagina trovano la numerosità per questo test. L’approssimazione normale funziona quando ogni gruppo ha abbastanza conversioni (come regola pratica, almeno 5-10). |
| distribuzione normale standard | La distribuzione normale con media 0 e deviazione standard 1 (a campana, simmetrica). Un punteggio z è un punto del suo asse orizzontale e a ogni punteggio z corrisponde una sola probabilità, come in «l’area a destra di 1,96 è il 2,5%». |
| funzione di ripartizione | Una funzione che restituisce la probabilità di ottenere un dato valore o uno minore. Quella della distribuzione normale standard si scrive \(\Phi\) e compare alla fine della formula della potenza. In Excel è DISTRIB.NORM.ST.N (con VERO come secondo argomento) e in Python è NormalDist().cdf. |
| deviazione standard (variabilità) | Quanto sono dispersi i dati. La variabilità di una proporzione \(p\) è proporzionale a \(\sqrt{p(1-p)}\). Le espressioni \(\sqrt{2\bar{p}(1-\bar{p})}\) e \(\sqrt{p_1(1-p_1)+p_2(1-p_2)}\) delle formule sono la variabilità della differenza tra i CVR dei due gruppi. |
| confronti multipli | Confrontare insieme più versioni B o più indicatori. Più confronti fai, più è probabile che almeno uno sembri significativo per caso, quindi serve una correzione, come dividere il livello di significatività per il numero di confronti (la correzione di Bonferroni). |
| interruzione anticipata (peeking) | Controllare i risultati più e più volte prima di raggiungere la numerosità necessaria e fermarsi appena il risultato sembra significativo. Rende facile prendere per vera una differenza dovuta al caso, quindi un test pensato per un livello di significatività del 5% sbaglia in realtà molto più spesso. Le formule di questa pagina presuppongono che tu fissi prima la numerosità e aspetti di raggiungerla. |
Cosa conviene sapere prima
Ecco che cosa conviene sapere per usare il calcolo di questa pagina capendo davvero che cosa fai, e non solo premendo il pulsante.
Se ti blocchi, ripassare questi argomenti è la strada più rapida.
| Percentuali (scuola primaria e secondaria di primo grado, 10-12 anni) |
|
| Radici quadrate (scuola secondaria di primo grado, 13-14 anni) |
|
| Probabilità di base (scuola secondaria di primo e secondo grado, 12-16 anni) |
|
| La distribuzione normale e i punteggi z (statistica, scuola secondaria di secondo grado, 14-19 anni) |
|
| La logica del test di ipotesi (ultimi anni delle superiori o statistica universitaria di base, 17-20 anni) |
|
| Arrotondamento (scuola primaria, 9-10 anni) |
|
Come calcolarlo con Excel
| CVR di base p1 (%) | 3 |
| Incremento relativo r (%) | 10 |
| CVR obiettivo p2 (%) | =B1*(1+B2/100) |
| CVR di base p1 (%) | 3 |
| CVR obiettivo p2 (%) | 3,3 |
| Livello di significatività α (%, due code) | 5 |
| Potenza 1−β (%) | 80 |
| z_α/2 | =INV.NORM.S(1-B3/100/2) |
| z_β | =INV.NORM.S(B4/100) |
| CVR medio p̄ | =(B1+B2)/2/100 |
| Numerosità per gruppo n (arrotondata per eccesso) | =ARROTONDA.PER.ECC((B5*RADQ(2*B7*(1-B7))+B6*RADQ(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Numerosità per gruppo n | 53211 |
| Visitatori giornalieri V (totale A + B) | 2000 |
| Giorni necessari D (arrotondati per eccesso) | =ARROTONDA.PER.ECC(2*B1/B2;0) |
| CVR di base p1 (%) | 3 |
| CVR obiettivo p2 (%) | 3,3 |
| Livello di significatività α (%, due code) | 5 |
| Numerosità per gruppo n | 30000 |
| z_α/2 | =INV.NORM.S(1-B3/100/2) |
| CVR medio p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ASS(B2-B1)/100*RADQ(B4)-B5*RADQ(2*B6*(1-B6)))/RADQ(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Potenza 1−β (%) | =DISTRIB.NORM.ST.N(B7;VERO)*100 |
La prima tabella mostra 3,3 in B3 (un CVR obiettivo del 3,3%), la seconda mostra 53211 in B8 (la numerosità per gruppo), la terza mostra 54 in B3 (i giorni necessari) e la quarta mostra circa 55,71 in B8 (una potenza del 55,71%).
INV.NORM.S trasforma una probabilità in un punteggio z e DISTRIB.NORM.ST.N (con VERO come secondo argomento) trasforma un punteggio z in una probabilità. Per un test a una coda, elimina il «/2» dalla formula di z_α/2 in modo che diventi =INV.NORM.S(1-B3/100). ARROTONDA.PER.ECC(…;0) arrotonda per eccesso.
Come calcolarlo con Fogli Google
| CVR di base p1 (%) | 3 |
| Incremento relativo r (%) | 10 |
| CVR obiettivo p2 (%) | =B1*(1+B2/100) |
| CVR di base p1 (%) | 3 |
| CVR obiettivo p2 (%) | 3,3 |
| Livello di significatività α (%, due code) | 5 |
| Potenza 1−β (%) | 80 |
| z_α/2 | =INV.NORM.S(1-B3/100/2) |
| z_β | =INV.NORM.S(B4/100) |
| CVR medio p̄ | =(B1+B2)/2/100 |
| Numerosità per gruppo n (arrotondata per eccesso) | =ARROTONDA.PER.ECC((B5*RADQ(2*B7*(1-B7))+B6*RADQ(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Numerosità per gruppo n | 53211 |
| Visitatori giornalieri V (totale A + B) | 2000 |
| Giorni necessari D (arrotondati per eccesso) | =ARROTONDA.PER.ECC(2*B1/B2;0) |
| CVR di base p1 (%) | 3 |
| CVR obiettivo p2 (%) | 3,3 |
| Livello di significatività α (%, due code) | 5 |
| Numerosità per gruppo n | 30000 |
| z_α/2 | =INV.NORM.S(1-B3/100/2) |
| CVR medio p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ASS(B2-B1)/100*RADQ(B4)-B5*RADQ(2*B6*(1-B6)))/RADQ(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Potenza 1−β (%) | =DISTRIB.NORM.ST.N(B7;VERO)*100 |
Come calcolarlo con Python
from math import sqrt, ceil
from statistics import NormalDist

base_cvr = 3.0          # CVR di base (%)
relative_mde = 10.0     # MDE da rilevare (incremento relativo in %)
alpha = 0.05            # livello di significatività (due code)
power = 0.80            # potenza
daily_visits = 2000     # visitatori giornalieri (totale A + B)

p1 = base_cvr / 100
p2 = p1 * (1 + relative_mde / 100)          # CVR obiettivo
z_alpha = NormalDist().inv_cdf(1 - alpha / 2)  # per un test a una coda usa 1 - alpha
z_beta = NormalDist().inv_cdf(power)
p_bar = (p1 + p2) / 2

n_exact = (z_alpha * sqrt(2 * p_bar * (1 - p_bar))
           + z_beta * sqrt(p1 * (1 - p1) + p2 * (1 - p2))) ** 2 / (p2 - p1) ** 2
n_per_group = ceil(n_exact)                  # numerosità per gruppo (arrotondata per eccesso)
days = ceil(2 * n_per_group / daily_visits)  # giorni necessari

print(f"CVR obiettivo: {p2 * 100:.4g}%")
print(f"Numerosità per gruppo: {n_per_group} (totale {2 * n_per_group})")
print(f"Giorni necessari: {days}")

# Il calcolo inverso: la potenza con 30000 visitatori per gruppo
n_fixed = 30000
z_power = (abs(p2 - p1) * sqrt(n_fixed) - z_alpha * sqrt(2 * p_bar * (1 - p_bar))) \
          / sqrt(p1 * (1 - p1) + p2 * (1 - p2))
print(f"Potenza con {n_fixed} per gruppo: {NormalDist().cdf(z_power) * 100:.2f}%")
La formula in LaTeX e in altre notazioni matematiche (da copiare)
p₂ = p₁ × (1 + r/100)
p_2 = p_1 \left(1 + \dfrac{r}{100}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>p</mi><mn>2</mn></msub>
    <mo>=</mo>
    <msub><mi>p</mi><mn>1</mn></msub>
    <mo>(</mo><mn>1</mn><mo>+</mo><mfrac><mi>r</mi><mn>100</mn></mfrac><mo>)</mo>
  </mrow>
</math>
p_2 = p_1 (1 + r/100)
p1*(1 + r/100)
p2 := p1*(1 + r/100);
p2 = p1*(1 + r/100);
p_2 = p_1 (1 + r/100)
n = (z_α/2 √(2p̄(1 − p̄)) + z_β √(p₁(1 − p₁) + p₂(1 − p₂)))² ÷ (p₂ − p₁)²
n = \dfrac{\left( z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})} + z_{\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2 - p_1)^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msup>
<mrow>
<mo>(</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
<mo>+</mo>
<msub><mi>z</mi><mi>β</mi></msub>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
<mo>)</mo>
</mrow>
<mn>2</mn>
</msup>
<msup>
<mrow><mo>(</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mfrac>
</mrow>
</math>
n = (z_(alpha/2) sqrt(2 bar p (1 - bar p)) + z_beta sqrt(p_1(1 - p_1) + p_2(1 - p_2)))^2 / (p_2 - p_1)^2
Ceiling[(za*Sqrt[2*pbar*(1 - pbar)] + zb*Sqrt[p1*(1 - p1) + p2*(1 - p2)])^2/(p2 - p1)^2]
n := ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = (z_(α/2) √(2p̄(1 − p̄)) + z_β √(p_1(1 − p_1) + p_2(1 − p_2)))^2/(p_2 − p_1)^2
D = ⌈2n ÷ V⌉
D = \left\lceil \dfrac{2n}{V} \right\rceil
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>D</mi>
<mo>=</mo>
<mo>⌈</mo>
<mfrac><mrow><mn>2</mn><mi>n</mi></mrow><mi>V</mi></mfrac>
<mo>⌉</mo>
</mrow>
</math>
D = |~ (2n)/V ~|
Ceiling[2*n/v]
days := ceil(2*n/V);
D = ceil(2*n/V);
D = ⌈2n/V⌉
1 − β = Φ((|p₂ − p₁|√n − z_α/2 √(2p̄(1 − p̄))) ÷ √(p₁(1 − p₁) + p₂(1 − p₂)))
1 - \beta = \Phi\left( \dfrac{|p_2 - p_1|\sqrt{n} - z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})}}{\sqrt{p_1(1-p_1)+p_2(1-p_2)}} \right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mn>1</mn><mo>−</mo><mi>β</mi>
<mo>=</mo>
<mi>Φ</mi>
<mo>(</mo>
<mfrac>
<mrow>
<mo>|</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>|</mo>
<msqrt><mi>n</mi></msqrt>
<mo>−</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
</mrow>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
</mfrac>
<mo>)</mo>
</mrow>
</math>
1 - beta = Phi((|p_2 - p_1| sqrt(n) - z_(alpha/2) sqrt(2 bar p (1 - bar p))) / sqrt(p_1(1 - p_1) + p_2(1 - p_2)))
CDF[NormalDistribution[0, 1], (Abs[p2 - p1]*Sqrt[n] - za*Sqrt[2*pbar*(1 - pbar)])/Sqrt[p1*(1 - p1) + p2*(1 - p2)]]
power := Statistics[CDF](Normal(0, 1), (abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
power = normcdf((abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
1 − β = Φ((|p_2 − p_1| √n − z_(α/2) √(2p̄(1 − p̄)))/√(p_1(1 − p_1) + p_2(1 − p_2)))
Come chiedere a ChatGPT di fare il calcolo
Sei un assistente per la progettazione di test A/B. Fai il calcolo seguente eseguendo davvero del codice Python e basa la risposta solo sui numeri del risultato dell’esecuzione (non rispondere con calcoli a mente né a occhio).

Il CVR della pagina attuale (il CVR di base) è il 3%. Voglio poter rilevare un incremento relativo del 10% con la versione B (un CVR del 3,3%).
Con un livello di significatività del 5% (test a due code) e una potenza dell’80%, trova ognuno dei valori seguenti:
1. Il CVR obiettivo p2 (p2 = p1 × (1 + 10/100))
2. La numerosità per gruppo n (la formula del test z per due proporzioni: n = (z_{α/2}·√(2p̄(1−p̄)) + z_β·√(p1(1−p1)+p2(1−p2)))² ÷ (p2−p1)², con p̄ = (p1+p2)/2, arrotondata per eccesso) e la numerosità totale di A e B
3. I giorni necessari (arrotondati per eccesso) con 2000 visitatori giornalieri (A e B insieme)
4. La potenza se sono disponibili solo 30000 visitatori per gruppo (1−β = Φ((|p2−p1|·√n − z_{α/2}·√(2p̄(1−p̄))) ÷ √(p1(1−p1)+p2(1−p2))))

Usa statistics.NormalDist per i punteggi z e per la funzione di ripartizione, e mostra le formule che hai usato e i numeri del risultato dell’esecuzione.
Come si usa
-
1Inserisci i numeriScrivi nei campi i numeri con cui vuoi fare il calcolo
-
2CalcolaFai clic sul pulsante «Calcola»
-
3Guarda il risultatoIl risultato compare subito. Nella stessa pagina trovi anche lo svolgimento del calcolo e la spiegazione della formula
I punti di forza di DataChef

Nessuna competenza richiesta, semplice e intuitivo

Nessun dato personale richiesto

Il file viene eliminato automaticamente dopo il download


Nessun obbligo di attribuzione

Nessuna autorizzazione preventiva necessaria
Funzioni correlate
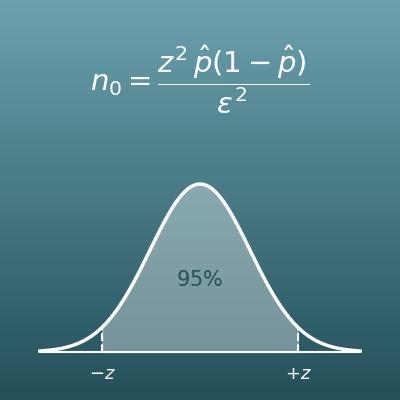
Calcolatrice della numerosità campionaria (sondaggi e margine di errore)
Calcola quante persone servono a un sondaggio dato il livello di confidenza, il margine di errore e la proporzione. Usala quando vuoi misurare con precisione una sola percentuale
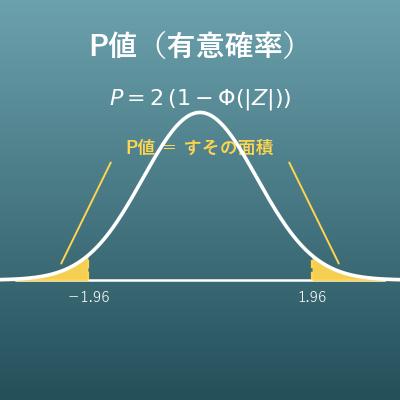
Calcolatrice p-value: dal punteggio z al p-value e viceversa
Ricava il p-value da un punteggio z e scopri quando usare un test a due code o a una coda. È l’altra faccia del livello di significatività α di questa pagina
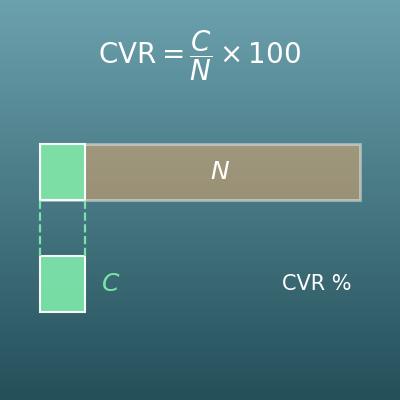
Calcolatrice del tasso di conversione (CVR, visite necessarie e conversioni previste)
Ricava visite, conversioni o tasso di conversione dagli altri due. Usala per trovare il CVR di base da inserire in questa pagina