



























































































Calcul de la taille d’échantillon d’un test A/B (MDE, seuil de signification, puissance et durée du test)
Pour trouver la taille d’échantillon, saisissez le taux de conversion de référence, le MDE, le seuil de signification et la puissance, puis appuyez sur « Calculer ». Vous obtenez la taille d’échantillon par groupe pour A et B (arrondie à l’entier supérieur) et le total, ainsi que le nombre de jours si vous saisissez vos visites quotidiennes. Passez « Valeur à trouver » sur la puissance pour fixer la taille d’échantillon par groupe et trouver plutôt la puissance 1 − β.
Table des matières
-
Ce que vous pouvez faire sur cette page
-
À quoi sert ce calcul ?
-
Mode d'emploi
-
Formules et figures
-
Formule du taux de conversion cible (celui que vous espérez pour la version B)
-
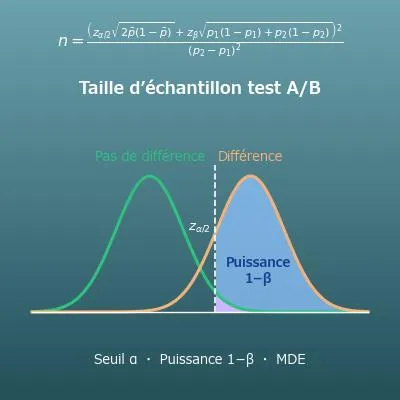
Formule de la taille d’échantillon par groupe (test z de comparaison de deux proportions)
-
Formule du nombre de jours nécessaires (à partir des visites quotidiennes)
-
Formule de la puissance (avec une taille d’échantillon par groupe fixée)
-
-
Symboles et termes
-
Ce qu’il est utile de savoir avant de commencer
-
Calculer avec Excel
-
Calculer avec Google Sheets
-
Calculer avec Python
-
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
-
Faire faire le calcul par ChatGPT
-
Les atouts de DataChef
-
Fonctions connexes
-
Liste des calculatrices NumberChef
Ce que vous pouvez faire sur cette page
- Saisissez le taux de conversion de référence (celui de votre version A actuelle), l’effet minimal détectable (MDE, en % relatif ou en points de pourcentage), le seuil de signification \(\alpha\) (bilatéral ou unilatéral) et la puissance \(1-\beta\). Vous obtenez la taille d’échantillon nécessaire pour chaque groupe de votre test A/B (arrondie à l’entier supérieur) et le total
- « Ma page convertit à 3 %. Combien de visiteurs faut-il à A et à B pour détecter une hausse de 10 % (de 3 % à 3,3 %) ? » Cette page répond à la question la plus importante à se poser avant de lancer un test
- Saisissez vos visites quotidiennes (facultatif) pour savoir aussi combien de jours il faut pour atteindre cette taille d’échantillon (arrondi à l’entier supérieur)
- Si vous ne pouvez obtenir qu’un nombre fixe de visiteurs par groupe, fixez la taille d’échantillon et trouvez la puissance \(1-\beta\) (la probabilité de trouver une différence quand il y en a vraiment une)
- Un graphique de l’évolution de la taille d’échantillon selon le MDE, une explication simple des formules et des formules à copier-coller pour Excel, Google Sheets et Python sont aussi sur cette page
À quoi sert ce calcul ?
Supposons que la fiche produit d’une boutique en ligne convertisse à 2 % et que vous vouliez détecter une hausse relative de 10 % (de 2 % à 2,2 %) grâce à un nouveau texte de bouton. Avec un seuil de signification de 5 % (bilatéral) et une puissance de 80 %, il faut environ 80 682 visiteurs par groupe, soit environ 161 364 au total.
Comparer quelques dizaines ou quelques centaines de visiteurs (« B a fait mieux la semaine dernière ») ne permet pas de distinguer un écart dû au hasard d’un écart réel. Calculer la taille d’échantillon avant de commencer évite de passer des semaines sur un test incapable de donner une réponse.
Une landing page obtient des demandes de démo avec un taux de conversion de 5 %. Pour détecter une hausse de 1 point (de 5 % à 6 %), il faut 8 158 visiteurs par groupe, 16 316 au total. À 300 visites par jour, cela fait \(16\,316 \div 300 \approx 54{,}4\), donc 55 jours, ou 8 semaines si vous voulez lisser les jours de la semaine.
Si l’on vous demande des résultats en 2 semaines, ce calcul vous permet d’expliquer avec des chiffres : « En 2 semaines (4 200 visiteurs, 2 100 par groupe), il nous faudrait un MDE bien plus grand, autour de 3 points (de 5 % à 8 %, ce qui demande 1 059 par groupe). »
Si votre newsletter a un taux d’ouverture de 20 % et que vous voulez détecter une hausse de 2 points (de 20 % à 22 %) grâce à un nouvel objet, il faut envoyer à 6 510 personnes par groupe, 13 020 au total (seuil de signification de 5 %, puissance de 80 %).
Un indicateur à taux élevé, comme un taux d’ouverture, demande moins de personnes pour montrer une différence qu’un taux de conversion de quelques pour cent. C’est parce que la partie \(p(1-p)\) de la formule est différente : les mêmes « 2 points » demandent une taille d’échantillon différente selon l’indicateur.
Supposons qu’un test visant une hausse relative de 10 % sur une page à 3 % de taux de conversion ait tourné avec 5 000 visiteurs par groupe et affiché « pas de différence significative ». Calculer la puissance donne seulement environ 13,5 %. Le test était organisé pour manquer une vraie amélioration plus de 8 fois sur 10.
La bonne conclusion n’est pas « ça n’a eu aucun effet » mais « cette taille d’échantillon ne permettait pas de le dire ». Calculer la puissance évite de mal lire un test et de jeter une bonne idée.
Une application a un taux de rétention à J+1 de 40 %. Pour détecter une hausse relative de 10 % (de 40 % à 44 %) grâce à un nouveau tutoriel, environ 2 389 nouveaux utilisateurs par groupe, soit environ 4 778 au total, suffisent (seuil de signification de 5 %, puissance de 80 %).
Un indicateur proche de 50 %, comme la rétention, a une grande dispersion, mais l’écart de taux (4 points) est grand lui aussi : les résultats arrivent plus vite que pour un test sur un taux de conversion de quelques pour cent. Estimer la taille d’échantillon pour chaque indicateur aide aussi à décider quelle amélioration traiter en premier.
Pour un test où passer à côté d’une bonne idée coûterait cher, comme un changement dans la présentation des prix, vous pouvez porter la puissance de 80 % à 90 %. Pour un taux de conversion de 3 % et une hausse relative de 10 %, la taille d’échantillon par groupe passe de 53 211 à 71 233 (environ 1,34 fois).
Ce calcul montre exactement combien de visiteurs en plus il faut pour diviser les oublis par deux (de 20 % à 10 %) : vous pouvez ainsi adapter la taille d’échantillon et la durée du test à l’importance du test.
Formules et figures
Symboles et termes
Symboles
| \(p_1\) | p un | Le taux de conversion de référence (celui de la version A actuelle). \(p\) signifie proportion ou probabilité. Dans les formules, 3 % s’écrit sous forme décimale, 0,03. |
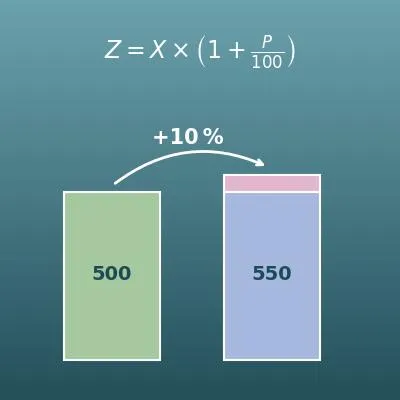
| \(p_2\) | p deux | Le taux de conversion cible (celui que vous espérez pour la version B). Il vaut \(p_1 (1 + r/100)\) en % relatif et \(p_1 + d\) en points de pourcentage. |
| \(\bar{p}\) | p barre | La moyenne des deux taux de conversion, \((p_1 + p_2) \div 2\). C’est le taux de conversion commun supposé quand il n’y a pas de différence. En statistique, la barre au-dessus signale une moyenne. |
| \(r\) | r | Le MDE exprimé en % relatif. La lettre vient de « ratio » (rapport) et indique de quel pourcentage le taux de conversion de référence s’améliore (de 3 % à 3,3 % donne \(r = 10\)). |
| \(d\) | d | Le MDE exprimé en points de pourcentage. La lettre vient de « différence » : c’est la simple différence de taux de conversion (de 3 % à 3,3 % donne \(d = 0{,}3\) point). |
| \(p_2 - p_1\) | p deux moins p un | L’écart à détecter, en points de pourcentage écrits sous forme décimale (0,3 point, c’est 0,003). La taille d’échantillon est divisée par son carré : plus l’écart est petit, plus la taille d’échantillon grandit vite. |
| \(\alpha\) | alpha | Le seuil de signification : la probabilité de conclure à une différence qui n’existe pas (la probabilité d’une erreur de première espèce). On prend généralement 5 % (0,05). Alpha est la première lettre grecque ; en statistique, on l’utilise pour la probabilité de l’erreur de « première » espèce. |
| \(\beta\) | bêta | La probabilité de passer à côté d’une différence qui existe vraiment (la probabilité d’une erreur de seconde espèce). Bêta est la deuxième lettre grecque, utilisée pour la probabilité de l’erreur de « seconde » espèce. |
| \(1-\beta\) | un moins bêta | La puissance : la probabilité de trouver une différence quand il y en a vraiment une. On prend généralement 80 % ou 90 %. |
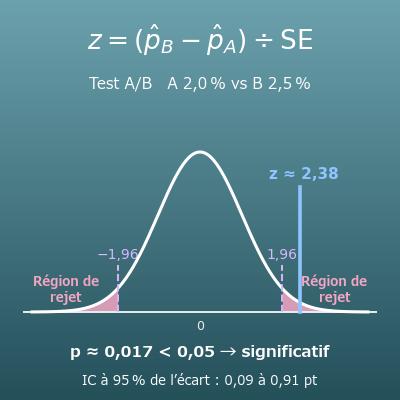
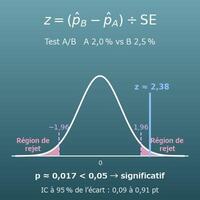
| \(z_{\alpha/2}\) | z indice alpha sur deux | La valeur z du seuil de signification \(\alpha\) dans un test bilatéral (le point au-dessus duquel se trouve \(\alpha/2\) de la loi normale centrée réduite). Elle vaut 1,9600 à 5 %, 2,5758 à 1 % et 1,6449 à 10 %. Un test unilatéral utilise plutôt \(z_{\alpha}\) (1,6449 à 5 %). |
| \(z_{\beta}\) | z indice bêta | La valeur z de la puissance \(1-\beta\) (le point en dessous duquel se trouve la probabilité \(1-\beta\) de la loi normale centrée réduite). Elle vaut 0,8416 à 80 % et 1,2816 à 90 %. |
| \(z_{1-\beta}\) | z indice un moins bêta | Dans la formule de la puissance, la valeur z obtenue à partir de la taille d’échantillon. Placez-la dans \(\Phi\) et vous obtenez la puissance. (C’est la même chose que \(z_{\beta}\), écrite du côté de la valeur que l’on cherche.) |
| \(\Phi\) | phi majuscule | La fonction de répartition de la loi normale centrée réduite. Elle donne la probabilité qu’une valeur z soit inférieure ou égale à une valeur donnée : \(\Phi(1{,}96) \approx 0{,}975\) et \(\Phi(0{,}8416) \approx 0{,}80\). La lettre grecque phi majuscule est le symbole habituel de cette fonction. |
| \(n\) | n | La taille d’échantillon par groupe (pour chacune des versions A et B). La lettre vient de « nombre ». Le total pour A et B vaut \(2n\). |
| \(\sqrt{\ \ }\) | racine carrée | La racine carrée : le nombre positif qui, élevé au carré, redonne le nombre sous la racine, par exemple \(\sqrt{30\,000} \approx 173{,}205\). Elle apparaît quand on calcule la dispersion (l’écart-type) d’un taux de conversion. |
| \(V\) | v | Les visites quotidiennes (toutes les visites de la page testée, A et B ensemble). La lettre vient de « visites ». |
| \(D\) | d | Les jours nécessaires. La lettre vient de « durée » (days, jours en anglais). |
| \(\lceil\ \rceil\) | partie entière supérieure | Le symbole de l’arrondi à l’entier supérieur (la fonction plafond). Il donne le plus petit entier supérieur ou égal au nombre à l’intérieur (\(\lceil 53{,}211 \rceil = 54\)). |
Termes
| test A/B | Une expérience qui répartit de façon aléatoire les visiteurs entre la version actuelle (A) et une nouvelle version (B) sur la même période, pour voir laquelle fonctionne le mieux (par exemple, laquelle a le taux de conversion le plus élevé). On l’utilise pour vérifier avec des données, et non au feeling, si un changement comme la couleur d’un bouton, un titre, la présentation d’un prix ou la mise en page d’une landing page aide vraiment. |
| CVR (taux de conversion) | La part des visiteurs ou des clics qui aboutissent à une action visée (une conversion), comme un achat ou une inscription. Dans les formules de cette page, le taux de conversion de la version A est \(p_1\) et celui de la version B \(p_2\). |
| MDE (effet minimal détectable) | La plus petite hausse que vous voulez pouvoir détecter. C’est la première valeur à fixer quand on prépare un test A/B. Plus il est petit, plus la taille d’échantillon grandit vite (elle est inversement proportionnelle au carré de l’écart) : choisissez la plus petite hausse qui compterait pour votre activité. |
| seuil de signification | La probabilité \(\alpha\) de l’erreur que vous acceptez : voir un écart dû au hasard et conclure à une différence qui n’existe pas. 5 % est l’usage, ce qui admet une fausse alerte environ 1 fois sur 20. Un seuil plus strict (1 %) demande une taille d’échantillon plus grande. |
| puissance statistique | La probabilité \(1-\beta\) de trouver une différence quand il y en a vraiment une. 80 % est l’usage, ce qui accepte de manquer une vraie hausse environ 1 fois sur 5. Si un test de faible puissance dit « pas de différence », ce n’est pas une preuve qu’il n’y a pas de différence. |
| erreur de première espèce | L’erreur qui consiste à conclure à une différence qui n’existe pas (un faux positif). La probabilité admise pour elle est le seuil de signification \(\alpha\). C’est le revers de l’erreur de seconde espèce (un oubli) : réduire l’une tend à augmenter l’autre. Le moyen le plus simple de réduire les deux est une taille d’échantillon plus grande. |
| erreur de seconde espèce | L’erreur qui consiste à passer à côté d’une différence qui existe vraiment (un faux négatif). Sa probabilité est \(\beta\), et \(1-\beta\) est la puissance. C’est le revers de l’erreur de première espèce (une fausse alerte) : réduire l’une tend à augmenter l’autre. Le moyen le plus simple de réduire les deux est une taille d’échantillon plus grande. |
| hypothèse nulle | L’hypothèse « les versions A et B ont le même taux de conversion », que le test cherche à rejeter. Le test se demande à quel point les données seraient inhabituelles si l’hypothèse nulle était vraie. Si elles le sont assez, l’hypothèse nulle est rejetée et le résultat est « une différence ». |
| hypothèse alternative | L’hypothèse « les versions A et B ont des taux de conversion différents », que le test cherche à montrer. Elle est retenue quand l’hypothèse nulle (pas de différence) est rejetée. |
| test bilatéral | Un test qui compte comme une différence aussi bien « B est plus élevé » que « B est plus bas ». On l’utilise pour un test A/B ordinaire, où l’on ne sait pas dans quel sens le résultat ira. Il demande une taille d’échantillon plus grande qu’un test unilatéral, mais il repère aussi une dégradation de B. |
| test unilatéral | Un test qui ne cherche que « B est plus élevé ». Il demande une taille d’échantillon plus petite qu’un test bilatéral, mais ne peut pas repérer une dégradation de B : il faut donc le choisir avant le début du test. (Passer à l’unilatéral après avoir vu les résultats n’est pas valable.) |
| test z de comparaison de deux proportions | Un test qui vérifie si deux groupes diffèrent par une proportion (comme le taux de conversion), à l’aide d’une valeur z (l’écart standardisé) et de la loi normale centrée réduite. Les formules de cette page trouvent la taille d’échantillon de ce test. L’approximation normale fonctionne quand chaque groupe a assez de conversions (en règle générale, au moins 5 à 10). |
| loi normale centrée réduite | La loi normale de moyenne 0 et d’écart-type 1 (une courbe en cloche symétrique). Une valeur z est un point de son axe horizontal, et chaque valeur z correspond à une probabilité, comme dans « l’aire à droite de 1,96 vaut 2,5 % ». |
| fonction de répartition | Une fonction qui donne la probabilité d’obtenir une valeur donnée ou moins. Celle de la loi normale centrée réduite s’écrit \(\Phi\) et apparaît à la fin de la formule de la puissance. Dans Excel, c’est LOI.NORMALE.STANDARD.N (avec VRAI en second argument), et en Python NormalDist().cdf. |
| écart-type (dispersion) | L’ampleur de la dispersion des données. La dispersion d’une proportion \(p\) est proportionnelle à \(\sqrt{p(1-p)}\). Les \(\sqrt{2\bar{p}(1-\bar{p})}\) et \(\sqrt{p_1(1-p_1)+p_2(1-p_2)}\) des formules sont la dispersion de l’écart entre les taux de conversion des deux groupes. |
| comparaisons multiples | Comparer plusieurs versions B ou plusieurs indicateurs en même temps. Plus on fait de comparaisons, plus il est probable qu’au moins une paraisse significative par hasard : il faut donc un ajustement, comme diviser le seuil de signification par le nombre de comparaisons (la correction de Bonferroni). |
| peeking (arrêt anticipé) | Regarder les résultats encore et encore avant d’avoir atteint la taille d’échantillon nécessaire et arrêter le test dès que le résultat semble significatif. Les écarts dus au hasard sont alors faciles à attraper : un test censé avoir un seuil de signification de 5 % se trompe en réalité bien plus souvent. Les formules de cette page supposent que vous fixez d’abord la taille d’échantillon et attendez de l’atteindre. |
Ce qu’il est utile de savoir avant de commencer
Ce qu’il est utile de savoir pour utiliser le calcul de cette page en comprenant ce qu’il fait, et pas seulement en appuyant sur le bouton.
Si vous bloquez, revenir sur ces notions est le chemin le plus court.
| Pourcentages (CM2-6e, 10-12 ans) |
|
| Racines carrées (4e-3e, 13-15 ans) |
|
| Probabilités de base (5e-3e, 12-15 ans) |
|
| La loi normale et les scores z (terminale et études supérieures, 17 ans et plus) |
|
| Le principe des tests d’hypothèse (études supérieures, 18 ans et plus) |
|
| Arrondir à l’entier supérieur (CM1-CM2, 9-11 ans) |
|
Calculer avec Excel
| Taux de conversion de référence p1 (%) | 3 |
| Hausse relative r (%) | 10 |
| Taux de conversion cible p2 (%) | =B1*(1+B2/100) |
| Taux de conversion de référence p1 (%) | 3 |
| Taux de conversion cible p2 (%) | 3,3 |
| Seuil de signification α (%, bilatéral) | 5 |
| Puissance 1−β (%) | 80 |
| z_α/2 | =LOI.NORMALE.STANDARD.INVERSE.N(1-B3/100/2) |
| z_β | =LOI.NORMALE.STANDARD.INVERSE.N(B4/100) |
| Taux de conversion moyen p̄ | =(B1+B2)/2/100 |
| Taille par groupe n (arrondi supérieur) | =ARRONDI.SUP((B5*RACINE(2*B7*(1-B7))+B6*RACINE(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Taille par groupe n | 53211 |
| Visites quotidiennes V (total A + B) | 2000 |
| Jours nécessaires D (arrondi supérieur) | =ARRONDI.SUP(2*B1/B2;0) |
| Taux de conversion de référence p1 (%) | 3 |
| Taux de conversion cible p2 (%) | 3,3 |
| Seuil de signification α (%, bilatéral) | 5 |
| Taille par groupe n | 30000 |
| z_α/2 | =LOI.NORMALE.STANDARD.INVERSE.N(1-B3/100/2) |
| Taux de conversion moyen p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*RACINE(B4)-B5*RACINE(2*B6*(1-B6)))/RACINE(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Puissance 1−β (%) | =LOI.NORMALE.STANDARD.N(B7;VRAI)*100 |
Le premier tableau affiche 3,3 en B3 (un taux de conversion cible de 3,3 %), le deuxième 53211 en B8 (la taille d’échantillon par groupe), le troisième 54 en B3 (les jours nécessaires) et le quatrième environ 55,71 en B8 (une puissance de 55,71 %).
LOI.NORMALE.STANDARD.INVERSE.N convertit une probabilité en valeur z, et LOI.NORMALE.STANDARD.N (avec VRAI en second argument) convertit une valeur z en probabilité. Pour un test unilatéral, supprimez le « /2 » de la formule de z_α/2 pour obtenir =LOI.NORMALE.STANDARD.INVERSE.N(1-B3/100). ARRONDI.SUP(…;0) arrondit à l’entier supérieur.
Calculer avec Google Sheets
| Taux de conversion de référence p1 (%) | 3 |
| Hausse relative r (%) | 10 |
| Taux de conversion cible p2 (%) | =B1*(1+B2/100) |
| Taux de conversion de référence p1 (%) | 3 |
| Taux de conversion cible p2 (%) | 3,3 |
| Seuil de signification α (%, bilatéral) | 5 |
| Puissance 1−β (%) | 80 |
| z_α/2 | =LOI.NORMALE.STANDARD.INVERSE.N(1-B3/100/2) |
| z_β | =LOI.NORMALE.STANDARD.INVERSE.N(B4/100) |
| Taux de conversion moyen p̄ | =(B1+B2)/2/100 |
| Taille par groupe n (arrondi supérieur) | =ARRONDI.SUP((B5*RACINE(2*B7*(1-B7))+B6*RACINE(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Taille par groupe n | 53211 |
| Visites quotidiennes V (total A + B) | 2000 |
| Jours nécessaires D (arrondi supérieur) | =ARRONDI.SUP(2*B1/B2;0) |
| Taux de conversion de référence p1 (%) | 3 |
| Taux de conversion cible p2 (%) | 3,3 |
| Seuil de signification α (%, bilatéral) | 5 |
| Taille par groupe n | 30000 |
| z_α/2 | =LOI.NORMALE.STANDARD.INVERSE.N(1-B3/100/2) |
| Taux de conversion moyen p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*RACINE(B4)-B5*RACINE(2*B6*(1-B6)))/RACINE(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Puissance 1−β (%) | =LOI.NORMALE.STANDARD.N(B7;VRAI)*100 |
Calculer avec Python
from math import sqrt, ceil
from statistics import NormalDist

base_cvr = 3.0          # taux de conversion de référence (%)
relative_mde = 10.0     # MDE à détecter (% relatif)
alpha = 0.05            # seuil de signification (bilatéral)
power = 0.80            # puissance
daily_visits = 2000     # visites quotidiennes (total A + B)

p1 = base_cvr / 100
p2 = p1 * (1 + relative_mde / 100)          # taux de conversion cible
z_alpha = NormalDist().inv_cdf(1 - alpha / 2)  # pour un test unilatéral, utiliser 1 - alpha
z_beta = NormalDist().inv_cdf(power)
p_bar = (p1 + p2) / 2

n_exact = (z_alpha * sqrt(2 * p_bar * (1 - p_bar))
           + z_beta * sqrt(p1 * (1 - p1) + p2 * (1 - p2))) ** 2 / (p2 - p1) ** 2
n_per_group = ceil(n_exact)                  # taille par groupe (arrondi supérieur)
days = ceil(2 * n_per_group / daily_visits)  # jours nécessaires

print(f"Taux de conversion cible : {p2 * 100:.4g} %")
print(f"Taille d'échantillon par groupe : {n_per_group} (total {2 * n_per_group})")
print(f"Jours nécessaires : {days}")

# Dans l'autre sens : puissance avec 30 000 visiteurs par groupe
n_fixed = 30000
z_power = (abs(p2 - p1) * sqrt(n_fixed) - z_alpha * sqrt(2 * p_bar * (1 - p_bar))) \
          / sqrt(p1 * (1 - p1) + p2 * (1 - p2))
print(f"Puissance avec {n_fixed} par groupe : {NormalDist().cdf(z_power) * 100:.2f} %")
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
p₂ = p₁ × (1 + r/100)
p_2 = p_1 \left(1 + \dfrac{r}{100}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>p</mi><mn>2</mn></msub>
    <mo>=</mo>
    <msub><mi>p</mi><mn>1</mn></msub>
    <mo>(</mo><mn>1</mn><mo>+</mo><mfrac><mi>r</mi><mn>100</mn></mfrac><mo>)</mo>
  </mrow>
</math>
p_2 = p_1 (1 + r/100)
p1*(1 + r/100)
p2 := p1*(1 + r/100);
p2 = p1*(1 + r/100);
p_2 = p_1 (1 + r/100)
n = (z_α/2 √(2p̄(1 − p̄)) + z_β √(p₁(1 − p₁) + p₂(1 − p₂)))² ÷ (p₂ − p₁)²
n = \dfrac{\left( z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})} + z_{\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2 - p_1)^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msup>
<mrow>
<mo>(</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
<mo>+</mo>
<msub><mi>z</mi><mi>β</mi></msub>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
<mo>)</mo>
</mrow>
<mn>2</mn>
</msup>
<msup>
<mrow><mo>(</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mfrac>
</mrow>
</math>
n = (z_(alpha/2) sqrt(2 bar p (1 - bar p)) + z_beta sqrt(p_1(1 - p_1) + p_2(1 - p_2)))^2 / (p_2 - p_1)^2
Ceiling[(za*Sqrt[2*pbar*(1 - pbar)] + zb*Sqrt[p1*(1 - p1) + p2*(1 - p2)])^2/(p2 - p1)^2]
n := ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = (z_(α/2) √(2p̄(1 − p̄)) + z_β √(p_1(1 − p_1) + p_2(1 − p_2)))^2/(p_2 − p_1)^2
D = ⌈2n ÷ V⌉
D = \left\lceil \dfrac{2n}{V} \right\rceil
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>D</mi>
<mo>=</mo>
<mo>⌈</mo>
<mfrac><mrow><mn>2</mn><mi>n</mi></mrow><mi>V</mi></mfrac>
<mo>⌉</mo>
</mrow>
</math>
D = |~ (2n)/V ~|
Ceiling[2*n/v]
days := ceil(2*n/V);
D = ceil(2*n/V);
D = ⌈2n/V⌉
1 − β = Φ((|p₂ − p₁|√n − z_α/2 √(2p̄(1 − p̄))) ÷ √(p₁(1 − p₁) + p₂(1 − p₂)))
1 - \beta = \Phi\left( \dfrac{|p_2 - p_1|\sqrt{n} - z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})}}{\sqrt{p_1(1-p_1)+p_2(1-p_2)}} \right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mn>1</mn><mo>−</mo><mi>β</mi>
<mo>=</mo>
<mi>Φ</mi>
<mo>(</mo>
<mfrac>
<mrow>
<mo>|</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>|</mo>
<msqrt><mi>n</mi></msqrt>
<mo>−</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
</mrow>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
</mfrac>
<mo>)</mo>
</mrow>
</math>
1 - beta = Phi((|p_2 - p_1| sqrt(n) - z_(alpha/2) sqrt(2 bar p (1 - bar p))) / sqrt(p_1(1 - p_1) + p_2(1 - p_2)))
CDF[NormalDistribution[0, 1], (Abs[p2 - p1]*Sqrt[n] - za*Sqrt[2*pbar*(1 - pbar)])/Sqrt[p1*(1 - p1) + p2*(1 - p2)]]
power := Statistics[CDF](Normal(0, 1), (abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
power = normcdf((abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
1 − β = Φ((|p_2 − p_1| √n − z_(α/2) √(2p̄(1 − p̄)))/√(p_1(1 − p_1) + p_2(1 − p_2)))
Faire faire le calcul par ChatGPT
Tu es un assistant pour la préparation de tests A/B. Fais le calcul suivant en exécutant réellement du code Python, et appuie ta réponse uniquement sur les nombres obtenus à l’exécution (ne réponds pas de tête ni au jugé).

Le taux de conversion de la page actuelle (taux de référence) est de 3 %. Je veux pouvoir détecter une hausse relative de 10 % avec la version B (un taux de conversion de 3,3 %).
Avec un seuil de signification de 5 % (test bilatéral) et une puissance de 80 %, calcule chacun des points suivants :
1. Le taux de conversion cible p2 (p2 = p1 × (1 + 10/100))
2. La taille d’échantillon par groupe n (formule du test z de comparaison de deux proportions : n = (z_{α/2}·√(2p̄(1−p̄)) + z_β·√(p1(1−p1)+p2(1−p2)))² ÷ (p2−p1)², avec p̄ = (p1+p2)/2, arrondie à l’entier supérieur) et la taille d’échantillon totale pour A et B
3. Le nombre de jours nécessaires (arrondi à l’entier supérieur) avec 2 000 visites par jour (A et B ensemble)
4. La puissance si seulement 30 000 visiteurs par groupe sont disponibles (1−β = Φ((|p2−p1|·√n − z_{α/2}·√(2p̄(1−p̄))) ÷ √(p1(1−p1)+p2(1−p2))))

Utilise statistics.NormalDist pour les valeurs z et la fonction de répartition, et montre les formules utilisées et les nombres obtenus à l’exécution.
Mode d'emploi
-
1Saisissez vos nombresTapez les nombres à calculer dans les champs de saisie
-
2CalculezAppuyez sur le bouton « Calculer »
-
3Lisez le résultatLe résultat s’affiche aussitôt. La même page explique aussi le raisonnement et la formule
Les atouts de DataChef

Aucune compétence requise – simple et intuitif

Aucune donnée personnelle nécessaire

Le fichier est supprimé automatiquement après le téléchargement


Aucune mention de crédit nécessaire

Aucune autorisation préalable nécessaire
Fonctions connexes
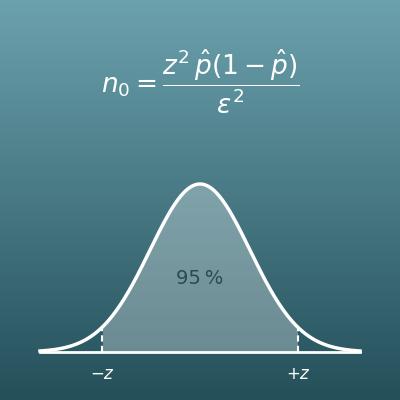
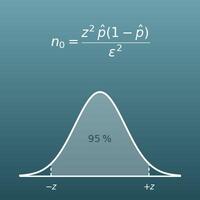
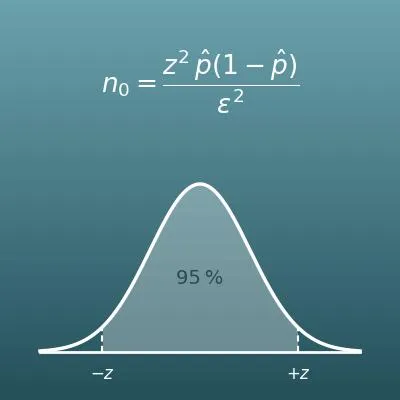
Calcul de la taille d’échantillon (sondage et marge d’erreur)
Trouve le nombre de personnes nécessaires à un sondage à partir du niveau de confiance, de la marge d’erreur et de la proportion. Pour mesurer précisément un seul pourcentage
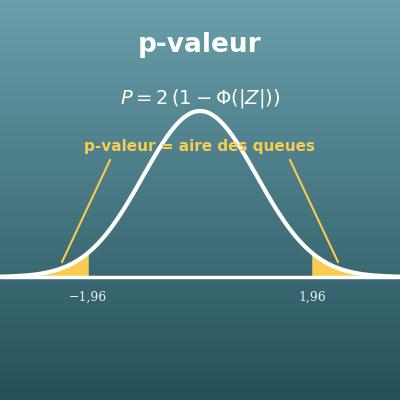
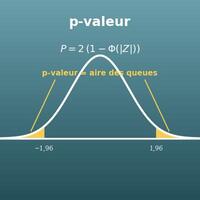
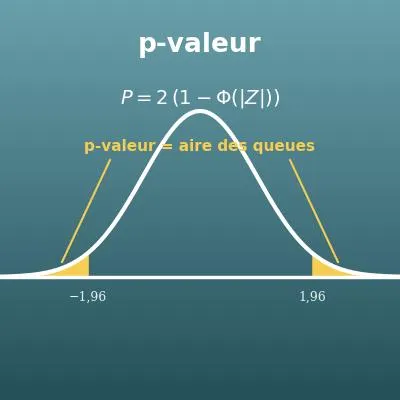
Calcul de la p-valeur : de Z à la p-valeur et inversement
Trouve la p-valeur à partir d’un Z et explique quand utiliser un test bilatéral ou unilatéral. C’est l’autre face du seuil de signification α de cette page
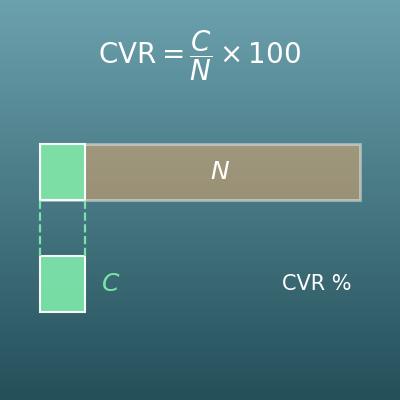
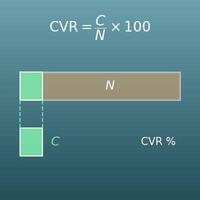
Calcul du taux de conversion (visites nécessaires et conversions attendues)
Trouve les visites, les conversions ou le taux de conversion à partir des deux autres. Pour obtenir le taux de conversion de référence à saisir sur cette page