



























































































Saisissez la moyenne, l’écart-type, puis les bornes inférieure et supérieure de l’intervalle qui vous intéresse. Le calculateur donne la probabilité de tomber dans cet intervalle et un tableau d’intervalles de confiance.
Table des matières
-
Ce que vous pouvez faire sur cette page
-
À quoi sert ce calcul ?
-
Mode d'emploi
-
Formule et graphique
-
Symboles et termes
-
Ce qu’il est utile de savoir avant de commencer
-
Calculer avec Excel
-
Calculer avec Google Sheets
-
Calculer avec Python
-
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
-
Faire faire le calcul par ChatGPT
-
Les atouts de DataChef
-
Fonctions connexes
-
Liste des calculatrices NumberChef
Ce que vous pouvez faire sur cette page
- Entrez la moyenne \(\mu\) et la dispersion (l’écart-type \(\sigma\)) et obtenez tout de suite la probabilité qu’une valeur tombe dans un intervalle donné
- La probabilité d’être au-dessus (ou en dessous) d’une valeur, comme « quel pourcentage des candidats a eu 80 ou plus ? », est aussi calculée
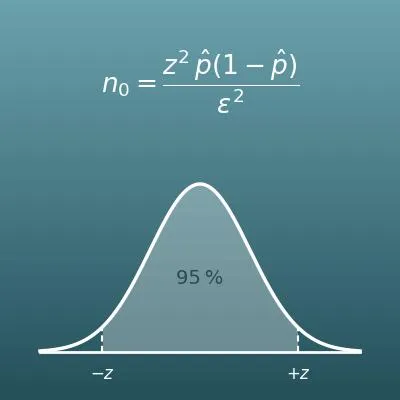
- Un tableau des intervalles courants en statistique (celui qui contient 95 % de l’ensemble, par exemple) s’affiche en même temps
- Une explication simple de la loi normale et des formules à copier-coller pour Excel, Google Sheets et Python sont réunies sur cette page
À quoi sert ce calcul ?
Le QI est construit pour que la moyenne soit 100 et qu’un écart-type vaille 15 points. Pour une loi normale, seulement environ 16 % des personnes sont à \(+1\sigma\) ou plus (un QI de 115 ou plus), et environ 2,3 % à \(+2\sigma\) ou plus (130 ou plus).
Une fois ce lien compris, les rangs en percentile des tests ne sont plus un mystère : vous lisez en chiffres, et non au jugé, ce que représentent « 10 points de plus » ou « le 90e percentile ».
Les « valeurs de référence » d’une prise de sang ou d’autres analyses sont souvent fixées comme l’intervalle qui contient les 95 % du milieu des mesures de personnes en bonne santé (environ la moyenne \(\pm 2\sigma\)).
Pour chaque paramètre, environ 5 % des personnes en bonne santé (1 sur 20) sont donc en dehors des valeurs de référence. Sur un bilan avec beaucoup de paramètres, il est même courant qu’une personne en bonne santé soit signalée sur au moins l’un d’eux. En le sachant, vous comprenez que « légèrement en dehors » ne veut pas forcément dire « il y a un problème », et vous écoutez calmement les explications de votre médecin. Utile surtout si les résultats d’analyses ont tendance à vous inquiéter.
Les masses et les dimensions des produits varient de façon proche d’une loi normale. Par exemple, avec un contenu moyen de 102 g, un écart-type de 1 g et une limite basse de 100 g, les paquets en dessous de la limite sont ceux au-delà de \(-2\sigma\) : environ 2,3 %.
Les usines utilisent ce calcul pour prévoir le taux de défauts et décider où régler le remplissage moyen (combien en mettre en plus) pour équilibrer les réclamations et le coût.
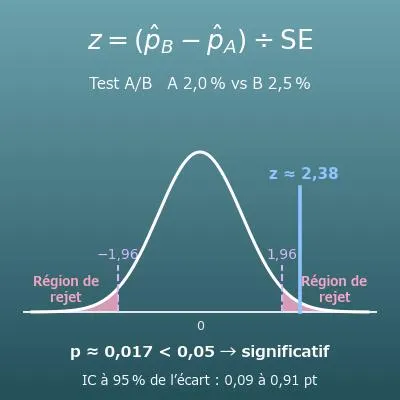
Pour comparer les taux de clic du design A et du design B, on utilise la loi normale (un intervalle de confiance) pour savoir si la différence relève du hasard ou si elle est réelle.
La ligne « 0,95 » du tableau affiché dans le résultat correspond justement à l’« intervalle de confiance à 95 % », le plus utilisé en pratique. Ce calcul sert tous les jours derrière des décisions qui engagent de grosses sommes, comme les budgets publicitaires.
Les actuaires estiment en probabilités le risque d’avoir à indemniser et fixent les primes d’assurance à partir de là.
On ne peut pas prévoir chaque sinistre, mais le total sur un grand nombre d’assurés se rapproche d’une loi normale (le théorème central limite) : le montant total des indemnités se prévoit donc avec une précision étonnante. C’est grâce à ces mathématiques qu’on peut être bien couvert pour une prime raisonnable.
Formule et graphique
Symboles et termes
Symboles
| \(\mu\) | mu | La moyenne. C’est la position du centre du pic de la courbe. Une lettre grecque qui correspond au m latin. |
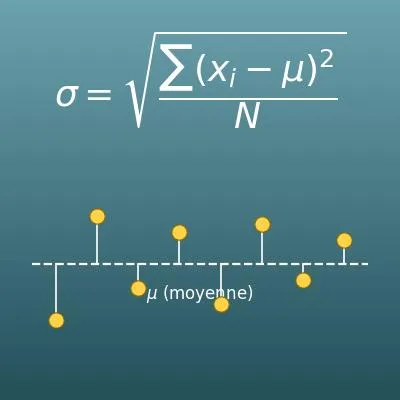
| \(\sigma\) | sigma | L’écart-type. C’est la taille de la dispersion des données, qui fixe la largeur du pic. Plus il est grand, plus le pic est bas et large. Une lettre grecque qui correspond au s latin. |
| \(X\) | X (variable aléatoire) | Une lettre pour une grandeur dont la valeur peut changer à chaque mesure, comme une note d’examen ou une taille. |
| \(\Phi\) | phi majuscule | La fonction de répartition de la loi normale centrée réduite (moyenne 0, écart-type 1). Elle donne la probabilité d’obtenir cette valeur ou moins. |
| \(z\) | z (score z) | Un nombre qui indique à combien d’écarts-types une valeur se trouve de la moyenne. On l’obtient par \(z = (x - \mu) \div \sigma\). |
| \(e\) | e (nombre d’Euler) | Une constante, environ 2,71828…, base du logarithme népérien. C’est un nombre particulier au cœur de la fonction exponentielle. |
| \(\pi\) | pi | Une constante, environ 3,14159…, le rapport entre le périmètre d’un cercle et son diamètre. Dans la formule de la loi normale, elle apparaît pour que l’aire totale sous la courbe vaille exactement 1. |
Termes
| loi normale | Une loi de probabilité dont la courbe est en cloche, symétrique autour de la moyenne (on dit aussi loi de Gauss). Elle sert de modèle pour des données où les valeurs proches de la moyenne sont les plus fréquentes et deviennent plus rares à mesure qu’on s’en éloigne, comme les tailles, les notes d’examen ou les masses de produits. |
| écart-type | Un seul nombre qui mesure la dispersion des données. Deux séries peuvent avoir la même moyenne mais des dispersions différentes. Plus l’écart-type est grand, plus le pic de la courbe est bas et large. |
| centrer-réduire | Réécrire une valeur en « nombre d’écarts-types qui la séparent de la moyenne » (le score z), c’est-à-dire lui retirer la moyenne puis diviser par l’écart-type. Toute loi normale, une fois centrée et réduite, se ramène à la seule loi normale centrée réduite, de moyenne 0 et d’écart-type 1. Le QI utilise la même idée : QI \(= 100 + 15 \times z\). |
| fonction de répartition | La fonction qui donne la probabilité d’obtenir une valeur inférieure ou égale à celle-ci. Pour la loi normale centrée réduite, on la note \(\Phi\) (phi). La probabilité d’un intervalle, c’est « \(\Phi\) jusqu’à la borne supérieure » moins « \(\Phi\) jusqu’à la borne inférieure ». |
| densité de probabilité | La formule de la courbe elle-même (fonction de densité). La hauteur de la courbe n’est pas une probabilité mais une densité de probabilité : c’est l’aire entre la courbe et l’axe horizontal sur un intervalle qui donne la probabilité. Pour la loi normale, c’est une courbe en cloche. |
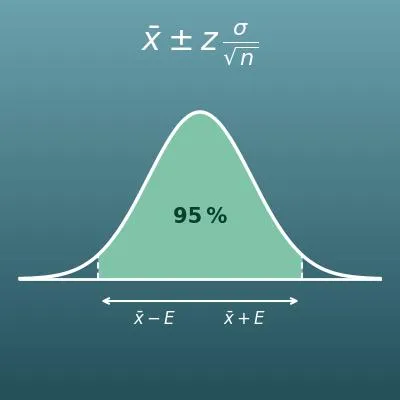
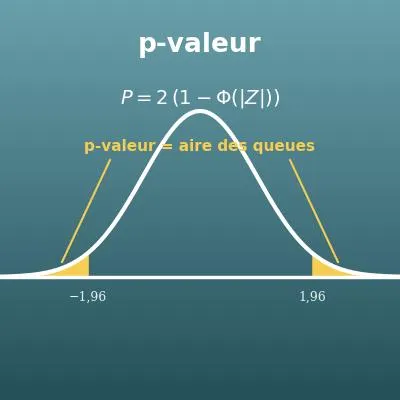
| intervalle de confiance | Le tableau affiché dans le résultat donne, pour chaque pourcentage, l’intervalle centré sur la moyenne qui contient cette part de l’ensemble (\(\mu \pm z \times \sigma\)) et son coefficient \(z\). À proprement parler, un « intervalle de confiance à 95 % » en statistique est un intervalle pour la vraie valeur (la moyenne de la population, par exemple) estimé à partir d’un échantillon. Mais quand on suppose une loi normale, il utilise le même \(z\) (1,96 pour 95 %) : les valeurs de \(z\) de ce tableau s’appliquent directement. On s’en sert souvent pour la « marge d’erreur » des sondages et des résultats de mesures. |
| règle des 68-95-99,7 | Un repère pratique à retenir : pour une loi normale, environ 68,3 % des données se trouvent dans l’intervalle moyenne \(\pm 1\sigma\), environ 95,4 % dans \(\pm 2\sigma\) et environ 99,7 % dans \(\pm 3\sigma\). |
| théorème central limite | Le résultat mathématique selon lequel une grandeur formée par l’accumulation de nombreux petits effets aléatoires (une somme ou une moyenne) se rapproche d’une loi normale, quelle que soit la loi de départ. C’est la raison pour laquelle tant de données réelles sont proches d’une loi normale. |
Ce qu’il est utile de savoir avant de commencer
Voici ce qui vous aide à utiliser le calcul de cette page en le comprenant vraiment, et pas seulement en appuyant sur le bouton.
| La moyenne (5e, 12-13 ans) |
|
| Statistiques et écart-type (2de, 15-16 ans) |
|
| Lire des proportions comme des aires (5e-4e, 12-14 ans) |
|
| Loi normale et score z (lycée ou études supérieures, 17 ans et plus) |
|
Calculer avec Excel
| Moyenne μ | 62 |
| Écart-type σ | 14 |
| Borne inférieure | 50 |
| Borne supérieure | 80 |
| Probabilité entre les bornes | =LOI.NORMALE.N(B4;B1;B2;VRAI)-LOI.NORMALE.N(B3;B1;B2;VRAI) |
| Moyenne μ | 62 |
| Écart-type σ | 14 |
| Valeur (part au-dessus de celle-ci) | 80 |
| Probabilité de cette valeur ou plus | =1-LOI.NORMALE.N(B3;B1;B2;VRAI) |
| Moyenne μ | 62 |
| Écart-type σ | 14 |
| Point x | 80 |
| Hauteur de la courbe en ce point | =LOI.NORMALE.N(B3;B1;B2;FAUX) |
La probabilité d’un intervalle, c’est « la probabilité de la borne supérieure ou moins » moins « la probabilité de la borne inférieure ou moins ».
Si vous mettez FAUX comme dernier argument, vous obtenez la hauteur de la courbe en ce point (la valeur de la densité de probabilité) au lieu d’une probabilité.
Après le collage, la colonne B reçoit vos valeurs et la formule de la dernière ligne se calcule automatiquement. Le premier tableau affiche environ 0,70 (environ 70 %), le deuxième environ 0,10 (environ 10 %, c’est-à-dire les 10 % du haut environ).
Calculer avec Google Sheets
| Moyenne μ | 62 |
| Écart-type σ | 14 |
| Borne inférieure | 50 |
| Borne supérieure | 80 |
| Probabilité entre les bornes | =LOI.NORMALE(B4;B1;B2;VRAI)-LOI.NORMALE(B3;B1;B2;VRAI) |
| Moyenne μ | 62 |
| Écart-type σ | 14 |
| Valeur (part au-dessus de celle-ci) | 80 |
| Probabilité de cette valeur ou plus | =1-LOI.NORMALE(B3;B1;B2;VRAI) |
| Moyenne μ | 62 |
| Écart-type σ | 14 |
| Point x | 80 |
| Hauteur de la courbe en ce point | =LOI.NORMALE(B3;B1;B2;FAUX) |
LOI.NORMALE(x;moyenne;écart_type;VRAI) donne la probabilité d’obtenir x ou moins : la valeur de la borne supérieure moins celle de la borne inférieure donne la probabilité de l’intervalle.
Avec FAUX comme dernier argument, vous obtenez la hauteur de la courbe en ce point (la densité de probabilité) au lieu d’une probabilité.
Calculer avec Python
from statistics import NormalDist

mean = 62               # moyenne
standard_deviation = 14 # écart-type
lower_bound = 50        # borne inférieure de l’intervalle
upper_bound = 80        # borne supérieure de l’intervalle

distribution = NormalDist(mean, standard_deviation)
p_between = distribution.cdf(upper_bound) - distribution.cdf(lower_bound)

print(f"Probabilité entre {lower_bound} et {upper_bound} : {p_between}")
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
P(a ⩽ X ⩽ b) = Φ((b − μ)/σ) − Φ((a − μ)/σ)
P(a \leqslant X \leqslant b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>a</mi><mo>⩽</mo><mi>X</mi><mo>⩽</mo><mi>b</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>b</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
<mo>−</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>a</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
P(a <= X <= b) = Phi((b - mu)/sigma) - Phi((a - mu)/sigma)
CDF[NormalDistribution[mu, sigma], b] - CDF[NormalDistribution[mu, sigma], a]
with(Statistics): CDF(RandomVariable(Normal(mu, sigma)), b) - CDF(RandomVariable(Normal(mu, sigma)), a);
p = normcdf(b, mu, sigma) - normcdf(a, mu, sigma);
P(a ⩽ X ⩽ b) = Φ((b-μ)/σ) - Φ((a-μ)/σ)
f(x) = 1/(σ√(2π)) · e^(−(x − μ)²/(2σ²))
f(x) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac{(x-\mu)^2}{2\sigma^2}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mn>1</mn>
<mrow><mi>σ</mi><msqrt><mrow><mn>2</mn><mi>π</mi></mrow></msqrt></mrow>
</mfrac>
<msup>
<mi>e</mi>
<mrow>
<mo>−</mo>
<mfrac>
<msup><mrow><mo>(</mo><mi>x</mi><mo>−</mo><mi>μ</mi><mo>)</mo></mrow><mn>2</mn></msup>
<mrow><mn>2</mn><msup><mi>σ</mi><mn>2</mn></msup></mrow>
</mfrac>
</mrow>
</msup>
</mrow>
</math>
f(x) = 1/(sigma sqrt(2 pi)) e^(-(x - mu)^2 / (2 sigma^2))
PDF[NormalDistribution[mu, sigma], x]
with(Statistics): PDF(RandomVariable(Normal(mu, sigma)), x);
y = normpdf(x, mu, sigma);
f(x) = 1/(σ√(2π)) e^(-(x-μ)^2/(2σ^2))
Faire faire le calcul par ChatGPT
Tu es un assistant de calcul de probabilités. Fais le calcul suivant en exécutant réellement du code Python, et appuie ta réponse uniquement sur les nombres obtenus à l’exécution (ne réponds pas de tête ni par estimation).

Les notes d’un examen noté sur 100 suivent une loi normale de moyenne 62 points et d’écart-type 14 points.
Calcule chacune des probabilités suivantes :
1. La probabilité qu’une note soit comprise entre 50 et 80 points
2. La probabilité qu’une note soit de 80 points ou plus (dans les combien de pourcents du haut)
3. La probabilité qu’une note soit de 50 points ou moins

Utilise statistics.NormalDist de Python, et montre le code utilisé et les nombres obtenus à l’exécution. Réponds en français, avec la virgule comme séparateur décimal.
Mode d'emploi
-
1Saisissez vos nombresTapez les nombres à calculer dans les champs de saisie
-
2CalculezAppuyez sur le bouton « Calculer »
-
3Lisez le résultatLe résultat s’affiche aussitôt. La même page explique aussi le raisonnement et la formule
Les atouts de DataChef

Aucune compétence requise – simple et intuitif

Aucune donnée personnelle nécessaire

Le fichier est supprimé automatiquement après le téléchargement


Aucune mention de crédit nécessaire

Aucune autorisation préalable nécessaire
Fonctions connexes
Probabilité de deux événements indépendants (et, ou)
À partir de deux probabilités, calcule la probabilité que les deux se produisent, qu’au moins l’un se produise, et plus encore
Probabilité de deux événements (retrouver les valeurs manquantes)
À partir des deux probabilités connues, retrouve toutes les autres
Probabilité d’épreuves répétées (n fois de suite, au moins une fois)
Calcule la probabilité qu’un événement se produise n fois de suite, ou au moins une fois en n essais