



























































































Saisissez la taille de l’échantillon, la moyenne de l’échantillon, l’écart-type et le niveau de confiance. Le calculateur donne l’intervalle de confiance de la moyenne de la population (bornes inférieure et supérieure), la marge d’erreur et un tableau pour les niveaux de confiance courants.
Table des matières
-
Ce que vous pouvez faire sur cette page
-
À quoi sert ce calcul ?
-
Mode d'emploi
-
Formule et graphique
-
Symboles et termes
-
Ce qu’il est utile de savoir avant de commencer
-
Calculer avec Excel
-
Calculer avec Google Sheets
-
Calculer avec Python
-
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
-
Faire faire le calcul par ChatGPT
-
Les atouts de DataChef
-
Fonctions connexes
-
Liste des calculatrices NumberChef
Ce que vous pouvez faire sur cette page
- Entrez la taille de l’échantillon \(n\), la moyenne de l’échantillon \(\bar{x}\), l’écart-type \(\sigma\) et le niveau de confiance (%) : l’intervalle de confiance de la moyenne de la population (bornes inférieure et supérieure) s’affiche tout de suite
- La marge d’erreur \(E\) (de combien, en plus ou en moins, l’estimation peut se tromper), l’erreur type et la valeur critique z du niveau de confiance sont calculées en même temps
- Les intervalles de confiance aux niveaux courants (90 %, 95 %, 99 %…) sont réunis dans un tableau, et un graphique montre comment l’intervalle s’élargit
- Une explication simple des formules et des formules à copier-coller pour Excel, Google Sheets et Python sont réunies sur cette page
À quoi sert ce calcul ?
La « marge d’erreur » d’un sondage du type « cote de popularité à 45 % (marge d’erreur ± 2,5 points) », c’est exactement la marge d’erreur \(E\) de cette page. Pour 45 % d’opinions favorables sur 1 600 personnes interrogées, la dispersion vaut \(\sigma = \sqrt{0{,}45 \times 0{,}55} \approx 0{,}497\) ; au niveau de confiance de 95 %, \(E = 1{,}96 \times 0{,}497 \div \sqrt{1600} \approx 0{,}024\) (environ ± 2,4 points). On suppose ici que la proportion de réponses peut être approchée par une loi normale. Les « ± 2,5 points » annoncés dans les médias correspondent à une estimation faite avec 50 %, là où la dispersion est la plus grande.
Vous pourrez juger vous-même si une nouvelle comme « la cote a bougé d’un point » reste dans la marge d’erreur.
Une usine ne peut pas ouvrir et mesurer toutes les bouteilles : elle contrôle un échantillon. Si 50 bouteilles ont un contenu moyen de 500,2 mL avec un écart-type de 2 mL, l’intervalle de confiance à 95 % du contenu moyen de toute la production va d’environ 499,65 à 500,75 mL.
Vérifier statistiquement, à partir des seuls prélèvements, que les produits ne sont pas en dessous de la quantité annoncée : c’est un calcul utilisé tous les jours dans l’agroalimentaire, les boissons et le médicament.
Les articles médicaux donnent presque toujours leurs résultats avec un intervalle de confiance, comme « le nouveau médicament a fait baisser la tension de 8,0 mmHg en moyenne (intervalle de confiance à 95 % : 5,6 à 10,4) ». Dans un essai sur 100 personnes où les baisses ont un écart-type de 12 mmHg, \(E = 1{,}96 \times 12 \div \sqrt{100} \approx 2{,}4\).
Si tout l’intervalle est du côté positif (il ne contient pas 0), c’est un argument pour dire que « le médicament a eu un effet ». S’il contient 0, on lit plutôt « c’est peut-être le hasard ». C’est l’une des lectures les plus importantes pour juger soi-même une information de santé.
Évaluer tous les élèves du pays serait un travail énorme : une partie des enquêtes nationales sur la condition physique ou les acquis se fait par échantillon. Par exemple, si un échantillon de 400 élèves a un temps moyen de 9,2 secondes au 50 mètres avec un écart-type de 0,8 seconde, l’intervalle de confiance à 95 % du temps moyen de tous les élèves va d’environ 9,12 à 9,28 secondes. Seulement 400 élèves donnent déjà un intervalle assez étroit.
La statistique publique, comme l’enquête Emploi de l’Insee sur laquelle repose le taux de chômage, s’appuie aussi surtout sur des échantillons, et ce calcul garantit leur précision.
Quand le temps moyen passé sur votre site passe de 180 à 184 secondes, est-ce l’effet de votre modification ou le hasard ? Avec 2 500 visiteurs et un écart-type de 90 secondes, l’intervalle de confiance à 95 % du temps moyen va d’environ 176,5 à 183,5 secondes, soit une marge d’environ ± 3,5 secondes.
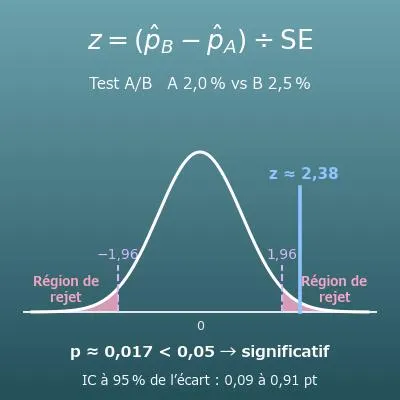
Si un changement est du même ordre que la largeur de l’intervalle de confiance, on peut dire qu’il « ne se distingue pas encore du hasard ». Cette idée est la base pour ne pas mal lire les résultats d’un test A/B.
Formule et graphique
Symboles et termes
Symboles
| \(n\) | n | La taille de l’échantillon : le nombre d’objets ou de personnes réellement mesurés (exemple : 50 bouteilles mesurées, \(n = 50\)). |
| \(\bar{x}\) | x barre | La moyenne de l’échantillon mesuré. La barre au-dessus est le signe d’une moyenne. |
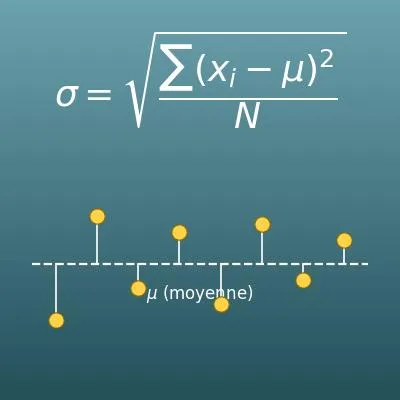
| \(\sigma\) | sigma | L’écart-type de la population, la taille de la dispersion dans toute la population. Une lettre grecque qui correspond au s latin. Si l’échantillon est assez grand, on peut le remplacer par l’écart-type de l’échantillon. |
| \(\sqrt{n}\) | racine de n | La racine carrée de la taille de l’échantillon (exemple : \(\sqrt{25} = 5\)). Elle apparaît au dénominateur de l’erreur type, et c’est à cause d’elle que 4 fois plus de données ne divisent l’erreur que par 2. |
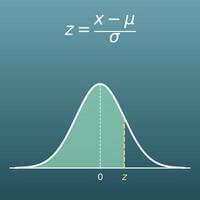
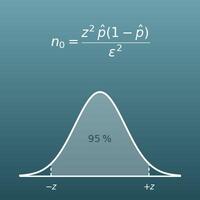
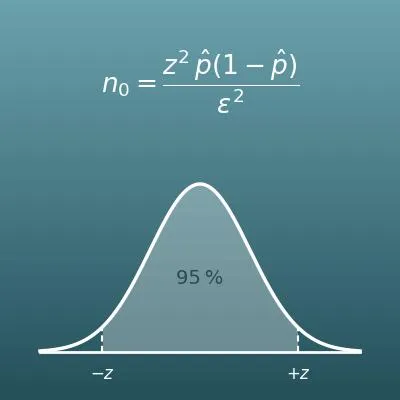
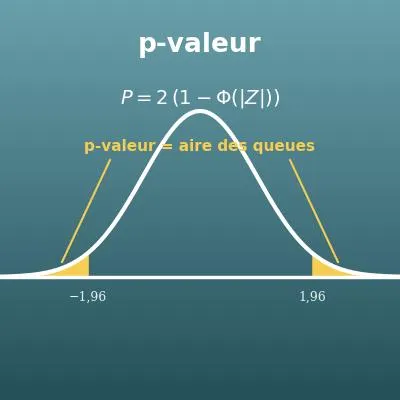
| \(z\) | z (valeur critique) | Le coefficient fixé par le niveau de confiance. C’est la borne, sur la loi normale centrée réduite, qui laisse exactement le niveau de confiance au milieu. Pour 95 %, elle vaut environ 1,96. |
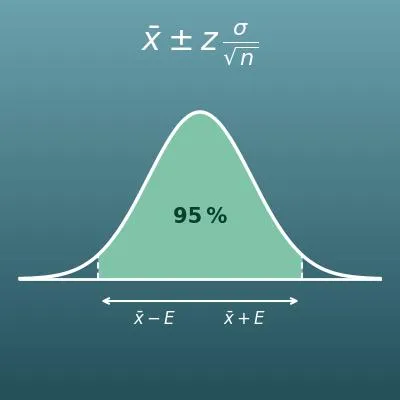
| \(E\) | E | La marge d’erreur. C’est la moitié de la largeur de l’intervalle de confiance, et un repère de l’écart possible, en plus ou en moins, entre la moyenne de l’échantillon et la moyenne de la population. E est l’initiale de « erreur ». |
| \(L,\ U\) | L, U | Les bornes inférieure et supérieure de l’intervalle de confiance (de l’anglais « lower » et « upper »), obtenues par \(L = \bar{x} - E\) et \(U = \bar{x} + E\). |
| \(\Phi^{-1}\) | phi moins un (réciproque de Φ) | La fonction réciproque de \(\Phi\), la fonction de répartition de la loi normale centrée réduite. À partir d’une probabilité (une aire), elle donne le z correspondant. (Exemple : \(\Phi^{-1}(0{,}975) \approx 1{,}96\)) |
| \(C\) | C | Le niveau de confiance écrit en décimal. Pour 95 %, \(C = 0{,}95\). |
Termes
| intervalle de confiance | Un intervalle estimé à partir des données d’un échantillon, dans lequel la moyenne de la population a de bonnes chances de se trouver. On le construit en étendant la moyenne de l’échantillon vers le haut et vers le bas de la marge d’erreur. |
| marge d’erreur | La moitié de la largeur de l’intervalle de confiance : l’écart maximal, en plus ou en moins, qu’on admet entre la moyenne de l’échantillon et la moyenne de la population, au niveau de confiance choisi. Elle vaut \(z \times \sigma \div \sqrt{n}\). |
| niveau de confiance | Le degré de confiance qu’on peut accorder à l’intervalle. C’est la proportion d’intervalles qui contiendraient la moyenne de la population si l’on construisait des intervalles de la même façon encore et encore. 95 % est le plus utilisé. |
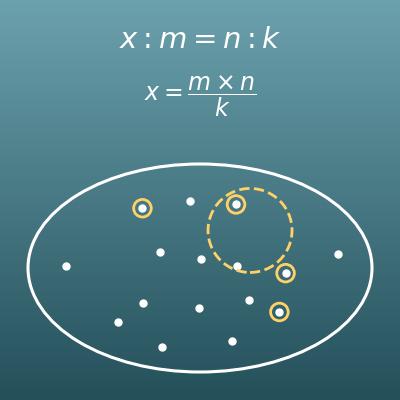
| population | Tout l’ensemble qu’on voudrait vraiment étudier (exemples : toutes les bouteilles produites par une usine, tous les électeurs du pays). |
| échantillon | La partie de la population qu’on prélève et qu’on étudie réellement. Déduire l’allure de la population à partir d’un échantillon, c’est l’estimation statistique. |
| moyenne de la population | La moyenne de toute la population. On ne peut pas tout mesurer, donc sa valeur exacte est inconnue. L’intervalle de confiance estime où se trouve cette valeur inconnue. On la note en général \(\mu\) (mu). |
| moyenne de l’échantillon | La moyenne de l’échantillon, \(\bar{x}\) (on dit aussi moyenne observée). C’est l’estimation la plus plausible, en un seul nombre, de la moyenne de la population (estimation ponctuelle), mais elle change un peu à chaque fois selon l’échantillon prélevé. |
| erreur type | La dispersion de la moyenne de l’échantillon elle-même (on dit aussi erreur standard), obtenue par \(\sigma \div \sqrt{n}\). Attention à ne pas la confondre avec la dispersion des valeurs une à une (l’écart-type). |
| estimation par intervalle | Une façon d’estimer une valeur inconnue, comme la moyenne de la population, par un intervalle plutôt que par un seul nombre. Par rapport à une estimation ponctuelle, elle a l’avantage de montrer aussi de combien l’estimation peut se tromper. |
| loi de Student | La loi utilisée à la place de la loi normale (z) quand l’échantillon est petit et que l’écart-type de la population est inconnu (on parle aussi de loi t). Le calculateur de cette page ne fait que la méthode avec z. Plus l’échantillon est grand, plus la loi de Student se rapproche de la loi normale, et les résultats deviennent presque identiques. |
Ce qu’il est utile de savoir avant de commencer
Voici ce qui vous aide à utiliser le calcul de cette page en le comprenant vraiment, et pas seulement en appuyant sur le bouton.
| La moyenne (5e, 12-13 ans) |
|
| Racines carrées (4e-3e, 13-15 ans) |
|
| Échantillonnage (2de, 15-16 ans) |
|
| Statistiques et écart-type (2de, 15-16 ans) |
|
| La loi normale et l’estimation par intervalle (lycée ou études supérieures, 17 ans et plus) |
|
Calculer avec Excel
| Confiance (%) | 95 |
| z | =LOI.NORMALE.STANDARD.INVERSE.N((1+B1/100)/2) |
| z | 1,96 |
| Écart-type σ | 2 |
| Taille de l’échantillon n | 25 |
| Marge d’erreur E | =B1*B2/RACINE(B3) |
| Taille de l’échantillon n | 50 |
| Moyenne de l’échantillon x̄ | 500,2 |
| Écart-type σ | 2 |
| Confiance (%) | 95 |
| z | =LOI.NORMALE.STANDARD.INVERSE.N((1+B4/100)/2) |
| Marge d’erreur E | =B5*B3/RACINE(B1) |
| Borne inférieure | =B2-B6 |
| Borne supérieure | =B2+B6 |
Le premier tableau trouve z à partir du seul niveau de confiance (B1) : entrez 95 et B2 vaut environ 1,959964. Le deuxième donne la marge d’erreur : avec les valeurs de l’exemple, B4 vaut 0,784.
Le troisième donne l’intervalle de confiance à partir de toutes les données d’un coup. Avec les valeurs de l’exemple (n = 50, x̄ = 500,2, σ = 2, 95 %), la borne inférieure (B7) vaut environ 499,6456 et la borne supérieure (B8) environ 500,7544. Il suffit de remplacer B1 à B4 par vos propres nombres.
Calculer avec Google Sheets
| Confiance (%) | 95 |
| z | =LOI.NORMALE.STANDARD.INVERSE((1+B1/100)/2) |
| z | 1,96 |
| Écart-type σ | 2 |
| Taille de l’échantillon n | 25 |
| Marge d’erreur E | =B1*B2/RACINE(B3) |
| Taille de l’échantillon n | 50 |
| Moyenne de l’échantillon x̄ | 500,2 |
| Écart-type σ | 2 |
| Confiance (%) | 95 |
| z | =LOI.NORMALE.STANDARD.INVERSE((1+B4/100)/2) |
| Marge d’erreur E | =B5*B3/RACINE(B1) |
| Borne inférieure | =B2-B6 |
| Borne supérieure | =B2+B6 |
Copiez tout le tableau, collez-le dans la cellule A1 et remplacez les nombres de la colonne B par les vôtres. Les résultats sont les mêmes que dans Excel : dans le troisième tableau, la borne inférieure vaut environ 499,6456 et la borne supérieure environ 500,7544.
Calculer avec Python
import math
from statistics import NormalDist

sample_size = 50        # taille de l’échantillon n
sample_mean = 500.2     # moyenne de l’échantillon x̄
sd = 2                  # écart-type σ
confidence_level = 95   # niveau de confiance (%)

z = NormalDist().inv_cdf((1 + confidence_level / 100) / 2)  # valeur critique z du niveau de confiance
standard_error = sd / math.sqrt(sample_size)                # erreur type σ ÷ √n
margin_of_error = z * standard_error                        # marge d’erreur E
lower = sample_mean - margin_of_error                       # borne inférieure de l’intervalle de confiance
upper = sample_mean + margin_of_error                       # borne supérieure de l’intervalle de confiance

print(f"z : {z}")
print(f"Marge d’erreur E : {margin_of_error}")
print(f"Intervalle de confiance à {confidence_level} % : de {lower} à {upper}")
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
E = z × σ ÷ √n
E = z \times \dfrac{\sigma}{\sqrt{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi>
<mo>=</mo>
<mi>z</mi>
<mo>×</mo>
<mfrac>
<mi>σ</mi>
<msqrt><mi>n</mi></msqrt>
</mfrac>
</mrow>
</math>
E = z sigma / sqrt(n)
z*sigma/Sqrt[n]
E := z*sigma/sqrt(n);
E = z*sigma/sqrt(n);
E = zσ/√n
L = x̄ − E, U = x̄ + E
L = \bar{x} - E,\quad U = \bar{x} + E
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>L</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>−</mo>
<mi>E</mi>
<mo>,</mo>
<mspace width="1em"/>
<mi>U</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>+</mo>
<mi>E</mi>
</mrow>
</math>
L = bar x - E, U = bar x + E
{xbar - e, xbar + e}
L := xbar - E; U := xbar + E;
L = xbar - E; U = xbar + E;
L = x̄ - E, U = x̄ + E
z = Φ⁻¹((1 + C) ÷ 2)
z = \Phi^{-1}\!\left(\dfrac{1+C}{2}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<msup><mi>Φ</mi><mrow><mo>−</mo><mn>1</mn></mrow></msup>
<mrow>
<mo>(</mo>
<mfrac>
<mrow><mn>1</mn><mo>+</mo><mi>C</mi></mrow>
<mn>2</mn>
</mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
z = Phi^-1((1 + C)/2)
InverseCDF[NormalDistribution[0, 1], (1 + c)/2]
with(Statistics): Quantile(RandomVariable(Normal(0, 1)), (1 + c)/2);
z = norminv((1 + c)/2);
z = Φ^(-1)((1+C)/2)
Faire faire le calcul par ChatGPT
Tu es un assistant de calcul en statistique. Fais le calcul suivant en exécutant réellement du code Python, et appuie ta réponse uniquement sur les nombres obtenus à l’exécution (ne réponds pas de tête ni par estimation).

On a prélevé 50 bouteilles sur une ligne de production et mesuré leur contenu. La moyenne est de 500,2 mL. On sait que l’écart-type du remplissage (écart-type de la population) est de 2 mL.
1. Calcule la valeur critique z pour un niveau de confiance de 95 % (utilise la réciproque de la fonction de répartition de la loi normale centrée réduite ; statistics.NormalDist().inv_cdf de la bibliothèque standard de Python convient).
2. Calcule la marge d’erreur E = z × σ ÷ √n.
3. Calcule l’intervalle de confiance à 95 % (bornes inférieure et supérieure) de la moyenne de la population (le vrai contenu moyen de toutes les bouteilles).

Montre les formules utilisées et les nombres obtenus à l’exécution. Réponds en français, avec la virgule comme séparateur décimal.
Mode d'emploi
-
1Saisissez vos nombresTapez les nombres à calculer dans les champs de saisie
-
2CalculezAppuyez sur le bouton « Calculer »
-
3Lisez le résultatLe résultat s’affiche aussitôt. La même page explique aussi le raisonnement et la formule
Les atouts de DataChef

Aucune compétence requise – simple et intuitif

Aucune donnée personnelle nécessaire

Le fichier est supprimé automatiquement après le téléchargement


Aucune mention de crédit nécessaire

Aucune autorisation préalable nécessaire
Fonctions connexes
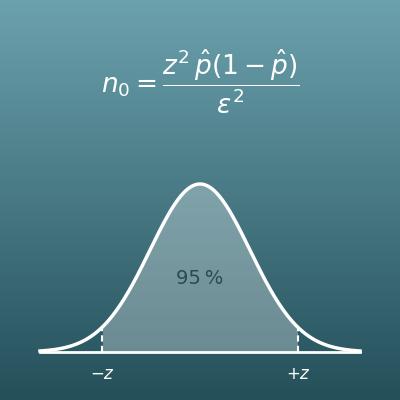
Calcul de la taille d’échantillon (sondage et marge d’erreur)
À partir de la marge d’erreur acceptée et du niveau de confiance, calcule la taille d’échantillon nécessaire à une enquête
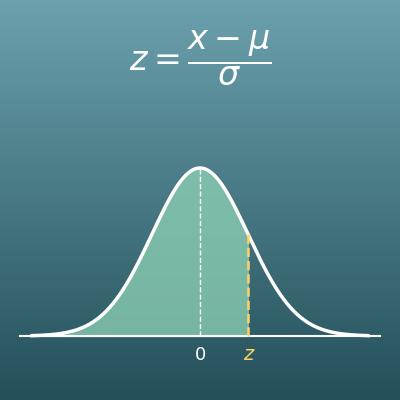
Calcul du score z : du score z à la probabilité et inversement
Calcule le score z à partir d’une valeur, de la moyenne et de l’écart-type, et le convertit en probabilité et inversement

Calcul de probabilité avec la loi normale
À partir de la moyenne et de l’écart-type, calcule la probabilité de tomber dans un intervalle donné