Calcolatrice di significatività del test A/B (tassi di conversione, p-value e intervallo di confidenza)
Inserisci i visitatori e le conversioni del gruppo A (la versione originale) e del gruppo B (la versione modificata). Oltre al tasso di conversione di ciascuno, alla differenza e all’incremento relativo, esegue un test z per due proporzioni per ottenere il punteggio z e il p-value e dà un verdetto «significativo / non significativo» al livello di significatività che scegli.
Indice
-
Cosa puoi fare in questa pagina
-
A cosa serve questo calcolo?
-
Come si usa
-
Formula
-
Tasso di conversione di ciascun gruppo
-
Differenza dei tassi di conversione e incremento relativo
-
Tasso di conversione combinato (un solo tasso per i due gruppi insieme)
-
Errore standard e punteggio z (test z per due proporzioni)
-
p-value (a due code e a una coda)
-
Intervallo di confidenza per la differenza dei tassi di conversione
-
-
Simboli e termini
-
Cosa conviene sapere prima
-
Come calcolarlo con Excel
-
Come calcolarlo con Fogli Google
-
Come calcolarlo con Python
-
La formula in LaTeX e in altre notazioni matematiche (da copiare)
-
Come chiedere a ChatGPT di fare il calcolo
-
I punti di forza di DataChef
-
Funzioni correlate
-
Tutte le calcolatrici di NumberChef
Cosa puoi fare in questa pagina
- Inserisci i visitatori (vanno bene anche clic o sessioni) e le conversioni dei gruppi A e B e ottieni in un colpo solo il tasso di conversione di ciascun gruppo, la differenza tra i tassi e l’incremento relativo
- «B sembra meglio, ma potrebbe essere solo variabilità casuale?» Un test z per due proporzioni risponde a questa domanda (punteggio z, p-value a due code e a una coda e un verdetto a un livello di significatività del 5%, 1% o 10%)
- Ottieni anche l’intervallo di confidenza della differenza (per esempio al 95%) e il margine con cui il punteggio z supera (o non raggiunge) la soglia di significatività
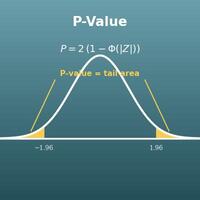
- Un grafico della distribuzione normale standard mostra dove cade il tuo punteggio z e colora la regione di rifiuto (il risultato è significativo se il punteggio z cade lì)
- In questa pagina trovi anche una spiegazione semplice delle formule e le formule da copiare e incollare per Excel, Fogli Google e Python
A cosa serve questo calcolo?
«La versione B, con un colore diverso del pulsante, ha alzato il tasso di conversione dal 2,0% al 2,5%». Verificare che questa differenza non sia solo dovuta al caso è la significatività del test A/B, che nel marketing online si fa ogni giorno. Con 10.000 visitatori per gruppo, il p-value a due code è circa 0,017, «significativo al 5%». Ma con tassi di conversione simili su 500 visitatori per gruppo (10 conversioni contro 12 o 13), il p-value è circa 0,5-0,7 e puoi solo dire «può essere il caso».
Se passi alla versione perché «B sembra meglio», capita spesso che i risultati rientrino il mese dopo. Decidere prima il numero di visitatori e giudicare con un livello di significatività lo evita (supponendo che i visitatori siano divisi a caso).
Invia la stessa email con due oggetti diversi a metà lista ciascuno e confronta tassi di apertura del 48% e del 52%. È anche un test sulla differenza tra due proporzioni. Con 5000 email per gruppo, la differenza di 4 punti ha un punteggio z di circa 4, una differenza difficile da spiegare con il caso.
Con lo stesso numero di email, le proporzioni più grandi come i tassi di apertura sono più facili da giudicare di quelle piccole come i tassi di conversione (la differenza tende a essere grande rispetto all’errore standard). Questa formula ti dà un’idea di come l’indicatore che confronti cambia il numero di invii necessari.
Confrontare le percentuali di miglioramento tra due gruppi, come «con la terapia standard è migliorato il 60% e con quella nuova il 70%», è un test di base negli studi clinici (gli studi veri usano disegni rigorosi, con randomizzazione e cecità).
Gli articoli alla base delle approvazioni dei farmaci e delle linee guida riportano sempre p-value e intervalli di confidenza. Una volta capita questa formula, non ti lasci influenzare dalla sola parola «significativo»; puoi leggere anche «quanto è grande la differenza?» e «c’erano abbastanza pazienti?».
Quando un nuovo processo B sembra ridurre la percentuale di difetti dall’1,5% all’1,0%, il verdetto cambia con i volumi: con 2000 pezzi per gruppo è «nell’ambito del caso» e con 20.000 pezzi per gruppo è «un miglioramento significativo». Questo calcolo evita che le decisioni su impianti e processi siano influenzate dal caso nei campioni piccoli.
Per proporzioni piccole come le percentuali di difetti, l’approssimazione normale diventa grossolana quando il numero atteso di difetti (pezzi × percentuale di difetti) scende sotto 5, quindi si sceglie invece un test esatto che usa direttamente la distribuzione binomiale (come il test esatto di Fisher).
Lo stesso test vale per confronti come «le classi che hanno usato il nuovo libro di testo hanno avuto il 75% di promossi, contro il 65% con il vecchio». Ma se assegni i libri per classe, gli studenti non sono stati divisi a caso e le differenze tra insegnanti e studenti si mescolano al risultato.
Nella ricerca in ambito educativo e sociale, oltre a verificare la significatività con questa formula, conta il disegno: i gruppi sono stati divisi a caso? Qualcuno ha cambiato il modo di tagliare il confronto dopo aver visto i risultati? Conoscere le ipotesi alla base della formula è ciò che ti impedisce di farti ingannare dai numeri.
Formula
Simboli e termini
Simboli
| \(n_A,\ n_B\) | enne con pedice A, enne con pedice B | I visitatori (clic o sessioni) dei gruppi A e B. \(n\) è la prima lettera dell’inglese «number», la lettera usata di solito in statistica per la dimensione del campione. |
| \(x_A,\ x_B\) | x con pedice A, x con pedice B | Le conversioni dei gruppi A e B. Indicare con \(x\) il numero di successi è l’uso abituale per la distribuzione binomiale. |
| \(\hat{p}_A,\ \hat{p}_B\) | pi con cappello e pedice A, pi con cappello e pedice B | I tassi di conversione dei gruppi A e B (proporzioni ricavate dal campione). \(p\) è la prima lettera di «proporzione» o «probabilità» e il «\(\hat{}\)» (cappello) in alto indica un valore stimato dal campione per il vero valore \(p\). |
| \(\hat{p}\) | pi con cappello | Il tasso di conversione combinato. Una sola stima del tasso di conversione ricavata dai due gruppi uniti, supponendo nessuna differenza: \(\hat{p} = (x_A + x_B) \div (n_A + n_B)\). |
| \(d\) | di | La differenza dei tassi di conversione (\(\hat{p}_B - \hat{p}_A\)), dalla prima lettera dell’inglese «difference». Questa pagina la mostra moltiplicata per 100, in punti percentuali. |
| \(L\) | elle | L’incremento relativo (%), dalla prima lettera dell’inglese «lift». Di quanto per cento è aumentato il tasso di conversione di B rispetto a quello di A. |
| \(\mathrm{SE}\) | esse e | L’errore standard (in inglese «standard error»). Un riferimento per quanto un valore ricavato dal campione (qui la differenza dei tassi di conversione) oscilla per caso; è la deviazione standard di quel valore campionario. Il test usa il tasso di conversione combinato e l’intervallo di confidenza usa \(\mathrm{SE}_d\), ricavato dal tasso di conversione di ciascun gruppo. |
| \(z\) | zeta | Il punteggio z (statistica test). La differenza divisa per l’errore standard: quante volte l’oscillazione casuale è la differenza. Senza differenza segue la distribuzione normale standard (media 0, deviazione standard 1), quindi il p-value dipende da quanto è grande. |
| \(|z|\) | valore assoluto di z | La grandezza del punteggio z senza il segno. Un test a due code non si interessa della direzione della differenza, quindi usa il valore assoluto. |
| \(\Phi\) | fi maiuscola | La funzione di ripartizione della distribuzione normale standard. \(\Phi(z)\) è la probabilità che un valore della normale standard sia uguale o minore di \(z\), l’area sotto la curva a campana a sinistra di \(z\). La lettera greca fi maiuscola è il simbolo abituale. |
| \(p_2,\ p_1\) | pi con pedice 2, pi con pedice 1 | I p-value a due code e a una coda. I pedici 2 e 1 indicano «due code» e «una coda», una distinzione usata solo in questa pagina; i libri di statistica scrivono semplicemente \(p\). |
| \(\alpha\) | alfa | Il livello di significatività: la soglia fissata in anticipo per cui «se il p-value è più piccolo, rifiuta l’ipotesi nulla». Il 5% (0,05) è molto usato. Lettera greca alfa; è la probabilità di un errore di primo tipo (dichiarare reale una differenza che non c’è). |
| \(z_{\alpha/2}\) | zeta alfa mezzi | Il punteggio z di confine (valore critico) che lascia nelle due code una probabilità totale di \(\alpha\). 1,96 per un intervallo di confidenza al 95% (\(\alpha = 0{,}05\)) e 2,576 per il 99%. Per una coda è \(z_\alpha\) (1,645 per il 5%). |
| \(d_L,\ d_U\) | di con pedice L, di con pedice U | L’estremo inferiore (lower) e superiore (upper) dell’intervallo di confidenza della differenza: i due estremi dell’intervallo in cui è probabile che si trovi la vera differenza. |
Termini
| test A/B | Un esperimento che mostra ai visitatori, a caso e nello stesso periodo, la versione originale (A) o una versione modificata (B) e ne confronta i risultati. È molto usato per siti, annunci ed email. Dividere a caso fa sì che i fattori diversi dalla versione (giorno della settimana, fonte del traffico e così via) siano uguali nei due gruppi. |
| tasso di conversione (CVR) | La quota di visite (clic) che hanno portato a un risultato (conversione) come un acquisto o un’iscrizione. Per calcolare o ricavare un singolo tasso di conversione vedi la calcolatrice del tasso di conversione. |
| ipotesi nulla | L’ipotesi che il test cerca di rifiutare: «A e B hanno davvero lo stesso tasso di conversione» (\(p_A = p_B\)). Il test verifica quanto sarebbe improbabile la differenza osservata se questa fosse vera. |
| ipotesi alternativa | L’ipotesi che vuoi mostrare, opposta all’ipotesi nulla. In un test a due code è «A e B differiscono» (\(p_A \neq p_B\)); in un test a una coda, «B è più alto di A» (\(p_B > p_A\)). |
| livello di significatività | La soglia fissata prima del test: se il p-value è più piccolo, si rifiuta l’ipotesi nulla. Il 5% è molto usato; usa l’1% per un test più severo. «Significativo al 5%» dice che «la probabilità di una differenza così grande senza una vera differenza è sotto il 5%». |
| p-value | La probabilità che una differenza almeno così grande compaia per caso, supponendo vera l’ipotesi nulla (nessuna differenza). Più è piccolo, più è difficile spiegare il risultato con il caso. Attenzione, non è «la probabilità che B sia migliore» (un equivoco frequente). |
| statisticamente significativo | Il p-value è sotto il livello di significatività, quindi la differenza è giudicata difficile da spiegare con la variabilità casuale. Non promette che la differenza sia grande o l’effetto certo; con un numero enorme di visitatori anche una differenza minima diventa significativa. |
| statistica test | Un singolo numero calcolato dai dati per il test. In questa pagina è il punteggio z, «differenza ÷ errore standard». Quanto è estremo decide il p-value. |
| test z per due proporzioni | Un test che usa la distribuzione normale per verificare se le proporzioni (come i tassi di conversione) di due gruppi differiscono. È il modo più semplice per giudicare la significatività di un test A/B. Con un test chi quadro 2×2 si fa quasi la stessa cosa e i p-value a due code coincidono. |
| errore standard | La deviazione standard di una statistica ricavata da un campione (qui la differenza dei tassi di conversione): quanto oscilla per caso a seconda del campione. Si riduce in proporzione alla radice quadrata dei visitatori, quindi per dimezzare l’errore standard servono 4 volte i visitatori. |
| stima combinata (pooled) | Unire i dati dei due gruppi in un’unica stima del tasso di conversione, supponendo che non ci sia differenza. L’errore standard del test usa questo valore combinato (in inglese «pooled»). |
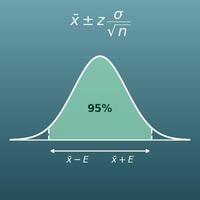
| intervallo di confidenza | L’intervallo in cui è probabile che si trovi la vera differenza. Un intervallo di confidenza al 95% è un modo di costruire intervalli tale che, ripetendo l’esperimento molte volte, il 95% di essi conterrebbe la vera differenza. Se l’intervallo non comprende lo 0, quasi sempre ciò concorda con la significatività in un test a due code al 5%. |
| test a due code | Un test su «c’è una differenza (qualunque sia il più alto)?». Usalo per un normale test A/B in cui non sai da che parte andrà. |
| test a una coda | Un test con una direzione fissata, come «B è più alto di A?». Il suo p-value è la metà di quello a due code, quindi diventa significativo più facilmente; usalo solo se hai deciso la direzione prima del test. |
| regione di rifiuto | La zona di coda della distribuzione normale standard in cui, se cade il punteggio z, si rifiuta l’ipotesi nulla. Per il 5% a due code sono le due code \(z < -1{,}96\) e \(z > 1{,}96\), con area totale 0,05. È la parte colorata del grafico di questa pagina. |
| valore critico | Il punteggio z al bordo della regione di rifiuto. 1,96 per il 5% a due code, 2,576 per l’1% a due code e 1,645 per il 5% a una coda. Il «margine del punteggio z» nel risultato mostra di quanto questo punteggio z sta sopra (o sotto) il valore critico. |
| approssimazione normale | Il numero di conversioni in realtà segue una distribuzione binomiale, ma con molti visitatori una distribuzione normale (la curva a campana) la approssima bene. Il test z usa questa approssimazione, quindi, come riferimento, le conversioni attese \(n\hat{p}\) e le non conversioni attese \(n(1-\hat{p})\) di ciascun gruppo dovrebbero essere almeno 5 (almeno 10 se possibile). |
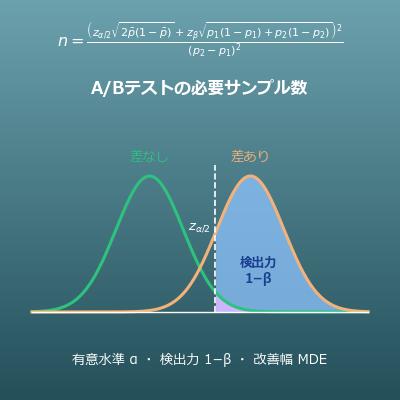
| potenza del test | La probabilità che il test rilevi come significativa una differenza reale. Con pochi visitatori la potenza è bassa e anche un effetto reale risulta spesso «non significativo». «Non significativo» non dimostra «nessuna differenza». |
| errore di primo tipo | Dichiarare significativo un risultato quando in realtà non c’è differenza (un falso positivo). Il livello di significatività \(\alpha\) è la probabilità di questo errore che accetti; al 5%, «esegui 100 test senza una vera differenza e circa 5 risulteranno significativi per caso». |
| confronti multipli | Testare insieme molte versioni o molti indicatori. Anche a un livello di significatività del 5%, se testi 20 indicatori uno risulterà probabilmente «significativo» per caso. Bisogna restringere gli indicatori in anticipo o usare un livello di significatività più severo (correzione di Bonferroni e altre). |
| interruzione anticipata (peeking) | Controllare i risultati più e più volte durante il test e fermarsi appena sembra significativo. Il p-value sale e scende durante un test, quindi se continui a «fermarti la prima volta che scende sotto il 5%», la probabilità di significatività senza vera differenza va ben oltre il 5%. La regola di base è decidere prima i visitatori necessari e aspettare di raggiungerli. |
| incremento relativo (lift) | Di quanto per cento è aumentato il tasso di conversione di B rispetto a quello di A: la differenza \(d\) divisa per il tasso di conversione di A, per 100. «Su del 25%» si traduce più facilmente in stime di conversioni e ricavi in più di «su di 0,5 punti». |
| punto percentuale | L’unità per il risultato della sottrazione tra due percentuali (abbreviata pp). Si usa così: «2,5% − 2% = 0,5 punti percentuali»; scrivere «0,5%» potrebbe essere scambiato per «lo 0,5% del 2%». |
Cosa conviene sapere prima
Ecco che cosa conviene sapere per usare il calcolo di questa pagina capendo davvero che cosa fai, e non solo premendo il pulsante.
Se ti blocchi, ripassare questi argomenti è la strada più rapida.
| Percentuali (classe 5ª della primaria e scuola secondaria di primo grado, 10-12 anni) |
|
| Reciproci e radici quadrate (scuola secondaria di primo grado, 11-14 anni) |
|
| La distribuzione normale e la deviazione standard (statistica, scuola secondaria di secondo grado, 14-19 anni) |
|
| La logica del test di ipotesi (statistica, scuola secondaria di secondo grado, 14-19 anni) |
|
| La distribuzione binomiale e la sua approssimazione normale (statistica, scuola secondaria di secondo grado, 14-19 anni) |
|
Come calcolarlo con Excel
| Visitatori di A n_A | 10000 |
| Conversioni di A x_A | 200 |
| Visitatori di B n_B | 10000 |
| Conversioni di B x_B | 250 |
| Tasso di conversione di A p̂_A | =B2/B1 |
| Tasso di conversione di B p̂_B | =B4/B3 |
| Tasso di conversione di A p̂_A | 0,02 |
| Tasso di conversione di B p̂_B | 0,025 |
| Differenza d | =B2-B1 |
| Incremento relativo L (%) | =B3/B1*100 |
| Conversioni di A x_A | 200 |
| Conversioni di B x_B | 250 |
| Visitatori di A n_A | 10000 |
| Visitatori di B n_B | 10000 |
| Tasso di conversione combinato p̂ | =(B1+B2)/(B3+B4) |
| Tasso di conversione combinato p̂ | 0,0225 |
| Visitatori di A n_A | 10000 |
| Visitatori di B n_B | 10000 |
| Differenza d | 0,005 |
| Errore standard SE | =RADQ(B1*(1-B1)*(1/B2+1/B3)) |
| Punteggio z z | =B4/B5 |
| Punteggio z z | 2,384 |
| p-value a due code p₂ | =2*(1-DISTRIB.NORM.ST.N(ASS(B1);VERO)) |
| p-value a una coda p₁ | =1-DISTRIB.NORM.ST.N(B1;VERO) |
| Tasso di conversione di A p̂_A | 0,02 |
| Visitatori di A n_A | 10000 |
| Tasso di conversione di B p̂_B | 0,025 |
| Visitatori di B n_B | 10000 |
| Differenza d | 0,005 |
| Livello di confidenza (0,95 = 95%) | 0,95 |
| z_(α/2) | =INV.NORM.S(1-(1-B6)/2) |
| Errore standard SE_d | =RADQ(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Estremo inferiore d_L | =B5-B7*B8 |
| Estremo superiore d_U | =B5+B7*B8 |
Nella prima tabella B5 mostra il tasso di conversione di A, 0,02, e B6 quello di B, 0,025. La seconda tabella dà una differenza di 0,005 (0,5 punti percentuali) e un lift di 25, la terza un tasso di conversione combinato di 0,0225 e la quarta un errore standard di circa 0,002097 e un punteggio z di circa 2,384.
Nella quinta tabella, DISTRIB.NORM.ST.N(z; VERO) restituisce la probabilità cumulata della normale standard Φ(z); il p-value a due code è circa 0,0171 e quello a una coda circa 0,0086. Nella sesta tabella, INV.NORM.S ricava il punteggio z da una probabilità cumulata (1,96 per un livello di confidenza del 95%), dando un estremo inferiore di circa 0,0009 e uno superiore di circa 0,0091 (da 0,09 a 0,91 punti percentuali).
Come calcolarlo con Fogli Google
| Visitatori di A n_A | 10000 |
| Conversioni di A x_A | 200 |
| Visitatori di B n_B | 10000 |
| Conversioni di B x_B | 250 |
| Tasso di conversione di A p̂_A | =B2/B1 |
| Tasso di conversione di B p̂_B | =B4/B3 |
| Tasso di conversione di A p̂_A | 0,02 |
| Tasso di conversione di B p̂_B | 0,025 |
| Differenza d | =B2-B1 |
| Incremento relativo L (%) | =B3/B1*100 |
| Conversioni di A x_A | 200 |
| Conversioni di B x_B | 250 |
| Visitatori di A n_A | 10000 |
| Visitatori di B n_B | 10000 |
| Tasso di conversione combinato p̂ | =(B1+B2)/(B3+B4) |
| Tasso di conversione combinato p̂ | 0,0225 |
| Visitatori di A n_A | 10000 |
| Visitatori di B n_B | 10000 |
| Differenza d | 0,005 |
| Errore standard SE | =RADQ(B1*(1-B1)*(1/B2+1/B3)) |
| Punteggio z z | =B4/B5 |
| Punteggio z z | 2,384 |
| p-value a due code p₂ | =2*(1-DISTRIB.NORM.ST(ASS(B1))) |
| p-value a una coda p₁ | =1-DISTRIB.NORM.ST(B1) |
| Tasso di conversione di A p̂_A | 0,02 |
| Visitatori di A n_A | 10000 |
| Tasso di conversione di B p̂_B | 0,025 |
| Visitatori di B n_B | 10000 |
| Differenza d | 0,005 |
| Livello di confidenza (0,95 = 95%) | 0,95 |
| z_(α/2) | =INV.NORM.ST(1-(1-B6)/2) |
| Errore standard SE_d | =RADQ(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Estremo inferiore d_L | =B5-B7*B8 |
| Estremo superiore d_U | =B5+B7*B8 |
Come calcolarlo con Python
import math

visits_a, conversions_a = 10000, 200   # visitatori e conversioni di A
visits_b, conversions_b = 10000, 250   # visitatori e conversioni di B
alpha = 0.05                           # livello di significatività (5%)

def normal_cdf(z):
    # funzione di ripartizione della normale standard Φ(z)
    return 0.5 * math.erfc(-z / math.sqrt(2))

def normal_ppf(p):
    # inversa di Φ (bisezione; serve per trovare z_(α/2))
    low, high = -10.0, 10.0
    for _ in range(100):
        mid = (low + high) / 2
        if normal_cdf(mid) < p:
            low = mid
        else:
            high = mid
    return (low + high) / 2

cvr_a = conversions_a / visits_a
cvr_b = conversions_b / visits_b
diff = cvr_b - cvr_a
lift = diff / cvr_a * 100
pooled = (conversions_a + conversions_b) / (visits_a + visits_b)
se_pooled = math.sqrt(pooled * (1 - pooled) * (1 / visits_a + 1 / visits_b))
z = diff / se_pooled
p_two_sided = 2 * (1 - normal_cdf(abs(z)))
p_one_sided = 1 - normal_cdf(z)

se_diff = math.sqrt(cvr_a * (1 - cvr_a) / visits_a + cvr_b * (1 - cvr_b) / visits_b)
z_half = normal_ppf(1 - alpha / 2)
ci_low, ci_high = diff - z_half * se_diff, diff + z_half * se_diff

print(f"Tasso di conversione A: {cvr_a * 100:.2f}%  Tasso di conversione B: {cvr_b * 100:.2f}%")
print(f"Differenza: {diff * 100:.2f} punti percentuali  Incremento relativo: {lift:.1f}%")
print(f"Punteggio z: {z:.3f}  p-value a due code: {p_two_sided:.4f}  p-value a una coda: {p_one_sided:.4f}")
print("Verdetto (due code):", "statisticamente significativo" if p_two_sided < alpha else "non statisticamente significativo")
print(f"Intervallo di confidenza al {(1 - alpha) * 100:.0f}% per la differenza: da {ci_low * 100:.2f} a {ci_high * 100:.2f} punti percentuali")
La formula in LaTeX e in altre notazioni matematiche (da copiare)
p̂_A = x_A ÷ n_A
\hat{p}_A = \dfrac{x_A}{n_A}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
    <mo>=</mo>
    <mfrac>
      <msub><mi>x</mi><mi>A</mi></msub>
      <msub><mi>n</mi><mi>A</mi></msub>
    </mfrac>
  </mrow>
</math>
hat(p)_A = x_A / n_A
xA/nA
pA := xA/nA;
pA = xA/nA;
p̂_A = x_A/n_A
d = p̂_B − p̂_A, L = d ÷ p̂_A × 100
d = \hat{p}_B - \hat{p}_A, \quad L = \dfrac{d}{\hat{p}_A} \times 100
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>=</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub>
<mo>−</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
<mo>,</mo><mspace width="1em"/>
<mi>L</mi><mo>=</mo>
<mfrac><mi>d</mi><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mfrac>
<mo>×</mo><mn>100</mn>
</mrow>
</math>
d = hat(p)_B - hat(p)_A, L = d / hat(p)_A xx 100
d = pB - pA; d/pA*100
d := pB - pA; L := d/pA*100;
d = pB - pA; L = d/pA*100;
d = p̂_B − p̂_A, L = d/p̂_A × 100
p̂ = (x_A + x_B) ÷ (n_A + n_B)
\hat{p} = \dfrac{x_A + x_B}{n_A + n_B}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mover accent="true"><mi>p</mi><mo>^</mo></mover>
    <mo>=</mo>
    <mfrac>
      <mrow><msub><mi>x</mi><mi>A</mi></msub><mo>+</mo><msub><mi>x</mi><mi>B</mi></msub></mrow>
      <mrow><msub><mi>n</mi><mi>A</mi></msub><mo>+</mo><msub><mi>n</mi><mi>B</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
hat(p) = (x_A + x_B) / (n_A + n_B)
(xA + xB)/(nA + nB)
pPool := (xA + xB)/(nA + nB);
pPool = (xA + xB)/(nA + nB);
p̂ = (x_A + x_B)/(n_A + n_B)
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d ÷ SE
\mathrm{SE} = \sqrt{\hat{p}(1-\hat{p})\left(\dfrac{1}{n_A}+\dfrac{1}{n_B}\right)}, \quad z = \dfrac{d}{\mathrm{SE}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi><mo>=</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mrow>
<msqrt>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
<mo>(</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>A</mi></msub></mfrac>
<mo>+</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>B</mi></msub></mfrac>
<mo>)</mo>
</msqrt>
</mfrac>
</mrow>
</math>
SE = sqrt(hat(p)(1 - hat(p))(1/n_A + 1/n_B)), z = d / SE
se = Sqrt[pPool*(1 - pPool)*(1/nA + 1/nB)]; z = d/se
SE := sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z := d/SE;
SE = sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z = d/SE;
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d/SE
p₂ = 2(1 − Φ(|z|)), p₁ = 1 − Φ(z)
p_2 = 2\left(1 - \Phi(|z|)\right), \quad p_1 = 1 - \Phi(z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>p</mi><mn>2</mn></msub><mo>=</mo>
<mn>2</mn><mo>(</mo><mn>1</mn><mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>z</mi><mo>|</mo><mo>)</mo><mo>)</mo>
<mo>,</mo><mspace width="1em"/>
<msub><mi>p</mi><mn>1</mn></msub><mo>=</mo>
<mn>1</mn><mo>−</mo><mi>Φ</mi><mo>(</mo><mi>z</mi><mo>)</mo>
</mrow>
</math>
p_2 = 2(1 - Phi(|z|)), p_1 = 1 - Phi(z)
p2 = 2*(1 - CDF[NormalDistribution[0, 1], Abs[z]]); p1 = 1 - CDF[NormalDistribution[0, 1], z]
p2 := 2*(1 - Statistics:-CDF(Normal(0, 1), abs(z))); p1 := 1 - Statistics:-CDF(Normal(0, 1), z);
p2 = 2*(1 - normcdf(abs(z))); p1 = 1 - normcdf(z);
p_2 = 2(1 − Φ(|z|)), p_1 = 1 − Φ(z)
d ± z_(α/2) × √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
d \pm z_{\alpha/2}\sqrt{\dfrac{\hat{p}_A(1-\hat{p}_A)}{n_A}+\dfrac{\hat{p}_B(1-\hat{p}_B)}{n_B}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>±</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>A</mi></msub>
</mfrac>
<mo>+</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>B</mi></msub>
</mfrac>
</msqrt>
</mrow>
</math>
d +- z_(alpha/2) sqrt((hat(p)_A(1 - hat(p)_A))/n_A + (hat(p)_B(1 - hat(p)_B))/n_B)
seD = Sqrt[pA*(1 - pA)/nA + pB*(1 - pB)/nB]; {d - zHalf*seD, d + zHalf*seD}
seD := sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); [d - zHalf*seD, d + zHalf*seD];
seD = sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); ci = [d - zHalf*seD, d + zHalf*seD];
d ± z_(α/2) √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
Come chiedere a ChatGPT di fare il calcolo
Sei un assistente per i calcoli di statistica (test di ipotesi). Fai il calcolo seguente eseguendo davvero del codice Python e basa la risposta solo sui numeri del risultato dell’esecuzione (non rispondere con calcoli a mente né a occhio).

I risultati del test A/B sono:
- Gruppo A: 10.000 visitatori, 200 conversioni
- Gruppo B: 10.000 visitatori, 250 conversioni
Trova ognuno dei valori seguenti:
1. Il tasso di conversione di ciascun gruppo (%), la differenza dei tassi di conversione (punti percentuali) e l’incremento relativo (%)
2. Il tasso di conversione combinato e l’errore standard combinato SE = √(p̂(1−p̂)(1/n_A + 1/n_B))
3. Il punteggio z = differenza ÷ SE e i p-value a due code e a una coda (distribuzione normale standard)
4. Se la differenza è statisticamente significativa a un livello di significatività del 5% (due code)
5. L’intervallo di confidenza al 95% per la differenza (con l’errore standard ricavato dal tasso di conversione di ciascun gruppo, √(p̂_A(1−p̂_A)/n_A + p̂_B(1−p̂_B)/n_B))

In Python usa math.erfc (o scipy.stats.norm) e mostra le formule che hai usato e i numeri del risultato dell’esecuzione.
Come si usa
-
1Inserisci i numeriScrivi nei campi i numeri con cui vuoi fare il calcolo
-
2CalcolaFai clic sul pulsante «Calcola»
-
3Guarda il risultatoIl risultato compare subito. Nella stessa pagina trovi anche lo svolgimento del calcolo e la spiegazione della formula
I punti di forza di DataChef

Nessuna competenza richiesta, semplice e intuitivo

Nessun dato personale richiesto

Il file viene eliminato automaticamente dopo il download


Nessun obbligo di attribuzione

Nessuna autorizzazione preventiva necessaria
Funzioni correlate
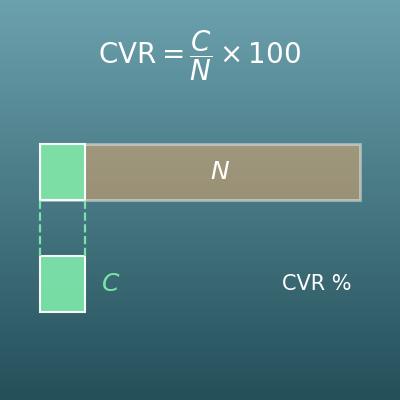
Calcolatrice del tasso di conversione (CVR, visite necessarie e conversioni previste)
Inserisci due qualsiasi tra visite, conversioni e tasso di conversione e ottieni il terzo. Usala se ti serve solo il tasso di conversione di un gruppo
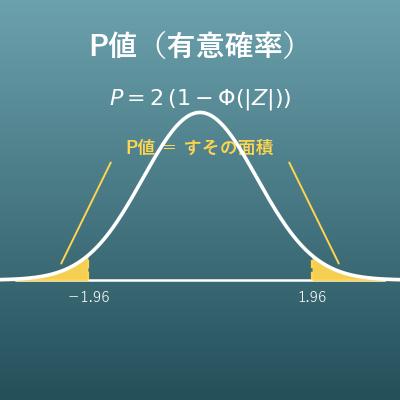
Calcolatrice p-value: dal punteggio z al p-value e viceversa
Una calcolatrice generale che converte un punteggio z che hai già in un p-value a sinistra, a destra o a due code. Questa pagina parte un passo prima, da visitatori e conversioni
Calcolatrice dell’intervallo di confidenza per la media
Ricava l’intervallo di confidenza di una media (voti di un compito, vendite e così via). La versione per le medie dell’intervallo di confidenza della differenza di questa pagina
Calcolatrice della numerosità campionaria (sondaggi e margine di errore)
Calcola quante persone servono per stimare una proporzione entro un margine di errore in un sondaggio. Usala per progettare i sondaggi