
Calculadora de significación estadística para test A/B (tasa de conversión, p-valor e intervalo de confianza)
Introduce las visitas y las conversiones del grupo A (la versión original) y del grupo B (la versión cambiada). Además de cada tasa de conversión, la diferencia y la mejora relativa, hace un contraste z de dos proporciones para obtener la puntuación z y el p-valor, y concluye «significativo / no significativo» con el nivel de significación que elijas.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmula
-
Tasa de conversión de cada grupo
-
Diferencia de tasas de conversión y mejora relativa
-
Proporción combinada (una sola tasa para los dos grupos juntos)
-
Error típico y puntuación z (contraste z de dos proporciones)
-
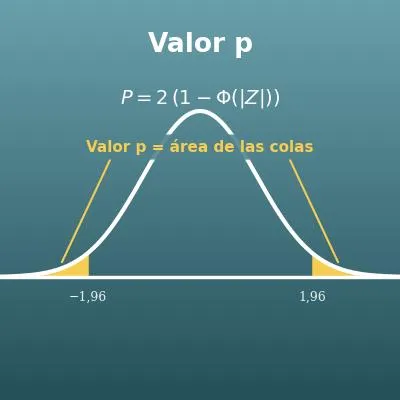
P-valor (bilateral y unilateral)
-
Intervalo de confianza de la diferencia de tasas de conversión
-
-
Símbolos y términos
-
Conviene saber antes de empezar
-
Cómo calcularlo en Excel
-
Cómo calcularlo en Hojas de cálculo de Google
-
Cómo calcularlo en Python
-
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
-
Cómo pedirle el cálculo a ChatGPT
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Lista de calculadoras de NumberChef
Qué puedes hacer en esta página
- Con solo introducir las visitas (también valen clics o sesiones) y las conversiones de los grupos A y B, calcula de una vez la tasa de conversión de cada grupo, la diferencia entre ellas y la mejora relativa (lift)
- «B parece mejor, pero ¿no será casualidad?». Lo responde un contraste z de dos proporciones (puntuación z, p-valor bilateral y unilateral, y conclusión con un nivel de significación del 5 %, 1 % o 10 %)
- También da el intervalo de confianza de la diferencia (por ejemplo, al 95 %) y el margen con el que la puntuación z supera (o no alcanza) la línea de significación
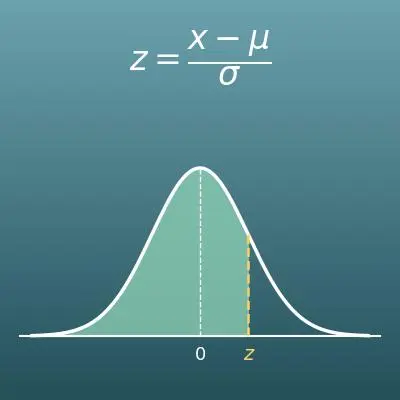
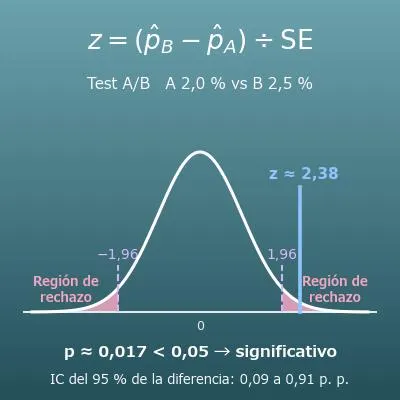
- Una gráfica de la distribución normal estándar muestra dónde cae tu puntuación z y sombrea la región de rechazo (si la z cae ahí, es significativo)
- En esta página tienes además una explicación sencilla de las fórmulas y fórmulas para copiar y pegar en Excel, Hojas de cálculo de Google y Python
¿Para qué sirve este cálculo?
«La versión B, con otro color de botón, ha subido la tasa de conversión del 2,0 % al 2,5 %». Comprobar que esa diferencia no es pura casualidad es la significación de un test A/B, algo que se hace a diario en marketing online. Con 10.000 visitas en cada versión, el p-valor bilateral es de unos 0,017, «significativo al 5 %». Pero con tasas parecidas y 500 visitas en cada una (10 conversiones frente a 12 o 13), el p-valor ronda entre 0,5 y 0,7, y solo puedes decir «puede ser casualidad».
Si cambias de versión porque «B parece mejor», a menudo los resultados vuelven a su sitio al mes siguiente. Fijar primero el número de visitas y decidir con un nivel de significación lo evita (siempre que las visitas se repartan al azar).
Envía el mismo email con dos asuntos distintos, cada uno a la mitad de la lista, y compara tasas de apertura del 48 % y del 52 %. También es un contraste de la diferencia entre dos proporciones. Con 5000 emails en cada grupo, la diferencia de 4 puntos tiene una puntuación z de unos 4, una diferencia difícil de explicar por azar.
Con el mismo número de envíos, las proporciones grandes como la tasa de apertura son más fáciles de evaluar que las pequeñas como la tasa de conversión (la diferencia suele ser grande en comparación con el error típico). Con esta fórmula te haces una idea de cómo cambia el número de envíos necesario según la métrica que compares.
Comparar las tasas de mejora de dos grupos, como «mejoró el 60 % con el tratamiento estándar y el 70 % con el nuevo», es un contraste básico de los estudios clínicos (los estudios reales usan diseños estrictos, como la aleatorización y el doble ciego).
Los artículos en los que se basan las autorizaciones de medicamentos y las guías de tratamiento siempre informan de p-valores e intervalos de confianza. Si entiendes esta fórmula, no te dejas llevar por la palabra «significativo»; también sabes leer «¿cómo de grande es la diferencia?» y «¿había suficientes pacientes?».
Cuando un nuevo proceso B parece bajar la tasa de defectos del 1,5 % al 1,0 %, la conclusión cambia con el volumen: con 2000 unidades en cada grupo está «dentro del azar», y con 20.000 en cada uno es «una mejora significativa». Este cálculo evita que las decisiones sobre maquinaria y procesos dependan del azar de muestras pequeñas.
Con proporciones pequeñas como las tasas de defectos, la aproximación normal se vuelve tosca cuando el número esperado de defectos (unidades × tasa de defectos) baja de 5, así que se elige en su lugar un contraste exacto que usa directamente la distribución binomial (como la prueba exacta de Fisher).
El mismo contraste sirve para comparaciones como «las clases con el libro nuevo aprobaron en un 75 %, frente al 65 % con el antiguo». Pero si asignas los libros por clase, los alumnos no se han repartido al azar, y las diferencias de profesorado y alumnado se mezclan en el resultado.
En la investigación educativa y en ciencias sociales, además de comprobar la significación con esta fórmula, importa el diseño: ¿se repartieron los grupos al azar? ¿Alguien cambió la forma de comparar después de ver los resultados? Conocer los supuestos de la fórmula es lo que evita que los números te engañen.
Fórmula
Símbolos y términos
Símbolos
| \(n_A,\ n_B\) | ene subíndice A, ene subíndice B | Visitas (clics o sesiones) de los grupos A y B. \(n\) es la inicial de «número», la letra habitual en estadística para el tamaño de la muestra. |
| \(x_A,\ x_B\) | equis subíndice A, equis subíndice B | Conversiones de los grupos A y B. Usar \(x\) para el número de éxitos es lo habitual en la distribución binomial. |
| \(\hat{p}_A,\ \hat{p}_B\) | p gorro subíndice A, p gorro subíndice B | Tasas de conversión de los grupos A y B (proporciones de la muestra). \(p\) es la inicial de «proporción» o «probabilidad», y el «\(\hat{}\)» (gorro) de arriba indica que es un valor estimado con la muestra para el valor real \(p\). |
| \(\hat{p}\) | p gorro | Proporción combinada. Una sola tasa de conversión estimada con los dos grupos juntos, suponiendo que no hay diferencia: \(\hat{p} = (x_A + x_B) \div (n_A + n_B)\). |
| \(d\) | de | Diferencia de tasas de conversión (\(\hat{p}_B - \hat{p}_A\)), por la inicial de «diferencia». Esta página la muestra multiplicada por 100, en puntos porcentuales. |
| \(L\) | ele | Mejora relativa (%), por la inicial de «lift» (elevar, en inglés). Cuánto ha aumentado, en %, la tasa de conversión de B respecto a la de A. |
| \(\mathrm{SE}\) | ese-e | Error típico (en inglés, standard error). Indica cuánto se mueve por azar un valor de la muestra (aquí, la diferencia de tasas de conversión); es la desviación típica de ese valor. El contraste lo calcula con la proporción combinada, y el intervalo de confianza usa \(\mathrm{SE}_d\), calculado con la tasa de cada grupo. |
| \(z\) | zeta | Puntuación z (estadístico de contraste). La diferencia dividida entre el error típico: cuántas veces el vaivén del azar mide la diferencia. Si no hay diferencia, sigue la distribución normal estándar (media 0, desviación típica 1), así que el p-valor sale de lo grande que sea. |
| \(|z|\) | valor absoluto de z | El tamaño de la puntuación z sin su signo. Un contraste bilateral no tiene en cuenta en qué sentido va la diferencia, así que usa el valor absoluto. |
| \(\Phi\) | fi mayúscula | La función de distribución de la distribución normal estándar. \(\Phi(z)\) es la probabilidad de que un valor normal estándar sea \(z\) o menos, el área bajo la campana a la izquierda de \(z\). La letra griega fi mayúscula es el símbolo habitual. |
| \(p_2,\ p_1\) | p subíndice 2, p subíndice 1 | El p-valor bilateral y el unilateral. Los subíndices 2 y 1 indican «dos colas» y «una cola», una notación solo de esta página; los libros de estadística escriben simplemente \(p\). |
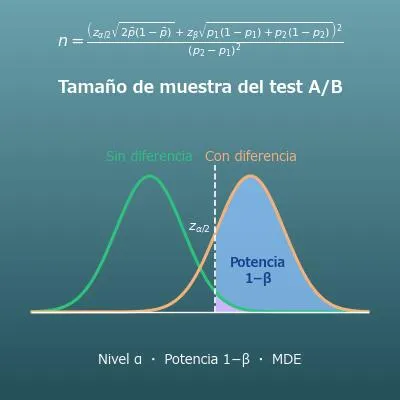
| \(\alpha\) | alfa | El nivel de significación: la línea fijada de antemano de «si el p-valor es menor, se rechaza la hipótesis nula». Lo habitual es un 5 % (0,05). Es la letra griega alfa y equivale a la probabilidad de cometer un error de tipo I (dar por real una diferencia que no existe). |
| \(z_{\alpha/2}\) | zeta subíndice alfa medios | La puntuación z límite (valor crítico) que deja una probabilidad total \(\alpha\) en las dos colas. 1,96 para un intervalo de confianza al 95 % (\(\alpha = 0{,}05\)) y 2,576 al 99 %. Con una sola cola es \(z_\alpha\) (1,645 al 5 %). |
| \(d_L,\ d_U\) | de subíndice L, de subíndice U | Los límites inferior (L, lower) y superior (U, upper) del intervalo de confianza de la diferencia: los dos extremos del rango donde probablemente está la diferencia real. |
Términos
| test A/B | Experimento que muestra a los visitantes, al azar y en el mismo periodo, la versión original (A) o una versión cambiada (B) y compara los resultados. Se usa mucho en webs, anuncios y email. Repartir al azar hace que los factores ajenos a la versión (día de la semana, origen del tráfico, etc.) sean iguales en los dos grupos. |
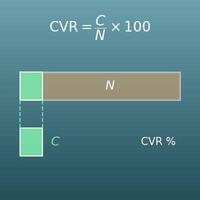
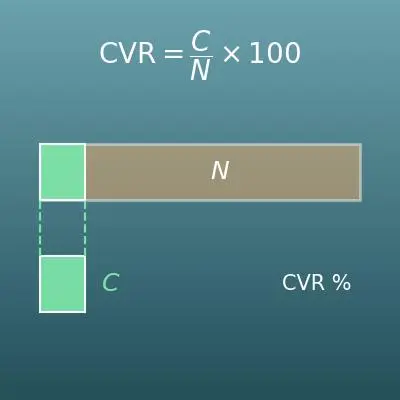
| tasa de conversión (CVR) | Proporción de visitas (clics) que terminaron en un resultado (conversión) como una compra o un alta. Para calcular una sola tasa de conversión o hacer el cálculo inverso, consulta la calculadora de la tasa de conversión. |
| hipótesis nula | La hipótesis que el contraste intenta rechazar: «A y B tienen en realidad la misma tasa de conversión» (\(p_A = p_B\)). El contraste comprueba lo improbable que sería la diferencia observada si fuera cierta. |
| hipótesis alternativa | La hipótesis que quieres demostrar, contraria a la hipótesis nula. En un contraste bilateral es «A y B son distintos» (\(p_A \neq p_B\)); en uno unilateral, «B es mayor que A» (\(p_B > p_A\)). |
| nivel de significación | La línea fijada antes del test: si el p-valor es menor, se rechaza la hipótesis nula. Lo habitual es un 5 %; para ser más exigente, un 1 %. «Significativo al 5 %» quiere decir «la probabilidad de una diferencia así de grande sin diferencia real es menor del 5 %». |
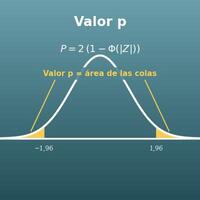
| p-valor | Probabilidad de que salga por azar una diferencia al menos tan grande como esta, suponiendo cierta la hipótesis nula (no hay diferencia). Cuanto más pequeño, más difícil es explicar el resultado por azar. Ojo: no es «la probabilidad de que B sea mejor» (un error frecuente). |
| estadísticamente significativo | El p-valor está por debajo del nivel de significación, así que la diferencia se considera difícil de explicar por azar. No garantiza que la diferencia sea grande ni el efecto seguro; con muchísimas visitas, hasta una diferencia minúscula sale significativa. |
| estadístico de contraste | Un único número calculado con los datos para el contraste. En esta página es la puntuación z, «diferencia ÷ error típico». Lo extremo que sea decide el p-valor. |
| contraste z de dos proporciones | Contraste que usa la distribución normal para comprobar si las proporciones (por ejemplo, tasas de conversión) de dos grupos son distintas. Es la forma más básica de decidir si un test A/B es significativo. Con una prueba chi-cuadrado 2×2 se hace casi lo mismo, y los p-valores bilaterales coinciden. |
| error típico | La desviación típica de un estadístico calculado con una muestra (aquí, la diferencia de tasas de conversión): cuánto se mueve por azar según la muestra. Se reduce en proporción a la raíz cuadrada de las visitas, así que para dividir el error típico entre dos hacen falta 4 veces más visitas. |
| proporción combinada | Estimar una sola tasa de conversión juntando los datos de los dos grupos, suponiendo que no hay diferencia (en inglés, pooled, de «pool», juntar en un fondo común). El error típico del contraste usa este valor. |
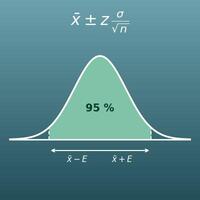
| intervalo de confianza | El rango donde probablemente está la diferencia real. Un intervalo de confianza al 95 % es una forma de construir intervalos de modo que, si repitieras el experimento muchas veces, el 95 % de ellos contendría la diferencia real. Que el intervalo no incluya el 0 casi siempre coincide con la significación en un contraste bilateral al 5 %. |
| contraste bilateral | Contraste de «¿hay diferencia (sea cual sea el mayor)?». Es el que se usa en un test A/B normal, en el que no sabes hacia dónde va a ir. |
| contraste unilateral | Contraste con un sentido fijado, como «¿es B mayor que A?». Su p-valor es la mitad del bilateral, así que sale significativo con más facilidad; úsalo solo si decidiste el sentido antes del test. |
| región de rechazo | La zona de las colas de la distribución normal estándar donde, si cae la puntuación z, se rechaza la hipótesis nula (también llamada región crítica). Para un contraste bilateral al 5 % son las dos colas \(z < -1{,}96\) y \(z > 1{,}96\), con un área total de 0,05. Es la parte sombreada de la gráfica de esta página. |
| valor crítico | La puntuación z en el borde de la región de rechazo. 1,96 para un contraste bilateral al 5 %, 2,576 bilateral al 1 % y 1,645 unilateral al 5 %. El «margen de la z» del resultado indica cuánto está la puntuación z por encima (o por debajo) del valor crítico. |
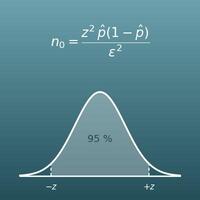
| aproximación normal | El número de conversiones sigue en realidad una distribución binomial, pero con muchas visitas una distribución normal (la campana) la aproxima bien. El contraste z usa esta aproximación, así que como referencia las conversiones esperadas \(n\hat{p}\) y las no conversiones esperadas \(n(1-\hat{p})\) de cada grupo deberían ser de 5 o más (mejor 10 o más). |
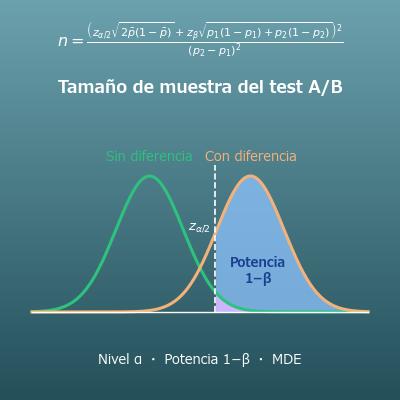
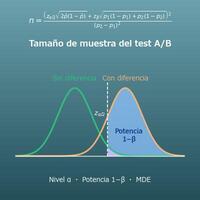
| potencia estadística | La probabilidad de que el contraste detecte como significativa una diferencia real (también, potencia del contraste). Con pocas visitas, la potencia es baja, y hasta un efecto real sale a menudo «no significativo». «No significativo» no demuestra que «no hay diferencia». |
| error de tipo I | Dar un resultado por significativo cuando en realidad no hay diferencia (un falso positivo). El nivel de significación \(\alpha\) es la probabilidad de este error que aceptas; al 5 %, «si haces 100 tests sin diferencia real, unos 5 salen significativos por azar». |
| comparaciones múltiples | Contrastar muchas versiones o métricas a la vez. Incluso con un nivel de significación del 5 %, si contrastas 20 métricas es probable que una salga «significativa» por azar. Hay que acotar las métricas de antemano o usar un nivel de significación más exigente (corrección de Bonferroni y otras). |
| peeking | Mirar los resultados una y otra vez durante el test y pararlo en cuanto parece significativo (parar antes de tiempo). El p-valor sube y baja durante el test, así que si sigues la regla de «parar la primera vez que baje del 5 %», la probabilidad de significación sin diferencia real supera con mucho el 5 %. La regla básica es decidir antes las visitas necesarias y esperar a alcanzarlas. |
| mejora relativa | Cuánto ha aumentado, en %, la tasa de conversión de B respecto a la de A (en inglés, lift): la diferencia \(d\) dividida entre la tasa de conversión de A, por 100. «Un 25 % más» es más fácil de convertir en previsiones de conversiones e ingresos adicionales que «0,5 puntos más». |
| punto porcentual | Unidad para el resultado de restar dos porcentajes (abreviado p. p.). Se usa así: «2,5 % − 2 % = 0,5 puntos porcentuales»; escribir «0,5 %» podría confundirse con «el 0,5 % del 2 %». |
Conviene saber antes de empezar
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo lo que haces, no solo pulsando el botón.
Si te atascas, repasar estos temas es el camino más rápido.
| Porcentajes (5.º y 6.º de Primaria, 10-12 años) |
|
| Inversos y raíces cuadradas (6.º de Primaria a 2.º de ESO, 11-14 años) |
|
| La distribución normal y la desviación típica (1.º y 2.º de Bachillerato, 16-18 años) |
|
| La lógica del contraste de hipótesis (Bachillerato y primeros cursos de universidad, 17 años o más) |
|
| La distribución binomial y su aproximación normal (1.º de Bachillerato, 16-17 años) |
|
Cómo calcularlo en Excel
| Visitas en A n_A | 10000 |
| Conversiones en A x_A | 200 |
| Visitas en B n_B | 10000 |
| Conversiones en B x_B | 250 |
| Tasa de conversión de A p̂_A | =B2/B1 |
| Tasa de conversión de B p̂_B | =B4/B3 |
| Tasa de conversión de A p̂_A | 0,02 |
| Tasa de conversión de B p̂_B | 0,025 |
| Diferencia d | =B2-B1 |
| Mejora relativa L (%) | =B3/B1*100 |
| Conversiones en A x_A | 200 |
| Conversiones en B x_B | 250 |
| Visitas en A n_A | 10000 |
| Visitas en B n_B | 10000 |
| Proporción combinada p̂ | =(B1+B2)/(B3+B4) |
| Proporción combinada p̂ | 0,0225 |
| Visitas en A n_A | 10000 |
| Visitas en B n_B | 10000 |
| Diferencia d | 0,005 |
| Error típico SE | =RAIZ(B1*(1-B1)*(1/B2+1/B3)) |
| Puntuación z | =B4/B5 |
| Puntuación z | 2,384 |
| P-valor bilateral p₂ | =2*(1-DISTR.NORM.ESTAND.N(ABS(B1);VERDADERO)) |
| P-valor unilateral p₁ | =1-DISTR.NORM.ESTAND.N(B1;VERDADERO) |
| Tasa de conversión de A p̂_A | 0,02 |
| Visitas en A n_A | 10000 |
| Tasa de conversión de B p̂_B | 0,025 |
| Visitas en B n_B | 10000 |
| Diferencia d | 0,005 |
| Nivel de confianza (0,95 = 95 %) | 0,95 |
| z_(α/2) | =INV.NORM.ESTAND(1-(1-B6)/2) |
| Error típico SE_d | =RAIZ(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Límite inferior d_L | =B5-B7*B8 |
| Límite superior d_U | =B5+B7*B8 |
En la primera tabla, B5 muestra la tasa de conversión de A, 0,02, y B6 la de B, 0,025. La segunda tabla da una diferencia de 0,005 (0,5 puntos porcentuales) y una mejora relativa de 25; la tercera, una proporción combinada de 0,0225; y la cuarta, un error típico de unos 0,002097 y una puntuación z de unos 2,384.
En la quinta tabla, DISTR.NORM.ESTAND.N(z; VERDADERO) devuelve la probabilidad acumulada de la normal estándar Φ(z); el p-valor bilateral sale de unos 0,0171 y el unilateral de unos 0,0086. En la sexta, INV.NORM.ESTAND obtiene la puntuación z a partir de una probabilidad acumulada (1,96 para un nivel de confianza del 95 %), con un límite inferior de unos 0,0009 y uno superior de unos 0,0091 (de 0,09 a 0,91 puntos porcentuales).
Cómo calcularlo en Hojas de cálculo de Google
| Visitas en A n_A | 10000 |
| Conversiones en A x_A | 200 |
| Visitas en B n_B | 10000 |
| Conversiones en B x_B | 250 |
| Tasa de conversión de A p̂_A | =B2/B1 |
| Tasa de conversión de B p̂_B | =B4/B3 |
| Tasa de conversión de A p̂_A | 0,02 |
| Tasa de conversión de B p̂_B | 0,025 |
| Diferencia d | =B2-B1 |
| Mejora relativa L (%) | =B3/B1*100 |
| Conversiones en A x_A | 200 |
| Conversiones en B x_B | 250 |
| Visitas en A n_A | 10000 |
| Visitas en B n_B | 10000 |
| Proporción combinada p̂ | =(B1+B2)/(B3+B4) |
| Proporción combinada p̂ | 0,0225 |
| Visitas en A n_A | 10000 |
| Visitas en B n_B | 10000 |
| Diferencia d | 0,005 |
| Error típico SE | =RAIZ(B1*(1-B1)*(1/B2+1/B3)) |
| Puntuación z | =B4/B5 |
| Puntuación z | 2,384 |
| P-valor bilateral p₂ | =2*(1-DISTR.NORM.ESTAND(ABS(B1))) |
| P-valor unilateral p₁ | =1-DISTR.NORM.ESTAND(B1) |
| Tasa de conversión de A p̂_A | 0,02 |
| Visitas en A n_A | 10000 |
| Tasa de conversión de B p̂_B | 0,025 |
| Visitas en B n_B | 10000 |
| Diferencia d | 0,005 |
| Nivel de confianza (0,95 = 95 %) | 0,95 |
| z_(α/2) | =DISTR.NORM.ESTAND.INV(1-(1-B6)/2) |
| Error típico SE_d | =RAIZ(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Límite inferior d_L | =B5-B7*B8 |
| Límite superior d_U | =B5+B7*B8 |
Cómo calcularlo en Python
import math

visits_a, conversions_a = 10000, 200   # visitas y conversiones en A
visits_b, conversions_b = 10000, 250   # visitas y conversiones en B
alpha = 0.05                           # nivel de significación (5 %)

def normal_cdf(z):
    # función de distribución de la normal estándar Φ(z)
    return 0.5 * math.erfc(-z / math.sqrt(2))

def normal_ppf(p):
    # inversa de Φ (bisección; sirve para obtener z_(α/2))
    low, high = -10.0, 10.0
    for _ in range(100):
        mid = (low + high) / 2
        if normal_cdf(mid) < p:
            low = mid
        else:
            high = mid
    return (low + high) / 2

cvr_a = conversions_a / visits_a
cvr_b = conversions_b / visits_b
diff = cvr_b - cvr_a
lift = diff / cvr_a * 100
pooled = (conversions_a + conversions_b) / (visits_a + visits_b)
se_pooled = math.sqrt(pooled * (1 - pooled) * (1 / visits_a + 1 / visits_b))
z = diff / se_pooled
p_two_sided = 2 * (1 - normal_cdf(abs(z)))
p_one_sided = 1 - normal_cdf(z)

se_diff = math.sqrt(cvr_a * (1 - cvr_a) / visits_a + cvr_b * (1 - cvr_b) / visits_b)
z_half = normal_ppf(1 - alpha / 2)
ci_low, ci_high = diff - z_half * se_diff, diff + z_half * se_diff

print(f"Tasa de conversión A: {cvr_a * 100:.2f} %  Tasa de conversión B: {cvr_b * 100:.2f} %")
print(f"Diferencia: {diff * 100:.2f} puntos porcentuales  Mejora relativa: {lift:.1f} %")
print(f"Puntuación z: {z:.3f}  p-valor bilateral: {p_two_sided:.4f}  p-valor unilateral: {p_one_sided:.4f}")
print("Conclusión (bilateral):", "estadísticamente significativo" if p_two_sided < alpha else "no estadísticamente significativo")
print(f"Intervalo de confianza al {(1 - alpha) * 100:.0f} % de la diferencia: de {ci_low * 100:.2f} a {ci_high * 100:.2f} puntos porcentuales")
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
p̂_A = x_A ÷ n_A
\hat{p}_A = \dfrac{x_A}{n_A}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
    <mo>=</mo>
    <mfrac>
      <msub><mi>x</mi><mi>A</mi></msub>
      <msub><mi>n</mi><mi>A</mi></msub>
    </mfrac>
  </mrow>
</math>
hat(p)_A = x_A / n_A
xA/nA
pA := xA/nA;
pA = xA/nA;
p̂_A = x_A/n_A
d = p̂_B − p̂_A, L = d ÷ p̂_A × 100
d = \hat{p}_B - \hat{p}_A, \quad L = \dfrac{d}{\hat{p}_A} \times 100
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>=</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub>
<mo>−</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
<mo>,</mo><mspace width="1em"/>
<mi>L</mi><mo>=</mo>
<mfrac><mi>d</mi><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mfrac>
<mo>×</mo><mn>100</mn>
</mrow>
</math>
d = hat(p)_B - hat(p)_A, L = d / hat(p)_A xx 100
d = pB - pA; d/pA*100
d := pB - pA; L := d/pA*100;
d = pB - pA; L = d/pA*100;
d = p̂_B − p̂_A, L = d/p̂_A × 100
p̂ = (x_A + x_B) ÷ (n_A + n_B)
\hat{p} = \dfrac{x_A + x_B}{n_A + n_B}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mover accent="true"><mi>p</mi><mo>^</mo></mover>
    <mo>=</mo>
    <mfrac>
      <mrow><msub><mi>x</mi><mi>A</mi></msub><mo>+</mo><msub><mi>x</mi><mi>B</mi></msub></mrow>
      <mrow><msub><mi>n</mi><mi>A</mi></msub><mo>+</mo><msub><mi>n</mi><mi>B</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
hat(p) = (x_A + x_B) / (n_A + n_B)
(xA + xB)/(nA + nB)
pPool := (xA + xB)/(nA + nB);
pPool = (xA + xB)/(nA + nB);
p̂ = (x_A + x_B)/(n_A + n_B)
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d ÷ SE
\mathrm{SE} = \sqrt{\hat{p}(1-\hat{p})\left(\dfrac{1}{n_A}+\dfrac{1}{n_B}\right)}, \quad z = \dfrac{d}{\mathrm{SE}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi><mo>=</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mrow>
<msqrt>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
<mo>(</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>A</mi></msub></mfrac>
<mo>+</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>B</mi></msub></mfrac>
<mo>)</mo>
</msqrt>
</mfrac>
</mrow>
</math>
SE = sqrt(hat(p)(1 - hat(p))(1/n_A + 1/n_B)), z = d / SE
se = Sqrt[pPool*(1 - pPool)*(1/nA + 1/nB)]; z = d/se
SE := sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z := d/SE;
SE = sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z = d/SE;
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d/SE
p₂ = 2(1 − Φ(|z|)), p₁ = 1 − Φ(z)
p_2 = 2\left(1 - \Phi(|z|)\right), \quad p_1 = 1 - \Phi(z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>p</mi><mn>2</mn></msub><mo>=</mo>
<mn>2</mn><mo>(</mo><mn>1</mn><mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>z</mi><mo>|</mo><mo>)</mo><mo>)</mo>
<mo>,</mo><mspace width="1em"/>
<msub><mi>p</mi><mn>1</mn></msub><mo>=</mo>
<mn>1</mn><mo>−</mo><mi>Φ</mi><mo>(</mo><mi>z</mi><mo>)</mo>
</mrow>
</math>
p_2 = 2(1 - Phi(|z|)), p_1 = 1 - Phi(z)
p2 = 2*(1 - CDF[NormalDistribution[0, 1], Abs[z]]); p1 = 1 - CDF[NormalDistribution[0, 1], z]
p2 := 2*(1 - Statistics:-CDF(Normal(0, 1), abs(z))); p1 := 1 - Statistics:-CDF(Normal(0, 1), z);
p2 = 2*(1 - normcdf(abs(z))); p1 = 1 - normcdf(z);
p_2 = 2(1 − Φ(|z|)), p_1 = 1 − Φ(z)
d ± z_(α/2) × √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
d \pm z_{\alpha/2}\sqrt{\dfrac{\hat{p}_A(1-\hat{p}_A)}{n_A}+\dfrac{\hat{p}_B(1-\hat{p}_B)}{n_B}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>±</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>A</mi></msub>
</mfrac>
<mo>+</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>B</mi></msub>
</mfrac>
</msqrt>
</mrow>
</math>
d +- z_(alpha/2) sqrt((hat(p)_A(1 - hat(p)_A))/n_A + (hat(p)_B(1 - hat(p)_B))/n_B)
seD = Sqrt[pA*(1 - pA)/nA + pB*(1 - pB)/nB]; {d - zHalf*seD, d + zHalf*seD}
seD := sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); [d - zHalf*seD, d + zHalf*seD];
seD = sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); ci = [d - zHalf*seD, d + zHalf*seD];
d ± z_(α/2) √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
Cómo pedirle el cálculo a ChatGPT
Eres un asistente de cálculo de estadística (contraste de hipótesis). Haz el siguiente cálculo ejecutando de verdad código Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas con cálculo mental ni con estimaciones).

Los resultados del test A/B son:
- Grupo A: 10.000 visitas, 200 conversiones
- Grupo B: 10.000 visitas, 250 conversiones
Calcula lo siguiente:
1. La tasa de conversión de cada grupo (%), la diferencia de tasas (puntos porcentuales) y la mejora relativa (%)
2. La proporción combinada y el error típico combinado SE = √(p̂(1−p̂)(1/n_A + 1/n_B))
3. La puntuación z = diferencia ÷ SE, y el p-valor bilateral y el unilateral (distribución normal estándar)
4. Si la diferencia es estadísticamente significativa con un nivel de significación del 5 % (bilateral)
5. El intervalo de confianza al 95 % de la diferencia (con el error típico calculado con la tasa de cada grupo, √(p̂_A(1−p̂_A)/n_A + p̂_B(1−p̂_B)/n_B))

En Python, usa math.erfc (o scipy.stats.norm) y muestra las fórmulas que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los datosEscribe en las casillas los números con los que quieres calcular
-
2CalculaPulsa el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página tienes también la idea del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo
Sin necesidad de dar datos personales
Los archivos se borran automáticamente tras la descarga
Sin necesidad de atribución
Sin necesidad de pedir permiso
Funciones relacionadas
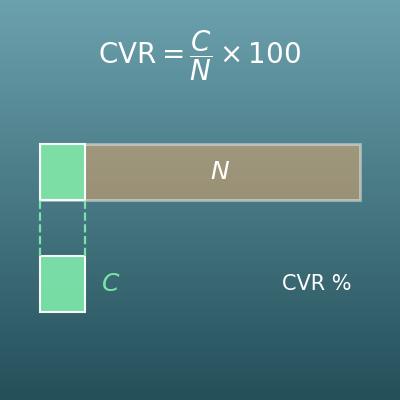
Calculadora de la tasa de conversión (CVR, visitas necesarias y conversiones previstas)
Con dos datos entre visitas, conversiones y tasa de conversión, calcula el tercero. Si solo necesitas la tasa de conversión de un grupo, es esta
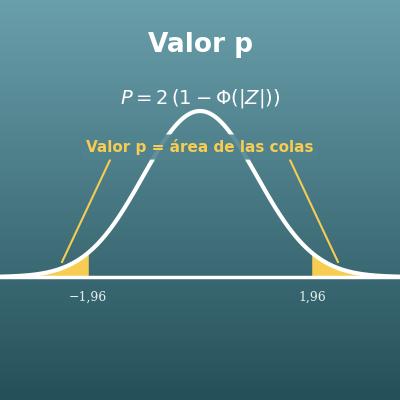
Calculadora de p-valor: de z al p-valor y al revés
Calculadora general que pasa una puntuación z que ya tienes a p-valor unilateral izquierdo, derecho o bilateral. Esta página empieza un paso antes, con las visitas y las conversiones
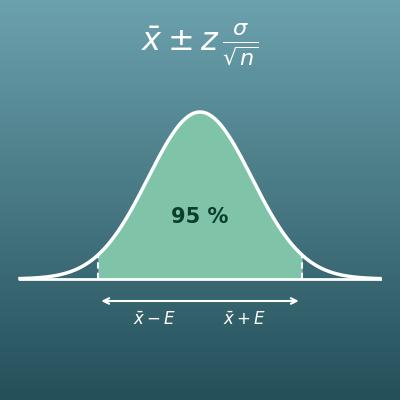
Calculadora del intervalo de confianza para la media
Calcula el intervalo de confianza de una media (notas de un examen, ventas, etc.). Es la versión para medias del intervalo de confianza de la diferencia de esta página
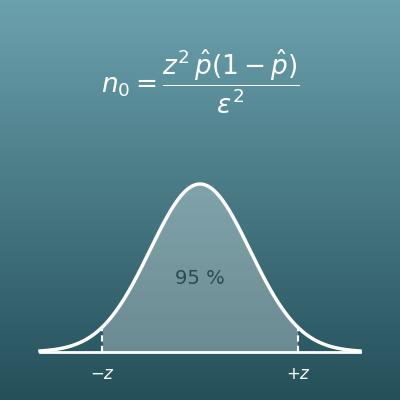
Calculadora del tamaño de la muestra y del margen de error
Calcula cuántas personas necesitas en una encuesta para estimar una proporción con un margen de error dado. Para diseñar encuestas