
Escribe la media, la desviación típica y los límites inferior y superior del intervalo que te interesa. Se calcula la probabilidad de caer en ese intervalo y una tabla de intervalos de confianza.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmula y gráfica
-
Símbolos y términos
-
Conviene saber antes de empezar
-
Cómo calcularlo en Excel
-
Cómo calcularlo en Hojas de cálculo de Google
-
Cómo calcularlo en Python
-
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
-
Cómo pedirle el cálculo a ChatGPT
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Lista de calculadoras de NumberChef
Qué puedes hacer en esta página
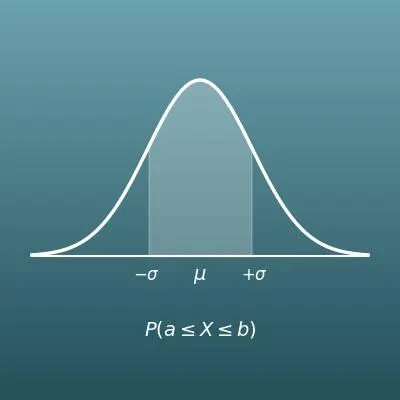
- Escribe la media \(\mu\) y la dispersión (desviación típica \(\sigma\)) y obtén al momento la probabilidad de que un valor caiga en el intervalo que elijas
- También calcula la probabilidad de quedar por encima (o por debajo) de un valor, como «¿qué porcentaje de alumnos sacó 8 o más?»
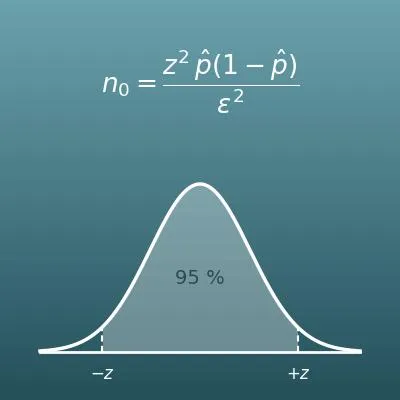
- Muestra a la vez una tabla con los intervalos más usados en estadística (como el que contiene el 95 % del total)
- En la misma página tienes una explicación sencilla de la distribución normal y fórmulas listas para copiar en Excel, Hojas de cálculo de Google y Python
¿Para qué sirve este cálculo?
El cociente intelectual (CI) se fija de modo que la media sea 100 y una desviación típica equivalga a 15 puntos. En una distribución normal, solo alrededor del 16 % de la gente está en \(+1\sigma\) o más (CI de 115 o más), y solo alrededor del 2,3 % en \(+2\sigma\) o más (130 o más).
Cuando ves esta relación, los percentiles de las pruebas estandarizadas dejan de ser un misterio: puedes leer con números, y no a ojo, lo que significa «subir 10 puntos» o «estar en el percentil 90».
Los valores de referencia de un análisis de sangre y pruebas parecidas se fijan a menudo como el intervalo que contiene el 95 % central de las medidas de personas sanas (más o menos la media \(\pm 2\sigma\)).
Así que, en cualquier prueba, alrededor del 5 % de las personas sanas (1 de cada 20) queda fuera del rango de referencia. En un análisis con muchos parámetros, es normal que una persona sana tenga alguno marcado. Sabiendo esto, entiendes que «salirse un poco del rango» no significa automáticamente que «algo va mal», y puedes escuchar la explicación del médico con calma.
El peso y las medidas de los productos varían de forma parecida a una distribución normal. Por ejemplo, si unos paquetes de 100 g se llenan con una media de 102 g y una desviación típica de 1 g, los que pesan menos de 100 g son los que quedan más allá de \(-2\sigma\): alrededor del 2,3 %.
Las fábricas usan este cálculo para prever el porcentaje de defectuosos y decidir en qué valor poner el llenado medio (cuánto de más echar) para equilibrar las reclamaciones con el coste.
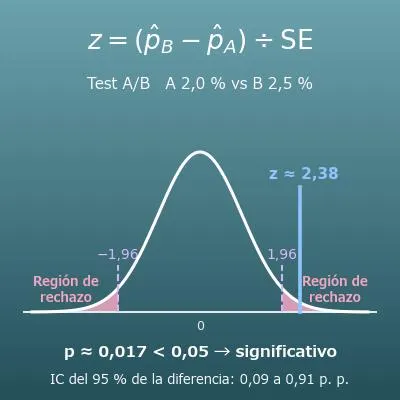
Cuando comparas si el diseño A o el B tiene mayor porcentaje de clics, usas la distribución normal (un intervalo de confianza) para decidir si la diferencia es casualidad o real.
La fila «0,95» de la tabla del resultado es justo el «intervalo de confianza del 95 %» que más se usa en la práctica. Detrás de decisiones que mueven mucho dinero, como los presupuestos de publicidad, este cálculo se usa a diario.
Los actuarios son los profesionales que calculan con probabilidades el riesgo de tener que pagar indemnizaciones y fijan con ello el precio de los seguros.
Un accidente concreto no se puede prever, pero el total de muchos asegurados se acerca a una distribución normal (el teorema central del límite), así que el total a pagar se prevé con sorprendente precisión. Gracias a estas matemáticas podemos tener una gran cobertura por una prima asequible.
Fórmula y gráfica
Símbolos y términos
Símbolos
| \(\mu\) | mu | La media. Es donde está el centro de la campana. Es una letra griega que corresponde a nuestra m. |
| \(\sigma\) | sigma | La desviación típica. Es el tamaño de la dispersión de los datos y fija la anchura de la campana. Cuanto mayor es, más baja y ancha es la campana. Es una letra griega que corresponde a nuestra s. |
| \(X\) | equis mayúscula (variable aleatoria) | Letra que representa una cantidad cuyo valor puede cambiar cada vez que la mides, como la nota de un examen o la estatura. En los libros se escribe \(X \sim N(\mu, \sigma)\). |
| \(\Phi\) | fi mayúscula | La función de distribución de la normal tipificada \(N(0, 1)\) (media 0, desviación típica 1). Da la probabilidad de obtener ese valor o uno menor; es lo que se lee en la tabla de la \(N(0, 1)\). |
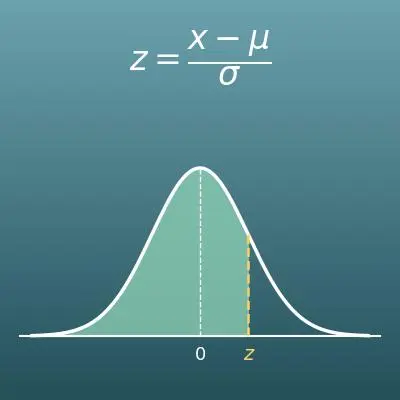
| \(z\) | zeta (puntuación z) | Número que indica a cuántas desviaciones típicas está un valor de la media. Se calcula con \(z = (x - \mu) \div \sigma\). |
| \(e\) | e (número e) | Una constante que vale más o menos 2,71828… y es la base de los logaritmos neperianos. Es un número especial en el que se basan las funciones exponenciales. |
| \(\pi\) | pi | Una constante que vale más o menos 3,14159… (la razón entre la longitud de una circunferencia y su diámetro). En la fórmula de la distribución normal aparece para que el área total bajo la curva sea exactamente 1. |
Términos
| distribución normal (campana de Gauss) | Distribución repartida de forma simétrica alrededor de la media, con forma de campana. Sirve de modelo para datos en los que los valores cercanos a la media son los más frecuentes y se vuelven más raros cuanto más se alejan, como la estatura, las notas de un examen o el peso de los productos. |
| desviación típica | Un número que indica cuánto se dispersan los datos. Dos grupos de datos pueden tener la misma media y dispersiones distintas. Cuanto mayor es la desviación típica, más baja y ancha es la campana de la distribución. |
| tipificación | Pasar un valor a «a cuántas desviaciones típicas está de la media» (la puntuación z). En otros textos se llama estandarización. Cualquier distribución normal, una vez tipificada, se maneja con una sola normal \(N(0, 1)\) de media 0 y desviación típica 1. El cociente intelectual usa la misma idea: CI \(= 100 + 15 \times z\). |
| función de distribución | Función que da la probabilidad de obtener ese valor o uno menor. La de la normal \(N(0, 1)\) se escribe \(\Phi\) (fi). La probabilidad de un intervalo es «\(\Phi\) hasta el límite superior» menos «\(\Phi\) hasta el límite inferior». |
| función de densidad | La fórmula de la propia curva de la distribución. La altura de la curva no es una probabilidad sino una densidad de probabilidad; la probabilidad es el área entre la curva y el eje horizontal en un intervalo. En la distribución normal es una curva en forma de campana. |
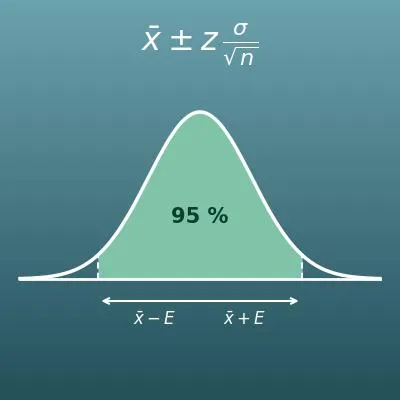
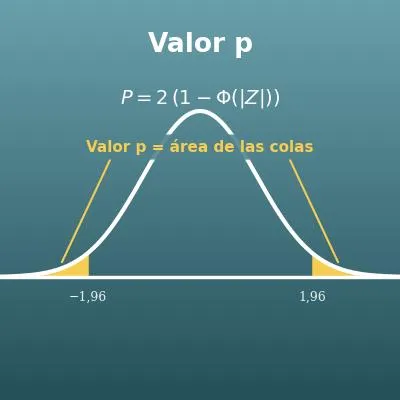
| intervalo de confianza | La tabla del resultado muestra, para cada porcentaje, el intervalo centrado en la media que contiene esa parte de toda la distribución (\(\mu \pm z \times \sigma\)) y su multiplicador \(z\). En sentido estricto, un «intervalo de confianza del 95 %» en estadística es un intervalo para el valor real (como la media de la población) estimado a partir de una muestra. Pero si se supone una distribución normal, usa la misma \(z\) (1,96 para el 95 %), así que los valores de \(z\) de esta tabla valen tal cual. Se usa mucho para calcular el «margen de error» de encuestas y análisis. |
| regla 68-95-99,7 | Una referencia práctica que conviene recordar: en una distribución normal, más o menos el 68,3 % de los datos queda dentro de la media \(\pm 1\sigma\), el 95,4 % dentro de \(\pm 2\sigma\) y el 99,7 % dentro de \(\pm 3\sigma\). |
| teorema central del límite | La propiedad matemática por la que una cantidad formada por muchos pequeños efectos al azar (una suma o una media) se acerca a una distribución normal, sea cual sea la distribución de partida. Es la razón de que tantos datos reales se parezcan a una distribución normal. |
Conviene saber antes de empezar
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo lo que hace, no solo pulsando el botón.
| La media (5.º-6.º de Primaria, 10-12 años) |
|
| Parámetros de dispersión y desviación típica (4.º de ESO a 1.º de Bachillerato, 15-17 años) |
|
| Proporciones vistas como áreas (6.º de Primaria a 2.º de ESO, 11-14 años) |
|
| Tipificación y puntuación z (Bachillerato, 16-18 años) |
|
Cómo calcularlo en Excel
| Media μ | 62 |
| Desviación típica σ | 14 |
| Límite inferior | 50 |
| Límite superior | 80 |
| Probabilidad entre los dos límites | =DISTR.NORM.N(B4;B1;B2;VERDADERO)-DISTR.NORM.N(B3;B1;B2;VERDADERO) |
| Media μ | 62 |
| Desviación típica σ | 14 |
| Valor (parte igual o por encima) | 80 |
| Probabilidad de ese valor o más | =1-DISTR.NORM.N(B3;B1;B2;VERDADERO) |
| Media μ | 62 |
| Desviación típica σ | 14 |
| Punto x | 80 |
| Altura de la curva en ese punto | =DISTR.NORM.N(B3;B1;B2;FALSO) |
La probabilidad de un intervalo es «la probabilidad del límite superior o menos» menos «la probabilidad del límite inferior o menos».
Si pones FALSO en el último argumento, en vez de una probabilidad obtienes la altura de la curva en ese punto (el valor de la función de densidad).
Al pegarla, la columna B tiene tus datos y la fórmula de la última fila se calcula sola. La primera tabla da unos 0,70 (un 70 %) y la segunda unos 0,10 (un 10 %, es decir, más o menos el 10 % de arriba).
Cómo calcularlo en Hojas de cálculo de Google
| Media μ | 62 |
| Desviación típica σ | 14 |
| Límite inferior | 50 |
| Límite superior | 80 |
| Probabilidad entre los dos límites | =DISTR.NORM(B4;B1;B2;VERDADERO)-DISTR.NORM(B3;B1;B2;VERDADERO) |
| Media μ | 62 |
| Desviación típica σ | 14 |
| Valor (parte igual o por encima) | 80 |
| Probabilidad de ese valor o más | =1-DISTR.NORM(B3;B1;B2;VERDADERO) |
| Media μ | 62 |
| Desviación típica σ | 14 |
| Punto x | 80 |
| Altura de la curva en ese punto | =DISTR.NORM(B3;B1;B2;FALSO) |
DISTR.NORM(x; media; desviación_estándar; VERDADERO) da la probabilidad de obtener x o menos, así que el valor del límite superior menos el del inferior es la probabilidad del intervalo.
Si pones FALSO en el último argumento, en vez de una probabilidad obtienes la altura de la curva en ese punto (la densidad de probabilidad).
Cómo calcularlo en Python
from statistics import NormalDist

mean = 62               # media
standard_deviation = 14 # desviación típica
lower_bound = 50        # límite inferior del intervalo
upper_bound = 80        # límite superior del intervalo

distribution = NormalDist(mean, standard_deviation)
p_between = distribution.cdf(upper_bound) - distribution.cdf(lower_bound)

print(f"Probabilidad entre {lower_bound} y {upper_bound}: {p_between}")
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
P(a ≤ X ≤ b) = Φ((b − μ)/σ) − Φ((a − μ)/σ)
P(a \le X \le b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>a</mi><mo>≤</mo><mi>X</mi><mo>≤</mo><mi>b</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>b</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
<mo>−</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>a</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
P(a <= X <= b) = Phi((b - mu)/sigma) - Phi((a - mu)/sigma)
CDF[NormalDistribution[mu, sigma], b] - CDF[NormalDistribution[mu, sigma], a]
with(Statistics): CDF(RandomVariable(Normal(mu, sigma)), b) - CDF(RandomVariable(Normal(mu, sigma)), a);
p = normcdf(b, mu, sigma) - normcdf(a, mu, sigma);
P(a ≤ X ≤ b) = Φ((b-μ)/σ) - Φ((a-μ)/σ)
f(x) = 1/(σ√(2π)) · e^(−(x − μ)²/(2σ²))
f(x) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac{(x-\mu)^2}{2\sigma^2}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mn>1</mn>
<mrow><mi>σ</mi><msqrt><mrow><mn>2</mn><mi>π</mi></mrow></msqrt></mrow>
</mfrac>
<msup>
<mi>e</mi>
<mrow>
<mo>−</mo>
<mfrac>
<msup><mrow><mo>(</mo><mi>x</mi><mo>−</mo><mi>μ</mi><mo>)</mo></mrow><mn>2</mn></msup>
<mrow><mn>2</mn><msup><mi>σ</mi><mn>2</mn></msup></mrow>
</mfrac>
</mrow>
</msup>
</mrow>
</math>
f(x) = 1/(sigma sqrt(2 pi)) e^(-(x - mu)^2 / (2 sigma^2))
PDF[NormalDistribution[mu, sigma], x]
with(Statistics): PDF(RandomVariable(Normal(mu, sigma)), x);
y = normpdf(x, mu, sigma);
f(x) = 1/(σ√(2π)) e^(-(x-μ)^2/(2σ^2))
Cómo pedirle el cálculo a ChatGPT
Eres un asistente de cálculo de probabilidades. Haz el siguiente cálculo ejecutando de verdad código de Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas calculando de cabeza ni a ojo).

Las notas de un examen puntuado sobre 100 siguen una distribución normal de media 62 y desviación típica 14.
Calcula cada uno de estos valores:
1. La probabilidad de que una nota esté entre 50 y 80
2. La probabilidad de que una nota sea 80 o más (qué porcentaje queda por encima)
3. La probabilidad de que una nota sea 50 o menos

Usa statistics.NormalDist de Python e indica el código que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los datosEscribe en las casillas los números con los que quieres calcular
-
2CalculaPulsa el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página tienes también la idea del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo
Sin necesidad de dar datos personales
Los archivos se borran automáticamente tras la descarga
Sin necesidad de atribución
Sin necesidad de pedir permiso
Funciones relacionadas
Probabilidad de dos sucesos independientes (y, o)
A partir de dos probabilidades, calcula la de que ocurran los dos, la de que ocurra al menos uno y más
Probabilidad de dos sucesos (calcular los valores que faltan)
A partir de las dos probabilidades que conoces, calcula todas las demás
Probabilidad de experimentos repetidos (n veces seguidas, al menos una vez)
Calcula la probabilidad de que algo ocurra n veces seguidas o al menos una vez en n intentos