
Escribe el tamaño de la muestra, la media muestral, la desviación típica y el nivel de confianza. Se calculan el intervalo de confianza para la media poblacional (extremos inferior y superior), el margen de error y una tabla con los niveles de confianza más usados.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmulas y gráficas
-
Símbolos y términos
-
Conviene saber antes de empezar
-
Cómo calcularlo en Excel
-
Cómo calcularlo en Hojas de cálculo de Google
-
Cómo calcularlo en Python
-
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
-
Cómo pedirle el cálculo a ChatGPT
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Lista de calculadoras de NumberChef
Qué puedes hacer en esta página
- Escribe el tamaño de la muestra \(n\), la media muestral \(\bar{x}\), la desviación típica \(\sigma\) y el nivel de confianza (%) y obtén al momento el intervalo de confianza para la media poblacional (sus extremos inferior y superior)
- Calcula a la vez el margen de error \(E\) (cuánto puede desviarse la estimación, por arriba o por abajo), el error típico y el valor crítico \(z_{\alpha/2}\) para el nivel de confianza
- Muestra en una tabla los intervalos de confianza para los niveles de confianza más usados (90 %, 95 %, 99 %…) y en una gráfica cómo se ensancha el intervalo
- En la misma página tienes la explicación sencilla de las fórmulas y las fórmulas listas para copiar en Excel, Hojas de cálculo de Google y Python
¿Para qué sirve este cálculo?
El «margen de error» de una encuesta como «un 45 % de intención de voto (margen de error ±2,5 puntos)» es justo el margen de error \(E\) de esta página. En una encuesta con un 45 % y 1600 entrevistas, la dispersión es \(\sigma = \sqrt{0{,}45 \times 0{,}55} \approx 0{,}497\), así que con un nivel de confianza del 95 %, \(E = 1{,}96 \times 0{,}497 \div \sqrt{1600} \approx 0{,}024\) (unos ±2,4 puntos). Esto supone que la proporción de respuestas se puede aproximar con una distribución normal. Los «±2,5 puntos» de las fichas técnicas suelen calcularse con el caso más desfavorable, el 50 %, donde la dispersión es máxima.
Así podrás juzgar por ti mismo si la noticia de que «un partido sube 1 punto» está dentro del margen de error.
Una fábrica no puede abrir y medir todas las botellas, así que revisa una muestra. Si 50 botellas de 500 mL tienen un contenido medio de 500,2 mL con una desviación típica de 2 mL, el intervalo de confianza del 95 % para el contenido medio de toda la producción va de unos 499,65 a 500,75 mL.
Comprobar estadísticamente, solo con inspecciones por muestreo, que los productos no están por debajo de la cantidad de la etiqueta es un cálculo que se hace a diario en la industria alimentaria, de bebidas y farmacéutica.
Los resultados de los artículos médicos casi siempre se dan con un intervalo de confianza, como «el nuevo fármaco bajó la tensión arterial 8,0 mmHg de media (intervalo de confianza del 95 %: 5,6 a 10,4)». En un estudio con 100 personas en el que las bajadas tienen una desviación típica de 12 mmHg, \(E = 1{,}96 \times 12 \div \sqrt{100} \approx 2{,}4\).
Si todo el intervalo queda en el lado positivo (no incluye el 0), es un argumento a favor de que «el fármaco tuvo efecto». Si el intervalo incluye el 0, hay que leerlo como «puede ser casualidad». Es una de las claves más importantes para valorar por ti mismo la información sobre salud.
Evaluar a todos los alumnos del país es una tarea enorme, así que muchos estudios nacionales e internacionales de rendimiento (como PISA) se hacen con muestras. Por ejemplo, si en una muestra de 400 alumnos el tiempo medio en 50 metros lisos es de 9,2 segundos con una desviación típica de 0,8 segundos, el intervalo de confianza del 95 % para el tiempo medio de todos los alumnos va de unos 9,12 a 9,28 segundos. Con solo 400 alumnos se obtiene un intervalo bastante estrecho.
Las estadísticas oficiales, como la Encuesta de Población Activa (EPA) del INE, de la que sale la tasa de paro, también se basan en muestras, y este cálculo respalda su precisión.
Si el tiempo medio en tu web sube de 180 a 184 segundos, ¿es efecto de tu cambio o pura casualidad? Con 2500 visitantes y una desviación típica de 90 segundos, el intervalo de confianza del 95 % para el tiempo medio va de unos 176,5 a 183,5 segundos, así que hay un margen de unos ±3,5 segundos.
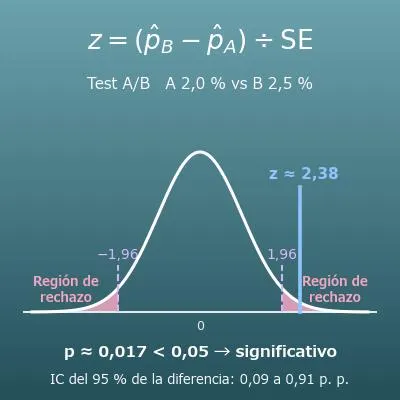
Si el cambio es más o menos del tamaño de la amplitud del intervalo de confianza, puedes concluir que «todavía no se distingue de la casualidad». Es la base para no malinterpretar los resultados de un test A/B.
Fórmulas y gráficas
Símbolos y términos
Símbolos
| \(n\) | ene | El tamaño de la muestra: cuántos elementos o personas has medido de verdad (por ejemplo, si mides 50 botellas, \(n = 50\)). |
| \(\bar{x}\) | equis barra | La media muestral, la media de la muestra que has medido. La barra de arriba es el signo de «media». |
| \(\sigma\) | sigma | La desviación típica de la población, el tamaño de la dispersión en toda la población. Es una letra griega que corresponde a nuestra s. Si la muestra es lo bastante grande, se puede usar la desviación típica de la muestra. |
| \(\sqrt{n}\) | raíz de ene | La raíz cuadrada del tamaño de la muestra (por ejemplo, \(\sqrt{25} = 5\)). Aparece en el denominador del error típico, y es la razón de que con 4 veces más datos el error solo se reduzca a la mitad. |
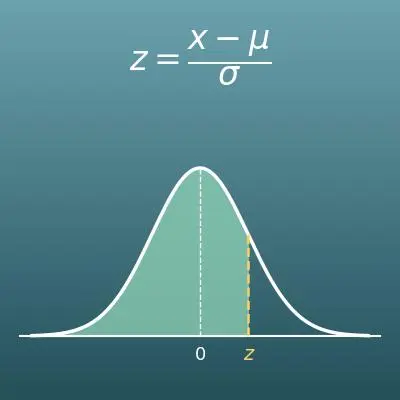
| \(z\) | zeta (valor crítico) | El multiplicador que fija el nivel de confianza. Es el límite de la distribución normal estándar que deja justo el nivel de confianza en el centro. Para el 95 % vale unos 1,96. En los libros de Bachillerato se escribe \(z_{\alpha/2}\). |
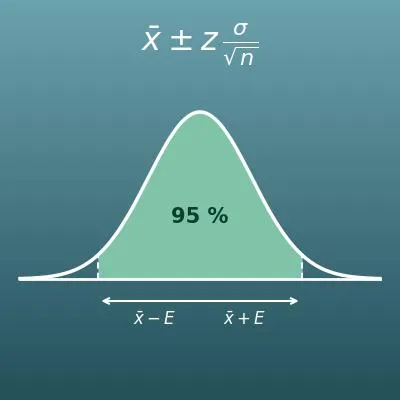
| \(E\) | e | El margen de error (error máximo admisible). Es la mitad de la amplitud del intervalo de confianza e indica cuánto puede alejarse, por arriba o por abajo, la media muestral de la media poblacional. La E es de «error». |
| \(L,\ U\) | ele, u | Los extremos inferior y superior del intervalo de confianza (las letras vienen del inglés lower y upper). Se calculan con \(L = \bar{x} - E\) y \(U = \bar{x} + E\). |
| \(\Phi^{-1}\) | fi a la menos uno (inversa de Φ) | La función que hace lo contrario que \(\Phi\), la función de distribución de la normal estándar: a partir de una probabilidad (un área) da la z correspondiente. (Por ejemplo, \(\Phi^{-1}(0{,}975) \approx 1{,}96\).) |
| \(C\) | ce | El nivel de confianza escrito en decimal. Para el 95 %, \(C = 0{,}95\). En Bachillerato es \(1 - \alpha\). |
Términos
| intervalo de confianza | Intervalo estimado con los datos de una muestra en el que probablemente está la media poblacional. Se construye ampliando la media muestral hacia arriba y hacia abajo en el margen de error. |
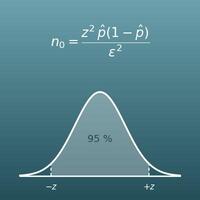
| nivel de confianza | Cuánta confianza se puede tener en el intervalo. Es la proporción de intervalos que contendrían la media poblacional si se construyeran muchas veces del mismo modo. El más usado es el 95 %. Se escribe \(1 - \alpha\) (con \(\alpha\) el nivel de significación). |
| población | El conjunto completo que de verdad quieres estudiar (por ejemplo, todas las botellas que fabrica una planta o todos los votantes del país). |
| muestra | La parte de la población que de verdad seleccionas y estudias. Deducir cómo es la población a partir de una muestra es de lo que trata la inferencia estadística. |
| media poblacional | La media de toda la población. Como no se puede medir todo, su valor exacto no se conoce; el intervalo de confianza estima dónde está. Se suele escribir \(\mu\) (mu). |
| media muestral | La media de la muestra, \(\bar{x}\). Es la estimación de un solo valor más razonable de la media poblacional (estimación puntual), pero cambia un poco cada vez según la muestra que te toque. |
| error típico (error estándar) | Lo que varía la propia media muestral; se calcula con \(\sigma \div \sqrt{n}\). Es fácil confundirlo con la dispersión de cada dato (la desviación típica), así que ten cuidado. |
| estimación por intervalos | Forma de estimar un valor desconocido, como la media poblacional, con un intervalo en lugar de un solo número. Frente a la estimación puntual, tiene la ventaja de mostrar también cuánto se puede equivocar. |
| distribución t de Student | La distribución que se usa en lugar de la normal (z) cuando la muestra es pequeña y no se conoce la desviación típica de la población. La calculadora de esta página solo usa z. Cuanto más grande es la muestra, más se parece la t de Student a la normal y los resultados son casi iguales. |
Conviene saber antes de empezar
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo lo que hace, no solo pulsando el botón.
| La media (5.º-6.º de Primaria, 10-12 años) |
|
| Raíces cuadradas (1.º-2.º de ESO, 12-14 años) |
|
| Población y muestra (2.º-4.º de ESO, 13-16 años) |
|
| Parámetros de dispersión y desviación típica (4.º de ESO a 1.º de Bachillerato, 15-17 años) |
|
| La distribución normal y la estimación por intervalos (2.º de Bachillerato, 17-18 años) |
|
Cómo calcularlo en Excel
| Confianza (%) | 95 |
| z | =INV.NORM.ESTAND((1+B1/100)/2) |
| z | 1,96 |
| Desv. típica σ | 2 |
| Tamaño de la muestra n | 25 |
| Margen de error E | =B1*B2/RAIZ(B3) |
| Tamaño de la muestra n | 50 |
| Media muestral x̄ | 500,2 |
| Desv. típica σ | 2 |
| Confianza (%) | 95 |
| z | =INV.NORM.ESTAND((1+B4/100)/2) |
| Margen de error E | =B5*B3/RAIZ(B1) |
| Extremo inferior | =B2-B6 |
| Extremo superior | =B2+B6 |
La primera tabla calcula z solo con el nivel de confianza (B1); con 95, B2 da unos 1,959964. La segunda es el margen de error; con los valores del ejemplo, B4 da 0,784.
La tercera calcula el intervalo de confianza con todos los datos a la vez. Con los valores del ejemplo (n = 50, x̄ = 500,2, σ = 2, 95 %), el extremo inferior (B7) es de unos 499,6456 y el superior (B8), de unos 500,7544. Solo tienes que cambiar B1 a B4 por tus números.
Cómo calcularlo en Hojas de cálculo de Google
| Confianza (%) | 95 |
| z | =DISTR.NORM.ESTAND.INV((1+B1/100)/2) |
| z | 1,96 |
| Desv. típica σ | 2 |
| Tamaño de la muestra n | 25 |
| Margen de error E | =B1*B2/RAIZ(B3) |
| Tamaño de la muestra n | 50 |
| Media muestral x̄ | 500,2 |
| Desv. típica σ | 2 |
| Confianza (%) | 95 |
| z | =DISTR.NORM.ESTAND.INV((1+B4/100)/2) |
| Margen de error E | =B5*B3/RAIZ(B1) |
| Extremo inferior | =B2-B6 |
| Extremo superior | =B2+B6 |
Copia la tabla entera, pégala en la celda A1 y cambia los números de la columna B por los tuyos. Los resultados son los mismos que en Excel: en la tercera tabla, el extremo inferior es de unos 499,6456 y el superior, de unos 500,7544.
Cómo calcularlo en Python
import math
from statistics import NormalDist

sample_size = 50        # tamaño de la muestra n
sample_mean = 500.2     # media muestral x̄
sd = 2                  # desviación típica σ
confidence_level = 95   # nivel de confianza (%)

z = NormalDist().inv_cdf((1 + confidence_level / 100) / 2)  # valor crítico z para el nivel de confianza
standard_error = sd / math.sqrt(sample_size)                # error típico σ ÷ √n
margin_of_error = z * standard_error                        # margen de error E
lower = sample_mean - margin_of_error                       # extremo inferior del intervalo de confianza
upper = sample_mean + margin_of_error                       # extremo superior del intervalo de confianza

print(f"z: {z}")
print(f"Margen de error E: {margin_of_error}")
print(f"Intervalo de confianza del {confidence_level} %: de {lower} a {upper}")
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
E = z × σ ÷ √n
E = z \times \dfrac{\sigma}{\sqrt{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi>
<mo>=</mo>
<mi>z</mi>
<mo>×</mo>
<mfrac>
<mi>σ</mi>
<msqrt><mi>n</mi></msqrt>
</mfrac>
</mrow>
</math>
E = z sigma / sqrt(n)
z*sigma/Sqrt[n]
E := z*sigma/sqrt(n);
E = z*sigma/sqrt(n);
E = zσ/√n
L = x̄ − E, U = x̄ + E
L = \bar{x} - E,\quad U = \bar{x} + E
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>L</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>−</mo>
<mi>E</mi>
<mo>,</mo>
<mspace width="1em"/>
<mi>U</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>+</mo>
<mi>E</mi>
</mrow>
</math>
L = bar x - E, U = bar x + E
{xbar - e, xbar + e}
L := xbar - E; U := xbar + E;
L = xbar - E; U = xbar + E;
L = x̄ - E, U = x̄ + E
z = Φ⁻¹((1 + C) ÷ 2)
z = \Phi^{-1}\!\left(\dfrac{1+C}{2}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<msup><mi>Φ</mi><mrow><mo>−</mo><mn>1</mn></mrow></msup>
<mrow>
<mo>(</mo>
<mfrac>
<mrow><mn>1</mn><mo>+</mo><mi>C</mi></mrow>
<mn>2</mn>
</mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
z = Phi^-1((1 + C)/2)
InverseCDF[NormalDistribution[0, 1], (1 + c)/2]
with(Statistics): Quantile(RandomVariable(Normal(0, 1)), (1 + c)/2);
z = norminv((1 + c)/2);
z = Φ^(-1)((1+C)/2)
Cómo pedirle el cálculo a ChatGPT
Eres un asistente de cálculo estadístico. Haz el siguiente cálculo ejecutando de verdad código de Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas calculando de cabeza ni a ojo).

Se han sacado 50 botellas de la línea de una fábrica y se ha medido su contenido. La media ha sido de 500,2 mL. Se sabe que la desviación típica del llenado (la de la población) es de 2 mL.
1. Calcula el valor crítico z para un nivel de confianza del 95 % (usa la inversa de la función de distribución de la normal estándar; puedes usar statistics.NormalDist().inv_cdf de la biblioteca estándar de Python).
2. Calcula el margen de error E = z × σ ÷ √n.
3. Calcula el intervalo de confianza del 95 % (extremos inferior y superior) para la media poblacional (el contenido medio real de todas las botellas).

Indica las fórmulas que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los datosEscribe en las casillas los números con los que quieres calcular
-
2CalculaPulsa el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página tienes también la idea del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo
Sin necesidad de dar datos personales
Los archivos se borran automáticamente tras la descarga
Sin necesidad de atribución
Sin necesidad de pedir permiso
Funciones relacionadas
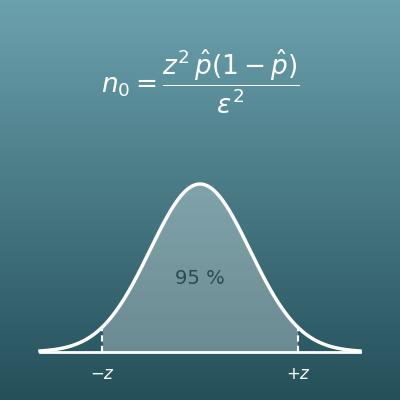
Calculadora del tamaño de la muestra y del margen de error
Con el margen de error que aceptas y el nivel de confianza, calcula el tamaño de muestra que necesita una encuesta
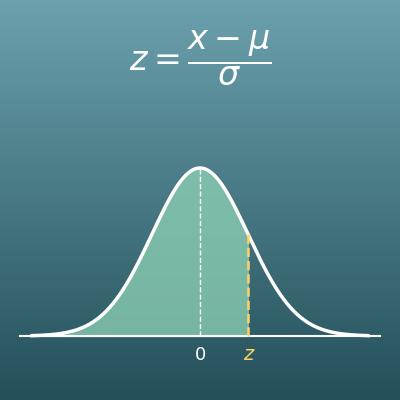
Calculadora de la puntuación z (tipificación y paso de z a probabilidad y al revés)
Calcula la puntuación z (tipificada) a partir de un valor, la media y la desviación típica, y pásala a probabilidad y al revés
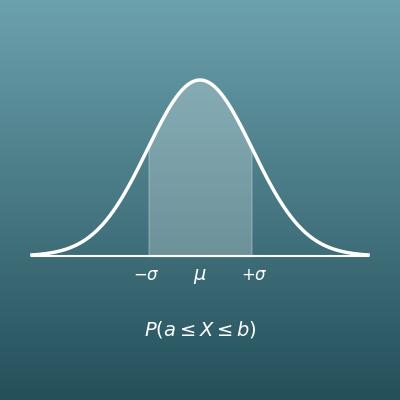
Calculadora de probabilidades de la distribución normal
Con la media y la desviación típica, calcula la probabilidad de caer en un intervalo