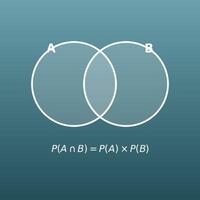































































































































請選擇要計算的內容,並輸入機率。下方的數學式與輸入欄連動,直接修改式子裡的數字也能計算。
這個頁面可以做什麼
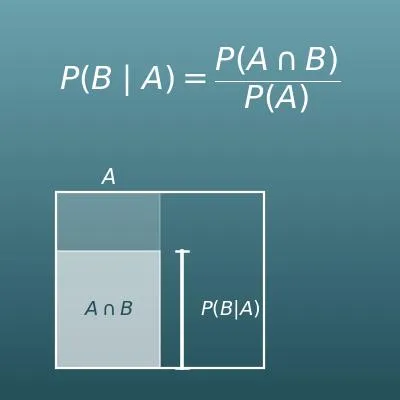
- 只要輸入 \(P(A)\) 和 \(P(A \cap B)\),馬上就能求出條件機率 \(P(B \mid A) = \dfrac{P(A \cap B)}{P(A)}\)
- 在貝氏定理模式中,可以由原因的機率 \(P(A)\),以及有、無原因時結果 B 各自發生的機率 \(P(B \mid A)\)、\(P(B \mid A')\),反推出「結果 B 發生時,原因是 A 的機率 \(P(A \mid B)\)」
- 用全機率定理組出 \(P(B)\) 的過程,可以透過代入數值的計算過程與樹狀圖、面積圖確認
- 答案會同時以 \(\dfrac{10}{109}\) 這樣約分後的最簡分數(精確值),以及小數與百分率顯示
- 機率可以用 0.3、30%、3/10 任一種形式輸入。另附公式的淺顯解說,以及可直接複製到 Excel、Google 試算表、Python 使用的公式
這個計算有什麼用?
聽到「準確度 90% 的檢查呈陽性」,會覺得有 90% 的機率符合;但如果假設全體中只有 1% 的人符合來計算,呈陽性時真的符合的機率(陽性預測值)只有約 9%。這是因為少數「真正的陽性」,被大量不符合的人當中出現的「偽陽性」淹沒了。
這是貝氏定理最有名的例子,在醫療現場,「檢查結果要和事前機率一起解讀」也是基本原則。(實際的機率依檢查與情況而不同,這裡的數值只是計算範例。)
電子郵件軟體判斷垃圾郵件的經典基礎,是由「這個詞出現在垃圾郵件中的機率」和「出現在一般郵件中的機率」,用貝氏定理反推「含有這個詞的郵件是垃圾郵件的機率」的機制(貝氏過濾器)。
由「原因(垃圾郵件)→結果(詞的出現)」的統計推估「結果→原因」,是貝氏定理教科書般的應用。
在一間由機器 X 生產 6 成產品(不良率 2%)、機器 Y 生產 4 成產品(不良率 5%)的工廠,檢驗時發現的不良品來自機器 X 的機率,可以用貝氏定理算出 \(\dfrac{0.6 \times 0.02}{0.6 \times 0.02 + 0.4 \times 0.05} = \dfrac{3}{8}\)(37.5%)。
「發現不良品時,應該先檢查哪條產線」這種現場的優先順序,就能用數字而不是憑直覺來決定。
從 10 支中有 3 支中獎的籤中不放回地抽 2 支,2 支都中獎的機率是 \(\dfrac{3}{10} \times \dfrac{2}{9} = \dfrac{1}{15}\)。第 1 支的結果會改變第 2 支的機率(不獨立),所以要用條件機率和乘法定理。
玩撲克牌或其他紙牌遊戲時,根據「已經翻開的牌」思考剩下牌堆的機率,也是完全相同的計算。
訂定汽車保險的保費時,不會把「發生事故的機率」看成所有人都一樣,而是依年齡、駕駛經歷、居住地區等條件,估計成各條件下的條件機率,再反映在不同的保費上。
「知道條件後機率就會改變」這個條件機率的概念,正是支撐保險、貸款審核、信用評分等金融機制的基礎。
公式與圖示
符號與用語解說
符號
| \(P(A)\) | P of A | 事件 A 發生的機率。P 是英文「機率」Probability 的第一個字母。 |
| \(P(B \mid A)\) | P of B given A | 已知 A 發生時,B 發生的機率(條件機率)。讀作「在 A 發生的條件下 B 發生的機率」。日本等地的教科書也會寫成 \(P_{A}(B)\),把條件寫在右下角。 |
| \(\mid\) | given(在…的條件下) | 寫在 \(P(\ \ )\) 裡面的直線。直線右邊的事件是條件(已知發生的事),讀作「在…的條件下」。\(P(B \mid A)\) 和 \(P(A \mid B)\) 的意思不同。 |
| \(A'\) | A prime(餘事件) | 表示「A 不發生」這個事件(餘事件),也寫成 \(A^c\) 或 \(\overline{A}\)。可用 \(P(A') = 1 - P(A)\) 求出。 |
| \(\cap\) | 交集 | 表示「且」的符號。\(A \cap B\) 是「A 與 B 都發生」這個事件,在文氏圖中就是兩個圓重疊的部分。 |
| \(P(A \cap B)\) | A 交集 B 的機率 | A 與 B 都發生的機率(聯合機率),是條件機率的分子。它一定小於或等於 \(P(A)\)(因為兩個都發生是 A 的一部分)。 |
用語
| 事件 | 像「擲骰子擲出偶數」「檢查呈陽性」這樣,會發生或不會發生的事情。數學上把這種事情稱為「事件」,並取 A、B 等名稱來處理。 |
| 條件機率 | 在已知某個事件 A 發生的條件下,另一個事件 B 發生的機率。計算方式為 \(P(B \mid A) = \dfrac{P(A \cap B)}{P(A)}\),也就是「把思考的範圍從全體縮小到只剩 A 時,B 所占的比例」。 |
| 乘法定理 | 指 \(P(A \cap B) = P(A) \times P(B \mid A)\),也稱為機率的乘法公式。是把條件機率公式去分母的形式,依序相乘求出「先發生 A,接著 B 也發生」的機率。 |
| 全機率定理 | 把 B 發生的機率分成「經過 A 的路徑」和「經過非 A 的路徑」再相加的定理,台灣的高中教科書也稱為分割定理。公式是 \(P(B) = P(A)\,P(B \mid A) + P(A')\,P(B \mid A')\),用來組出貝氏定理的分母。 |
| 貝氏定理 | 由「原因→結果」的機率反推「結果→原因」的機率的定理。公式是 \(P(A \mid B) = \dfrac{P(A \cap B)}{P(B)}\)。名稱來自 18 世紀英國的牧師湯瑪斯·貝葉斯(Thomas Bayes),支撐著垃圾郵件過濾等現代資訊技術。 |
| 事前機率 | 看到結果(資料)之前估計的原因 A 的機率 \(P(A)\)。以檢查的例子來說,就是「全體中原本有多少人符合條件」。 |
| 事後機率 | 看到結果 B 之後更新的原因 A 的機率 \(P(A \mid B)\)。貝氏定理可以說是「用觀察到的結果,把事前機率更新成事後機率」的定理。 |
| 餘事件 | 指該事件「不發生」這個相反的事件。符號是 \(A'\),機率是 \(1 - P(A)\)。在全機率定理中負責「不經過 A 的路徑」。 |
| 互斥 | 兩個事件不會同時發生。「經過 A 而發生 B」和「經過非 A 而發生 B」是互斥的,所以在全機率定理中可以直接相加。 |
| 獨立 | 一方的結果不會影響另一方發生的機率。用條件機率的說法,就是「\(P(B \mid A) = P(B)\)(即使知道 A 發生了,B 的機率也不變)」。 |
| 偽陽性 | 實際上並不符合,檢查卻顯示「陽性(符合)」。即使偽陽性的機率很小,只要不符合的人占絕大多數,偽陽性的人數就可能比真正陽性的人還多。 |
| 樹狀圖 | 把可能發生的情況像樹枝一樣分開畫出的圖。在枝上寫上機率,沿著枝相乘就得到「這條路徑的機率」。是最適合用眼睛追蹤條件機率、貝氏定理計算的圖。 |
建議先了解的基礎知識
為了讓您「真正理解意義」地使用這個頁面的計算,這裡整理了建議事先理解的基礎知識。
遇到卡關時,回頭複習這張表的內容是最快的捷徑。
| 機率的基礎(國中九年級,14~15 歲) |
|
| 比率與百分率(國小五年級,10~11 歲) |
|
| 分數的乘法與除法(國小五~六年級,10~12 歲) |
|
| 排列組合與樹狀圖(國中九年級~高一,14~16 歲) |
|
| 集合與文氏圖(高一,15~16 歲) |
|
用 Excel 計算的方法
| 事件 A 發生的機率 P(A) | 0.5 |
| 兩個都發生的機率 P(A∩B) | 0.2 |
| 條件機率 P(B|A) | =B2/B1 |
| 事件 A 發生的機率 P(A) | 0.5 |
| A 發生時 B 發生的機率 P(B|A) | 0.4 |
| 兩個都發生的機率 P(A∩B) | =B1*B2 |
| 原因 A 的機率 P(A) | 0.01 |
| A 發生時 B 發生的機率 P(B|A) | 0.9 |
| A 不發生時 B 發生的機率 P(B|A') | 0.09 |
| B 發生的機率 P(B) | =B1*B2+(1-B1)*B3 |
| 原因 A 的機率 P(A) | 0.01 |
| A 發生時 B 發生的機率 P(B|A) | 0.9 |
| A 不發生時 B 發生的機率 P(B|A') | 0.09 |
| 兩個都發生的機率 P(A∩B) | =B1*B2 |
| B 發生的機率 P(B) | =B4+(1-B1)*B3 |
| B 發生時原因是 A 的機率 P(A|B) | =B4/B5 |
公式中的「B1」「B2」代表「使用該儲存格裡的數值」,「*」是乘法、「/」是除法的符號。
第 1 個表格是 0.2 ÷ 0.5 = 0.4,第 2 個表格是 0.5 × 0.4 = 0.2。
第 3 個表格是 0.01 × 0.9 + 0.99 × 0.09 = 0.0981,也就是把呈陽性的機率依路徑相加。
第 4 個表格中,B4 是 0.009,B5 是 0.0981,最後的 B6 是 0.009 ÷ 0.0981 ≈ 0.0917(約 9.2%)。
用 Google 試算表計算的方法
| 事件 A 發生的機率 P(A) | 0.5 |
| 兩個都發生的機率 P(A∩B) | 0.2 |
| 條件機率 P(B|A) | =B2/B1 |
| 事件 A 發生的機率 P(A) | 0.5 |
| A 發生時 B 發生的機率 P(B|A) | 0.4 |
| 兩個都發生的機率 P(A∩B) | =B1*B2 |
| 原因 A 的機率 P(A) | 0.01 |
| A 發生時 B 發生的機率 P(B|A) | 0.9 |
| A 不發生時 B 發生的機率 P(B|A') | 0.09 |
| B 發生的機率 P(B) | =B1*B2+(1-B1)*B3 |
| 原因 A 的機率 P(A) | 0.01 |
| A 發生時 B 發生的機率 P(B|A) | 0.9 |
| A 不發生時 B 發生的機率 P(B|A') | 0.09 |
| 兩個都發生的機率 P(A∩B) | =B1*B2 |
| B 發生的機率 P(B) | =B4+(1-B1)*B3 |
| B 發生時原因是 A 的機率 P(A|B) | =B4/B5 |
只要把輸入欄的數值改成自己的機率,就能直接使用。
用 Python 計算的方法
from fractions import Fraction

# ===== 條件機率 P(B|A) = P(A∩B) ÷ P(A) =====
p_a = Fraction(1, 2)          # P(A):作為前提的事件 A 的機率
p_a_and_b = Fraction(1, 3)    # P(A∩B):兩個都發生的機率
p_b_given_a = p_a_and_b / p_a
print(f"條件機率 P(B|A):{p_b_given_a} = {float(p_b_given_a):.4f}")

# ===== 貝氏定理(用全機率定理組出分母) =====
prior = Fraction(1, 100)             # P(A):原因 A 的機率(事前機率)
p_b_given_a2 = Fraction(90, 100)     # P(B|A):A 發生時 B 發生的機率
p_b_given_not_a = Fraction(9, 100)   # P(B|A'):A 不發生時 B 發生的機率

p_joint = prior * p_b_given_a2                    # P(A∩B)
p_b = p_joint + (1 - prior) * p_b_given_not_a     # P(B)(全機率定理)
posterior = p_joint / p_b                         # P(A|B)(事後機率)
print(f"B 發生的機率 P(B):{p_b} = {float(p_b):.4f}")
print(f"原因是 A 的機率 P(A|B):{posterior} = {float(posterior):.4f}")
用 LaTeX 等數學式語言的寫法(可直接複製)
P(B|A) = P(A∩B) / P(A)
P(B \mid A) = \dfrac{P(A \cap B)}{P(A)}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>B</mi><mo>∣</mo><mi>A</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mrow><mi>P</mi><mo>(</mo><mi>A</mi><mo>∩</mo><mi>B</mi><mo>)</mo></mrow>
<mrow><mi>P</mi><mo>(</mo><mi>A</mi><mo>)</mo></mrow>
</mfrac>
</mrow>
</math>
P(B | A) = P(A nn B) / P(A)
pAandB/pA
pBgivenA := pAandB/pA;
p_b_given_a = p_a_and_b/p_a;
P(B|A) = P(A∩B)/P(A)
P(A∩B) = P(A) × P(B|A)
P(A \cap B) = P(A) \times P(B \mid A)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>A</mi><mo>∩</mo><mi>B</mi><mo>)</mo>
<mo>=</mo>
<mi>P</mi><mo>(</mo><mi>A</mi><mo>)</mo>
<mo>×</mo>
<mi>P</mi><mo>(</mo><mi>B</mi><mo>∣</mo><mi>A</mi><mo>)</mo>
</mrow>
</math>
P(A nn B) = P(A) xx P(B | A)
pA*pBgivenA
pAandB := pA*pBgivenA;
p_a_and_b = p_a*p_b_given_a;
P(A∩B) = P(A) × P(B|A)
P(B) = P(A) × P(B|A) + P(A′) × P(B|A′)
P(B) = P(A)\,P(B \mid A) + P(A')\,P(B \mid A')
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>B</mi><mo>)</mo>
<mo>=</mo>
<mi>P</mi><mo>(</mo><mi>A</mi><mo>)</mo>
<mi>P</mi><mo>(</mo><mi>B</mi><mo>∣</mo><mi>A</mi><mo>)</mo>
<mo>+</mo>
<mi>P</mi><mo>(</mo>
<msup><mi>A</mi><mo>′</mo></msup>
<mo>)</mo>
<mi>P</mi><mo>(</mo><mi>B</mi><mo>∣</mo>
<msup><mi>A</mi><mo>′</mo></msup>
<mo>)</mo>
</mrow>
</math>
P(B) = P(A) xx P(B | A) + P(A') xx P(B | A')
pA*pBgivenA + (1 - pA)*pBgivenNotA
pB := pA*pBgivenA + (1 - pA)*pBgivenNotA;
p_b = p_a*p_b_given_a + (1 - p_a)*p_b_given_not_a;
P(B) = P(A)P(B|A) + P(A′)P(B|A′)
P(A|B) = P(A∩B) / P(B)
P(A \mid B) = \dfrac{P(A \cap B)}{P(B)} = \dfrac{P(A)\,P(B \mid A)}{P(A)\,P(B \mid A) + P(A')\,P(B \mid A')}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>A</mi><mo>∣</mo><mi>B</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mrow><mi>P</mi><mo>(</mo><mi>A</mi><mo>∩</mo><mi>B</mi><mo>)</mo></mrow>
<mrow><mi>P</mi><mo>(</mo><mi>B</mi><mo>)</mo></mrow>
</mfrac>
</mrow>
</math>
P(A | B) = P(A nn B) / P(B)
pA*pBgivenA/(pA*pBgivenA + (1 - pA)*pBgivenNotA)
pAgivenB := pAandB/pB;
p_a_given_b = p_a_and_b/p_b;
P(A|B) = P(A∩B)/P(B)
請 ChatGPT 幫忙計算的方法
你是機率(條件機率、貝氏定理)計算的助理。請務必實際執行 Python 程式碼來進行下列計算,並只以執行結果的數值作為回答的依據(請不要用心算或猜測回答)。

原因 A 的機率(事前機率)是 1%,A 發生時結果 B 發生的機率 P(B|A) 是 90%,A 不發生時 B 發生的機率 P(B|A') 是 9%。
請分別求出下列各值。
1. A 與 B 都發生的機率 P(A∩B)
2. B 發生的機率 P(B)(使用全機率定理,並列出各路徑的明細)
3. B 發生時原因是 A 的機率 P(A|B)(貝氏定理。請同時以最簡分數和小數表示)

在 Python 中請使用標準函式庫的 fractions 模組精確計算,並以表格列出計算時使用的公式與執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
兩個獨立事件的機率(交集、聯集、至少一個發生)
由兩個機率一次算出「兩個都發生」「至少一個發生」等機率
重複試驗的機率(連續 n 次、至少 1 次)
計算連續 n 次都發生的機率,以及 n 次中至少發生 1 次的機率