






























































































































請用逗號(,)分隔,輸入想知道分散程度的數值。會一次算出母體標準差 σ 與樣本標準差 s,以及平均數、變異數與離均差平方和。
這個頁面可以做什麼
- 只要用逗號(,)分隔輸入數值,馬上就能知道標準差
- 同時顯示母體標準差 \(\sigma\)(除以 \(N\))與樣本標準差 \(s\)(除以 \(N-1\))
- 平均數 \(\mu\)、離均差平方和 \(\sum (x_i-\mu)^2\)、變異數 \(\sigma^2,\ s^2\) 也會一起算出來,計算的每個步驟一目瞭然
- 這個頁面還整理了公式的淺顯解說,以及可直接複製到 Excel、Google 試算表、Python 使用的公式
這個計算有什麼用?
標準分數 z 表示某個分數離平均數有幾個標準差:\(z = \dfrac{x - \text{平均數}}{\text{標準差}}\),標準差就直接放在分母。
假設全班平均 70 分、標準差 10 分,考 85 分的人 \(z = (85 - 70) \div 10 = 1.5\),也就是比平均高 1.5 個標準差。心理測驗等常用的 T 分數(\(T = 50 + 10z\),這個例子是 65)也是同樣的概念。懂得標準差,就能明白為什麼同樣的分數,在大家分數很集中(分散程度小)的考試裡會更突出。
螺絲的長度、零件的重量,不論做得多精密,都會有些微的差異。工廠會用標準差來衡量這種差異,並管理製程,讓「平均數 ± 3 個標準差」落在客戶的規格內。
標準差越小,代表產品越一致、品質越好。標準差是非常基本的指標,甚至可以說,改善品質就是讓標準差越來越小的過程。
兩個投資標的的「平均報酬率」都是 5%,但報酬率標準差較大的那一個,有些年大賺、有些年大賠,會被判斷為風險較高。
在金融領域,報酬率的標準差稱為「波動度」,是最具代表性的風險指標;台灣的基金資料也常列出「年化標準差」。做重要的理財決定時,不要只看平均,也要一起看標準差,也就是分散程度。
即使兩個城市的年平均氣溫相同,每月氣溫標準差較小的城市一年四季都很溫和,較大的城市則夏天和冬天差很多。
標準差能把只看平均看不出來的「穩定還是變化大」化為數字,也用於比較氣候,以及規劃農作物與觀光。
健康檢查的抽血報告上標示的「參考值」範圍,有時是收集許多健康的人的資料,再以平均數與標準差為依據,取「平均數 ± 2 個標準差」左右的範圍來訂定(實際上各檢驗項目會依資料分散的型態採用適合的方法)。
知道標準差的意義之後,就比較能冷靜看待:「稍微超出參考值」不等於「馬上就是生病」,而是「健康的人也有一部分會落在範圍外」。
公式與圖示
符號與用語解說
符號
| \(x_1, x_2, \ldots, x_N\) | x 下標 1、x 下標 2、…、x 下標 N | 想知道分散程度的每一筆資料。(例:8 個人的考試分數) |
| \(N\) | N | 資料的個數。(例:8 個人的資料就是 \(N = 8\)) |
| \(\mu\) | mu | 平均數。表示母體平均數的希臘字母。樣本平均數寫成 \(\bar{x}\)(讀作 x bar),計算方法相同。 |
| \(x_i - \mu\) | x 下標 i 減 mu | 離均差。表示每筆資料離平均數有多遠(偏離多少)。 |
| \(S\) | S | 離均差平方和。把每個離均差平方後全部相加的值 \(\sum (x_i-\mu)^2\),是計算變異數與標準差的材料。 |
| \(\sigma^2\) | sigma 平方 | 母體變異數。把離均差平方和除以個數 \(N\) 的值。 |
| \(\sigma\) | sigma | 母體標準差。母體變異數的平方根,是表示分散程度最具代表性的符號。 |
| \(s^2\) | s 平方 | 樣本變異數(不偏變異數)。把離均差平方和除以 \(N-1\) 的值。 |
| \(s\) | s | 樣本標準差。樣本變異數的平方根。 |
| \(\sum\) | sigma(連加符號) | 表示「全部加起來」的符號。\(\sum_{i=1}^{N} x_i\) 表示從 \(x_1\) 到 \(x_N\) 的總和。 |
用語
| 標準差 | 表示資料在平均數周圍分散程度的值。它是變異數的平方根,單位和資料相同,很適合當作「離平均數的一般距離」的參考,是最具代表性的分散程度指標。 |
| 變異數 | 把離均差(每筆資料與平均數的差)平方後再平均的值。它表示分散程度的大小,但單位變成平方,所以一般會開根號,換成標準差來使用。 |
| 離均差 | 每筆資料與平均數的差(\(x_i - \mu\))。正數表示比平均數大,負數表示比平均數小。直接全部相加會等於 0,所以要先平方再使用。 |
| 離均差平方和 | 把離均差平方後全部相加的值。變異數與標準差都是由這個值算出來的。 |
| 母體 | 想調查的對象全體。如果手上的資料就是這個全體,請用母體標準差 \(\sigma\)。 |
| 樣本 | 從母體(全體)中抽出的一部分資料。要用樣本推估全體的分散程度時,請用樣本標準差 \(s\)。 |
| 不偏變異數 | 用樣本推估母體變異數時使用的變異數,是把離均差平方和除以 \(N-1\)。除以 \(N\) 會把母體的分散程度估得偏小,所以改除以少 1 的數來修正。 |
| 貝索校正 | 計算樣本變異數時,除以 \(N-1\) 而不是 \(N\) 的修正方法。\(N-1\) 也稱為自由度。 |
建議先了解的基礎知識
為了讓您「真正理解意義」地使用這個頁面的計算,這裡整理了建議事先理解的基礎知識。
| 平均數(國小高年級、國中七年級) |
|
| 正負數與括號的計算(國中七年級,12~13 歲) |
|
| 指數(國中七年級,12~13 歲) |
|
| 平方根(國中八年級,13~14 歲) |
|
| 資料的整理與分散程度(國中~高一「一維數據分析」,15~16 歲) |
|
用 Excel 計算的方法
| 第 1 個數 | 10 |
| 第 2 個數 | 12 |
| 第 3 個數 | 23 |
| 第 4 個數 | 23 |
| 第 5 個數 | 16 |
| 第 6 個數 | 23 |
| 第 7 個數 | 21 |
| 第 8 個數 | 16 |
| 個數 N | =COUNT(B1:B8) |
| 總和 Σx | =SUM(B1:B8) |
| 平均數 μ | =AVERAGE(B1:B8) |
| 第 1 個數 | 10 |
| 第 2 個數 | 12 |
| 第 3 個數 | 23 |
| 第 4 個數 | 23 |
| 第 5 個數 | 16 |
| 第 6 個數 | 23 |
| 第 7 個數 | 21 |
| 第 8 個數 | 16 |
| 離均差平方和 S | =DEVSQ(B1:B8) |
| 第 1 個數 | 10 |
| 第 2 個數 | 12 |
| 第 3 個數 | 23 |
| 第 4 個數 | 23 |
| 第 5 個數 | 16 |
| 第 6 個數 | 23 |
| 第 7 個數 | 21 |
| 第 8 個數 | 16 |
| 母體變異數 σ² | =VARP(B1:B8) |
| 母體標準差 σ | =STDEVP(B1:B8) |
| 第 1 個數 | 10 |
| 第 2 個數 | 12 |
| 第 3 個數 | 23 |
| 第 4 個數 | 23 |
| 第 5 個數 | 16 |
| 第 6 個數 | 23 |
| 第 7 個數 | 21 |
| 第 8 個數 | 16 |
| 樣本變異數 s² | =VAR(B1:B8) |
| 樣本標準差 s | =STDEV(B1:B8) |
第 1 個表格的平均數 μ 會顯示 18。第 3 個表格的母體標準差 σ 約為 4.899,第 4 個表格的樣本標準差 s 約為 5.237。
想改變資料個數時,請先增加(或減少)數值的列數,再把公式中的「B1:B8」改成實際的資料範圍(例如 10 個數就改成 B1:B10)。
有「P」的 STDEVP、VARP 用於母體(除以 N),沒有「P」的 STDEV、VAR 用於樣本(除以 N − 1)。DEVSQ 是一次算出離均差平方和的函數。
用 Google 試算表計算的方法
| 第 1 個數 | 10 |
| 第 2 個數 | 12 |
| 第 3 個數 | 23 |
| 第 4 個數 | 23 |
| 第 5 個數 | 16 |
| 第 6 個數 | 23 |
| 第 7 個數 | 21 |
| 第 8 個數 | 16 |
| 個數 N | =COUNT(B1:B8) |
| 總和 Σx | =SUM(B1:B8) |
| 平均數 μ | =AVERAGE(B1:B8) |
| 第 1 個數 | 10 |
| 第 2 個數 | 12 |
| 第 3 個數 | 23 |
| 第 4 個數 | 23 |
| 第 5 個數 | 16 |
| 第 6 個數 | 23 |
| 第 7 個數 | 21 |
| 第 8 個數 | 16 |
| 離均差平方和 S | =DEVSQ(B1:B8) |
| 第 1 個數 | 10 |
| 第 2 個數 | 12 |
| 第 3 個數 | 23 |
| 第 4 個數 | 23 |
| 第 5 個數 | 16 |
| 第 6 個數 | 23 |
| 第 7 個數 | 21 |
| 第 8 個數 | 16 |
| 母體變異數 σ² | =VARP(B1:B8) |
| 母體標準差 σ | =STDEVP(B1:B8) |
| 第 1 個數 | 10 |
| 第 2 個數 | 12 |
| 第 3 個數 | 23 |
| 第 4 個數 | 23 |
| 第 5 個數 | 16 |
| 第 6 個數 | 23 |
| 第 7 個數 | 21 |
| 第 8 個數 | 16 |
| 樣本變異數 s² | =VAR(B1:B8) |
| 樣本標準差 s | =STDEV(B1:B8) |
在 Google 試算表中,同樣是母體用 STDEVP、VARP,樣本用 STDEV、VAR。
用 Python 計算的方法
import statistics

numbers = [10, 12, 23, 23, 16, 23, 21, 16]  # 想知道分散程度的數值

mean = statistics.mean(numbers)               # 平均數 μ
pstdev = statistics.pstdev(numbers)           # 母體標準差 σ(除以 N)
pvariance = statistics.pvariance(numbers)     # 母體變異數 σ²
sstdev = statistics.stdev(numbers)            # 樣本標準差 s(除以 N-1)
svariance = statistics.variance(numbers)      # 樣本變異數 s²

print(f"個數:{len(numbers)} / 總和:{sum(numbers)} / 平均數:{mean}")
print(f"母體變異數 σ²:{pvariance} / 母體標準差 σ:{pstdev}")
print(f"樣本變異數 s²:{svariance} / 樣本標準差 s:{sstdev}")
用 LaTeX 等數學式語言的寫法(可直接複製)
μ = Σxᵢ ÷ N
\mu = \frac{x_1 + x_2 + \cdots + x_N}{N}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>μ</mi>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>x</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>x</mi><mn>2</mn></msub>
<mo>+</mo>
<mo>⋯</mo>
<mo>+</mo>
<msub><mi>x</mi><mi>N</mi></msub>
</mrow>
<mi>N</mi>
</mfrac>
</mrow>
</math>
mu = (x_1 + x_2 + cdots + x_N) / N
Mean[data]
mu := add(x[i], i = 1 .. N)/N;
mu = mean(x);
μ = (x_1 + x_2 + ⋯ + x_N)/N
S = Σ(xᵢ − μ)²
S = \sum_{i=1}^{N} (x_i - \mu)^2
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>S</mi>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
<mi>N</mi>
</munderover>
<msup>
<mrow><mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mi>μ</mi><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mrow>
</math>
S = sum_(i=1)^N (x_i - mu)^2
Total[(data - Mean[data])^2]
S := add((x[i] - mu)^2, i = 1 .. N);
S = sum((x - mean(x)).^2);
S = ∑_(i=1)^N (x_i − μ)^2
σ² = S ÷ N / s² = S ÷ (N − 1)
\sigma^2 = \frac{S}{N}, \qquad s^2 = \frac{S}{N-1}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msup><mi>σ</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mi>N</mi></mfrac>
<mo>,</mo>
<mspace width="1em"/>
<msup><mi>s</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac>
</mrow>
</math>
sigma^2 = S/N, s^2 = S/(N-1)
popVar = S/n; sampleVar = Variance[data] (* N 是 Mathematica 的內建函數(數值化),所以資料個數用 n 表示 *)
sigma2 := S/N; s2 := S/(N - 1);
popVar = S/N; sampleVar = var(x);
σ^2 = S/N, s^2 = S/(N−1)
σ = √(σ²) / s = √(s²)
\sigma = \sqrt{\sigma^2} = \sqrt{\dfrac{S}{N}}, \qquad s = \sqrt{s^2} = \sqrt{\dfrac{S}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>σ</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mi>N</mi></mfrac></msqrt>
<mo>,</mo>
<mspace width="1em"/>
<mi>s</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac></msqrt>
</mrow>
</math>
sigma = sqrt(S/N), s = sqrt(S/(N-1))
popSD = Sqrt[S/n]; sampleSD = StandardDeviation[data] (* N 是 Mathematica 的內建函數(數值化),所以資料個數用 n 表示 *)
sigma := sqrt(S/N); s := sqrt(S/(N - 1));
popSD = sqrt(S/numel(x)); sampleSD = std(x);
σ = √(S/N), s = √(S/(N−1))
請 ChatGPT 幫忙計算的方法
你是統計計算的助理。請務必實際執行 Python 程式碼來進行下列計算,並只以執行結果的數值作為回答的依據(請不要用心算或猜測回答)。

請針對下列資料,分別求出以下各值。
資料:10, 12, 23, 23, 16, 23, 21, 16
1. 個數、總和、平均數
2. 離均差平方和(每筆資料與平均數的差平方後全部相加的值)
3. 母體變異數 σ²(除以 N)與母體標準差 σ
4. 樣本變異數 s²(除以 N − 1)與樣本標準差 s

請列出計算時使用的公式,以及執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
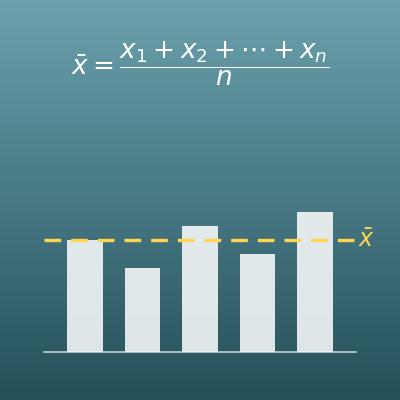
平均數計算機(算術平均數)
從用逗號分隔的數值,一次算出平均數、中位數、幾何平均數等
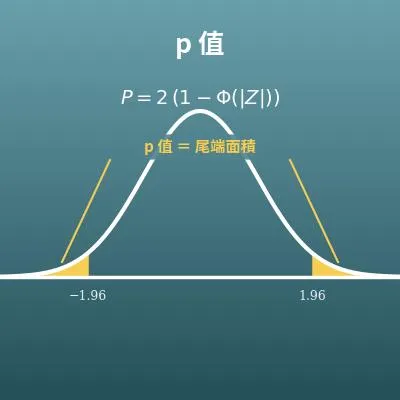
常態分布機率計算機(常態分配、範圍機率、z 分數)
由平均數與標準差,計算落在指定範圍內的機率

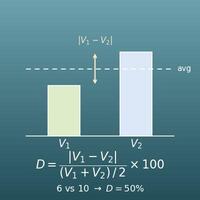
百分比差異計算機(相對差異)
把兩個值的差除以兩者的平均,以百分率(%)表示