






























































































































請輸入平均數、標準差,以及想知道的範圍的下限與上限。會算出落在範圍內的機率,以及信賴區間一覽表。
這個頁面可以做什麼
- 只要輸入「平均數 \(\mu\)」與「分散程度(標準差 \(\sigma\))」,馬上就能知道值落在指定範圍內的機率
- 也會一起算出某個值以上(或以下)的機率,例如「80 分以上是前百分之幾?」
- 同時顯示統計上常用的信賴區間(全體的 95% 所在的範圍等)一覽表
- 這個頁面還整理了常態分布的淺顯解說,以及可直接複製到 Excel、Google 試算表、Python 使用的公式
這個計算有什麼用?
心理測驗或教育評量常用的 T 分數,是把分數換算成「平均數為 50、1 個標準差為 10」。在常態分布中,平均數 \(+1\sigma\) 以上(T 分數 60 以上)約占全體的 16%,\(+2\sigma\) 以上(T 分數 70 以上)只有約 2.3%。
了解這個對應之後,考試成績單上的百分等級(PR 值,表示贏過百分之多少的人)是怎麼來的,就能用數字而不是憑感覺來解讀。
抽血檢查等的「參考值範圍」,常是依健康的人測量值的分布,取中間 95% 所在的範圍(大約是平均數 \(\pm 2\sigma\))來訂定。
也就是說,不論哪個檢驗項目,健康的人中約有 5%(20 人中有 1 人)會超出參考值範圍。檢查項目很多時,健康的人有一兩項被標示出來其實很常見。了解這一點,就能明白「稍微超出範圍」不一定代表「身體有問題」,也能冷靜聽醫師的說明。特別適合容易為檢查結果擔心的人。
產品重量或尺寸的變異接近常態分布。例如「內容量平均 102 g、標準差 1 g,規格下限 100 g」,低於規格的就是 \(-2\sigma\) 以外的部分,估計約 2.3%。
工廠會用這個計算預測不良率,並決定平均數要設在哪裡(也就是要多裝多少),在客訴與成本之間取得平衡。
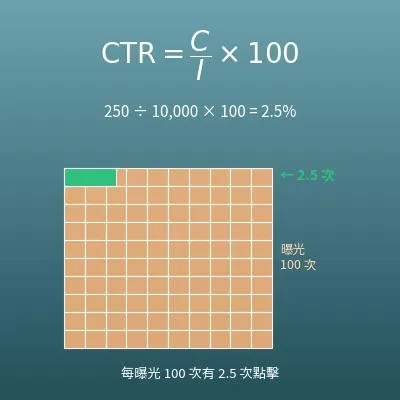
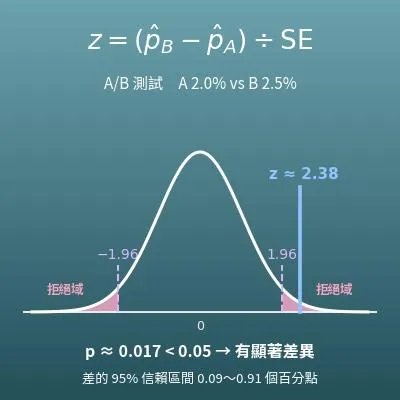
比較設計 A 和設計 B 哪一個點擊率比較高時,會用常態分布(信賴區間)判斷「這個差異是偶然的範圍,還是真正的差異」。
結果中信賴區間一覽表的「0.95」那一列,正是實務上最常用的「95% 信賴區間」。在廣告預算這種動用大筆金錢的決策背後,每天都在使用這個計算。
稱為精算師的專業人員,會用機率估計理賠的風險,據此訂定保費。
單一的事故雖然無法預測,但許多保戶的總和會接近常態分布(中央極限定理),所以整體的理賠金額可以預測得出奇準確。我們能用合理的保費得到很大的保障,就是多虧了這個數學。
公式與圖表
符號與用語解說
符號
| \(\mu\) | mu | 平均數,也就是分布高峰中心的位置。是希臘字母,相當於英文的 m。 |
| \(\sigma\) | sigma | 標準差,代表資料分散程度的大小,決定高峰的寬度。數值越大,高峰越低越寬。是希臘字母,相當於英文的 s。 |
| \(X\) | X(隨機變數) | 表示考試分數、身高這類「每次測量時值都可能不同的量」的文字。 |
| \(\Phi\) | 大寫 phi | 標準常態分布(平均數 0、標準差 1)的累積分布函數,傳回「小於或等於該值的機率」。 |
| \(z\) | z(z 分數) | 表示某個值離平均數有幾個標準差的數,用 \(z = (x - \mu) \div \sigma\) 求出。 |
| \(e\) | e(自然對數的底數) | 約 2.71828…的常數,是指數函數的基礎、很特別的數。 |
| \(\pi\) | pi(圓周率) | 約 3.14159…的常數。在常態分布的式子中,是為了讓曲線下方的面積總和剛好等於 1 而出現。 |
用語
| 常態分布 | 以平均數為中心、左右對稱呈鐘形分散的分布,也常稱為常態分配。資料中「接近平均的值最常出現,離平均越遠越少見」的情形,例如身高、考試分數、產品重量的變異,都用它當作模型。 |
| 標準差 | 用一個數表示資料分散程度的大小。即使平均數相同,資料也可能分散得大或小;標準差越大,分布的高峰越低越寬。 |
| 標準化 | 把值換算成「離平均數有幾個標準差」(z 分數)。任何常態分布經過標準化後,都能用平均數 0、標準差 1 的標準常態分布來處理。T 分數也是同樣的概念:\(T = 50 + 10 \times z\)。 |
| 累積分布函數 | 傳回「小於或等於該值的機率」的函數。標準常態分布的累積分布函數用符號 \(\Phi\)(phi)表示,落在範圍內的機率是用「上限的 \(\Phi\)」減去「下限的 \(\Phi\)」求出。 |
| 機率密度函數 | 表示分布曲線本身的式子。曲線的高度不是機率,而是「機率密度」;曲線與橫軸在某範圍所圍成的面積,代表的就是機率。常態分布的機率密度函數是鐘形曲線。 |
| 信賴區間 | 結果中顯示的一覽表,是以平均數為中心、分布全體的 ○% 所在的範圍(\(\mu \pm z \times \sigma\))與倍數 \(z\) 的對照表。嚴格來說,統計學上的「95% 信賴區間」是由樣本資料推估真正的值(例如母體平均數)所在的範圍;但假設為常態分布時,使用的是相同的 \(z\)(95% 時為 1.96),所以這張表的 \(z\) 值可以直接使用。常用於計算民調或檢驗結果的「誤差範圍」。 |
| 68–95–99.7 規則 | 記住會很方便的參考標準(也稱為經驗法則):在常態分布中,平均數 \(\pm 1\sigma\) 內約有 68.3%、\(\pm 2\sigma\) 內約有 95.4%、\(\pm 3\sigma\) 內約有 99.7% 的資料。 |
| 中央極限定理 | 由許多小小的偶然累積而成的量(總和或平均),不論原本的分布是什麼,都會接近常態分布的數學性質。這就是生活中許多資料都接近常態分布的背後原因。 |
建議先了解的基礎知識
為了讓您「真正理解意義」地使用這個頁面的計算,這裡整理了建議事先理解的基礎知識。
| 平均數(國小高年級、國中七年級) |
|
| 數據分析與標準差(高一「一維數據分析」,15~16 歲) |
|
| 比例與面積的看法(國小五年級~國中) |
|
| 標準化與 z 分數(高中選修數學,17~18 歲) |
|
用 Excel 計算的方法
| 平均數 μ | 62 |
| 標準差 σ | 14 |
| 範圍的下限 | 50 |
| 範圍的上限 | 80 |
| 介於下限與上限之間的機率 | =NORM.DIST(B4,B1,B2,TRUE)-NORM.DIST(B3,B1,B2,TRUE) |
| 平均數 μ | 62 |
| 標準差 σ | 14 |
| 想知道這個值以上的比例 | 80 |
| 該值以上的機率 | =1-NORM.DIST(B3,B1,B2,TRUE) |
| 平均數 μ | 62 |
| 標準差 σ | 14 |
| 想知道高度的位置 x | 80 |
| 該位置的曲線高度 | =NORM.DIST(B3,B1,B2,FALSE) |
「落在範圍內的機率」是用「上限以下的機率」減去「下限以下的機率」求出。
把最後一個引數改成 FALSE,傳回的就不是機率,而是該位置的曲線高度(機率密度函數的值)。
貼上後,B 欄是輸入欄,最後一列的公式會自動計算。第 1 個表格會顯示約 0.70(約 70%),第 2 個表格會顯示約 0.10(約 10%,也就是前 10% 左右)。
用 Google 試算表計算的方法
| 平均數 μ | 62 |
| 標準差 σ | 14 |
| 範圍的下限 | 50 |
| 範圍的上限 | 80 |
| 介於下限與上限之間的機率 | =NORMDIST(B4,B1,B2,TRUE)-NORMDIST(B3,B1,B2,TRUE) |
| 平均數 μ | 62 |
| 標準差 σ | 14 |
| 想知道這個值以上的比例 | 80 |
| 該值以上的機率 | =1-NORMDIST(B3,B1,B2,TRUE) |
| 平均數 μ | 62 |
| 標準差 σ | 14 |
| 想知道高度的位置 x | 80 |
| 該位置的曲線高度 | =NORMDIST(B3,B1,B2,FALSE) |
NORMDIST(x,平均數,標準差,TRUE)會傳回「小於或等於 x 的機率」,所以用上限的值減去下限的值,就是落在範圍內的機率。
把最後一個引數改成 FALSE,傳回的就不是機率,而是該位置的曲線高度(機率密度)。
用 Python 計算的方法
from statistics import NormalDist

mean = 62               # 平均數
standard_deviation = 14 # 標準差
lower_bound = 50        # 範圍的下限
upper_bound = 80        # 範圍的上限

distribution = NormalDist(mean, standard_deviation)
p_between = distribution.cdf(upper_bound) - distribution.cdf(lower_bound)

print(f"介於 {lower_bound} 與 {upper_bound} 之間的機率:{p_between}")
用 LaTeX 等數學式語言的寫法(可直接複製)
P(a ≤ X ≤ b) = Φ((b − μ)/σ) − Φ((a − μ)/σ)
P(a \le X \le b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>a</mi><mo>≤</mo><mi>X</mi><mo>≤</mo><mi>b</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>b</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
<mo>−</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>a</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
P(a <= X <= b) = Phi((b - mu)/sigma) - Phi((a - mu)/sigma)
CDF[NormalDistribution[mu, sigma], b] - CDF[NormalDistribution[mu, sigma], a]
with(Statistics): CDF(RandomVariable(Normal(mu, sigma)), b) - CDF(RandomVariable(Normal(mu, sigma)), a);
p = normcdf(b, mu, sigma) - normcdf(a, mu, sigma);
P(a ≤ X ≤ b) = Φ((b-μ)/σ) - Φ((a-μ)/σ)
f(x) = 1/(σ√(2π)) · e^(−(x − μ)²/(2σ²))
f(x) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac{(x-\mu)^2}{2\sigma^2}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mn>1</mn>
<mrow><mi>σ</mi><msqrt><mrow><mn>2</mn><mi>π</mi></mrow></msqrt></mrow>
</mfrac>
<msup>
<mi>e</mi>
<mrow>
<mo>−</mo>
<mfrac>
<msup><mrow><mo>(</mo><mi>x</mi><mo>−</mo><mi>μ</mi><mo>)</mo></mrow><mn>2</mn></msup>
<mrow><mn>2</mn><msup><mi>σ</mi><mn>2</mn></msup></mrow>
</mfrac>
</mrow>
</msup>
</mrow>
</math>
f(x) = 1/(sigma sqrt(2 pi)) e^(-(x - mu)^2 / (2 sigma^2))
PDF[NormalDistribution[mu, sigma], x]
with(Statistics): PDF(RandomVariable(Normal(mu, sigma)), x);
y = normpdf(x, mu, sigma);
f(x) = 1/(σ√(2π)) e^(-(x-μ)^2/(2σ^2))
請 ChatGPT 幫忙計算的方法
你是機率計算的助理。請務必實際執行 Python 程式碼來進行下列計算,並只以執行結果的數值作為回答的依據(請不要用心算或猜測回答)。

某次考試的分數呈常態分布,平均 62 分、標準差 14 分。
請分別求出:
1. 分數在 50 分到 80 分之間的機率
2. 分數在 80 分以上的機率(前百分之幾)
3. 分數在 50 分以下的機率

請使用 Python 的 statistics.NormalDist,並列出使用的程式碼與執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
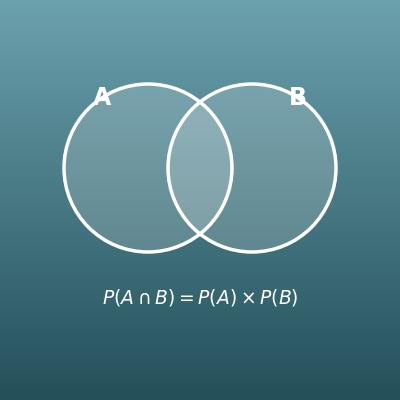
兩個獨立事件的機率(交集、聯集、至少一個發生)
由兩個機率計算「兩個都發生」「至少一個發生」等機率
兩個事件的機率(由兩個已知值反推其餘)
由已知的兩個機率,一次反推其餘的機率
重複試驗的機率(連續 n 次、至少 1 次)
計算連續 n 次發生的機率,以及 n 次中至少發生 1 次的機率