Kies hoe je je gegevens invult. “Uit ruwe gegevens” maakt een frequentietabel van een lijst waarden die je plakt, en met “Uit een frequentietabel” vul je de ondergrens, bovengrens en frequentie van elke klasse van een bestaande tabel in.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formules en grafiek
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Plak ruwe gegevens zoals lengtes, toetscijfers of reistijden (gescheiden door puntkomma’s of spaties), kies de klassenbreedte en de ondergrens van de eerste klasse, en er wordt een frequentietabel (klasse, klassenmidden, frequentie, relatieve frequentie, cumulatieve frequentie, cumulatieve relatieve frequentie) voor je gemaakt
- Je kunt ook een bestaande frequentietabel (ondergrens, bovengrens en frequentie van elke klasse) direct invoeren
- Het gemiddelde geschat uit de klassenmiddens (“som van (klassenmidden × frequentie) ÷ totale frequentie”) wordt getoond als een breuk in de eenvoudigste vorm (exact) en als decimaal getal. Ook de modus en de klasse met de mediaan worden gevonden
- Een histogram en een frequentiepolygoon worden automatisch getekend en je kunt ze opslaan als PNG of SVG
- Een heldere uitleg van begrippen als klasse, frequentie en relatieve frequentie en formules om te kopiëren voor Excel, Google Spreadsheets en Python staan ook op deze pagina
Waarvoor is deze berekening handig?
Frequentietabellen en histogrammen van toetsresultaten, gegroepeerd per heel cijfer, zijn een vast onderdeel van cijferoverzichten. Ook bij hetzelfde gemiddelde van een 6 beschrijven één piek rond de 6 en twee pieken bij de 4 en de 8 totaal verschillende groepen leerlingen.
Reken je de aantallen om naar relatieve frequenties, dan kun je de verdelingen van groepen van verschillende grootte eerlijk vergelijken, zoals twee groepen leerlingen of twee leerjaren. De grafieken op toetsrapporten die laten zien in welke band je score valt, zijn gebouwd op hetzelfde idee van een frequentieverdeling.
Het histogram is een van de “zeven basisgereedschappen van kwaliteitsbeheer” die in de industrie worden gebruikt voor kwaliteitscontrole. Meet de afmeting of het gewicht van producten en maak er een frequentieverdeling van, en je ziet het midden en de spreiding van de variatie, en of die opschuift naar de boven- of ondergrens van de specificatie.
Splitst de verdeling zich in twee pieken, dan kan dat betekenen dat twee machines verschillend zijn ingesteld. De vorm geeft aanwijzingen om de oorzaak van fouten te vinden.
Het CBS publiceert de bevolking naar leeftijdsgroep en het inkomen van huishoudens in inkomensklassen (zoals “€ 30.000 tot € 40.000”) in de vorm van frequentietabellen. Bij scheve gegevens zoals inkomen trekken een paar grote waarden het gemiddelde boven de mediaan, dus een “gemiddeld inkomen van € X” alleen kan je een verkeerd beeld geven.
Een frequentietabel laat ook zien in welke inkomensklasse de meeste huishoudens zitten (de modale klasse) en in welke klasse het middelste huishouden zit (de klasse met de mediaan), zodat je kunt oordelen op basis van het totaalbeeld van de verdeling.
In de weer- en klimaatkunde worden waargenomen neerslag- en temperatuurgegevens in klassen ingedeeld, bijvoorbeeld “op hoeveel dagen per jaar viel 10 mm neerslag of meer”. Een frequentieverdeling maakt het mogelijk trends tussen jaren of regio’s te vergelijken en veranderingen te zien in hoe vaak de extreme klassen voorkomen.
Rampenplanning is gebouwd op dit soort informatie over de verdeling: hoe sterk een gebeurtenis is en hoe vaak gebeurtenissen van die sterkte voorkomen.
Op het consultatiebureau worden de lengte en het gewicht van een kind vergeleken met de groeidiagrammen van TNO, die laten zien hoe een kind zich verhoudt tot andere kinderen van dezelfde leeftijd. Zulke diagrammen beginnen bij de verdeling van metingen van veel kinderen. “Langer dan 75% van de kinderen van dezelfde leeftijd” (een percentiel) is hetzelfde idee als de cumulatieve relatieve frequentie: het aandeel van alle gegevens onder een waarde.
Ook de referentiewaarden voor lengte, gewicht, bloeddruk en andere uitslagen van een gezondheidscontrole beginnen met het bestuderen van de verdeling van gegevens van veel mensen.
Formules en grafiek
Symbolen en begrippen
Symbolen
| \(n\) | n | Een letter voor de totale frequentie (het aantal van alle waarden), van de eerste letter van “aantal” (in het Engels “number”). |
| \(f\) | f | Een letter voor de frequentie (het aantal waarden in een klasse), van de eerste letter van “frequentie”. |
| \(r\) | r | De letter voor de relatieve frequentie in de formules om te kopiëren op deze pagina, van de eerste letter van “relatieve”. |
| \(a,\ b\) | a, b | De ondergrens (inbegrepen) en de bovengrens (niet inbegrepen) van een klasse. Het is gebruikelijk om voor vaste getallen letters van het begin van het alfabet te gebruiken, \(a,\ b,\ c\). |
| \(m\) | m | De letter die op deze pagina staat voor het klassenmidden (de waarde in het midden van een klasse), van de eerste letter van “midden”. |
| \(\bar{x}\) | x-streep | Het symbool voor het gemiddelde. Een streep, die staat voor “gemiddelde”, wordt boven de letter \(x\) gezet die de gegevenswaarden voorstelt. Het wordt veel gebruikt in de statistiek. |
Begrippen
| frequentietabel | Een tabel die gegevens verdeelt in meerdere klassen (intervallen) en telt hoeveel waarden (de frequentie) in elke klasse vallen. Het is een basishulpmiddel van de statistiek om een overzicht te krijgen van de verdeling van de gegevens. |
| klasse | Elk van de intervallen waarin de gegevens worden verdeeld. Bij reistijden gebruik je bijvoorbeeld meestal intervallen van dezelfde breedte zonder gaten, zoals “0 tot 5 minuten”, “5 tot 10 minuten” enzovoort (niet te verwarren met een schoolklas). |
| klassenbreedte | De grootte van één klasse. Bij “10 tot 15 minuten” is de breedte 5 minuten. Verander je de breedte, dan verandert ook hoe de tabel en het histogram eruitzien. |
| klassenmidden | De waarde in het midden van een klasse, te vinden met (ondergrens + bovengrens) ÷ 2. Het klassenmidden van “10 tot 15 minuten” is 12,5 minuten. Het vertegenwoordigt de klasse als je het gemiddelde uit een frequentietabel schat. |
| frequentie | Het aantal waarden in een klasse. Je telt in wat je ook telt, zoals personen, keren of stuks. |
| relatieve frequentie | Het aandeel van het geheel dat de frequentie van een klasse inneemt. Je vindt het met frequentie ÷ totale frequentie en schrijft het meestal als decimaal getal. De relatieve frequenties van alle klassen tellen op tot 1. |
| cumulatieve frequentie | De frequenties van de eerste klasse tot en met die klasse, bij elkaar opgeteld. Je ziet er meteen aan hoeveel waarden onder een bepaalde waarde liggen. |
| cumulatieve relatieve frequentie | De relatieve frequenties van de eerste klasse tot en met die klasse, bij elkaar opgeteld (cumulatieve frequentie ÷ totale frequentie). Je ziet er welk aandeel van alle gegevens onder een bepaalde waarde ligt. Bij de laatste klasse is het 1. |
| ondergrens | De kleinste waarde van een klasse, en die hoort bij de klasse. Deze regel voorkomt twijfel over waar een waarde op een grens hoort. De klasse “10 tot 15” bevat een waarde van precies 10. |
| bovengrens | De waarde waar een klasse eindigt, en die hoort niet bij de klasse. Een waarde van precies 15 komt dus niet in “10 tot 15” maar in de volgende klasse, “15 tot 20”. |
| histogram | Een frequentietabel getekend als staafdiagram. De klassen staan op de horizontale as en de frequenties op de verticale as, en de rechthoekige staven staan zonder tussenruimte naast elkaar. Je ziet in één oogopslag hoe de gegevens zijn uitgespreid (de vorm van de verdeling). |
| frequentiepolygoon | Een lijndiagram dat het midden van de bovenkant van elke staaf van het histogram (bij het klassenmidden) in volgorde verbindt. Aan beide uiteinden loopt de lijn naar beneden naar de horizontale as, alsof daar een klasse met frequentie 0 is. Handig om twee verdelingen over elkaar heen te leggen en te vergelijken. |
| verdeling | Hoe de gegevens zijn uitgespreid, dus waar veel waarden zijn en waar weinig. Frequentietabellen en histogrammen zijn hulpmiddelen om naar een verdeling te kijken. |
| centrummaat | Eén getal dat samenvat waar het midden van de gegevens ligt. Het gemiddelde, de mediaan en de modus zijn de meest gebruikte. |
| gemiddelde | Alle gegevenswaarden bij elkaar opgeteld en gedeeld door het aantal waarden. Uit een frequentietabel schat je het met som van (klassenmidden × frequentie) ÷ totale frequentie. |
| mediaan | De waarde precies in het midden als de gegevens van klein naar groot gesorteerd zijn. Bij een even aantal waarden is het het gemiddelde van de twee middelste waarden. Bij een frequentietabel gebruik je de cumulatieve frequentie om te vinden in welke klasse de mediaan zit. |
| modus | De waarde die het vaakst voorkomt. Bij een frequentietabel wordt het klassenmidden van de klasse met de hoogste frequentie (de modale klasse) als modus genomen. |
| ruwe gegevens | De afzonderlijke waarden zoals ze gemeten zijn, voordat ze zijn samengevat. Als je ruwe gegevens in een frequentietabel ordent, wordt het totaalbeeld makkelijker te zien, maar de informatie over elke afzonderlijke waarde gaat verloren. |
Handig om vooraf te weten
Dit helpt je om de berekening op deze pagina echt te begrijpen en niet alleen op de knop te drukken.
Loop je vast, dan is het snelst om deze onderwerpen nog eens door te nemen.
| Ongelijkheden met ≤ en < (klas 1 tot 2, 12-14 jaar) |
|
| Het gemiddelde (groep 7, 10-11 jaar) |
|
| Verhoudingen en procenten (groep 7, 10-11 jaar) |
|
| Breuken en decimalen (groep 5 tot 7, 8-11 jaar) |
|
| Centrummaten (groep 7 tot klas 1, 10-13 jaar) |
|
Berekenen met Excel
| Frequentie van een klasse f | 6 |
| Totale frequentie n | 20 |
| Relatieve frequentie r = f ÷ n | =B1/B2 |
| Ondergrens van de klasse a | 10 |
| Bovengrens van de klasse b | 15 |
| Klassenmidden m = (a + b) ÷ 2 | =(B1+B2)/2 |
| Klassenmidden 1 (0 tot 5) | 2,5 |
| Klassenmidden 2 (5 tot 10) | 7,5 |
| Klassenmidden 3 (10 tot 15) | 12,5 |
| Klassenmidden 4 (15 tot 20) | 17,5 |
| Klassenmidden 5 (20 tot 25) | 22,5 |
| Klassenmidden 6 (25 tot 30) | 27,5 |
| Frequentie 1 | 1 |
| Frequentie 2 | 5 |
| Frequentie 3 | 6 |
| Frequentie 4 | 4 |
| Frequentie 5 | 3 |
| Frequentie 6 | 1 |
| Som van (klassenmidden × frequentie) | =SOMPRODUCT(B1:B6;B7:B12) |
| Totale frequentie n | =SOM(B7:B12) |
| Geschat gemiddelde | =B13/B14 |
| Waarde 1 | 3 |
| Waarde 2 | 5 |
| Waarde 3 | 8 |
| Waarde 4 | 12 |
| Waarde 5 | 14 |
| Waarde 6 | 17 |
| Waarde 7 | 22 |
| Waarde 8 | 26 |
| Frequentie van 0 tot 5 | =AANTALLEN.ALS(B1:B8;">=0";B1:B8;"<5") |
| Frequentie van 5 tot 10 | =AANTALLEN.ALS(B1:B8;">=5";B1:B8;"<10") |
| Frequentie van 10 tot 15 | =AANTALLEN.ALS(B1:B8;">=10";B1:B8;"<15") |
De eerste tabel is een voorbeeld van relatieve frequentie, en het antwoord is 0,3. De tweede tabel is een voorbeeld van een klassenmidden, en het antwoord is 12,5.
De derde tabel schat het gemiddelde voor het voorbeeld van de rekenmachine op deze pagina (reistijden van 20 leerlingen). SOMPRODUCT is een functie die overeenkomstige cellen met elkaar vermenigvuldigt en de uitkomsten optelt, dus ze geeft de som van (klassenmidden × frequentie) in één stap. Het antwoord is 14.
De vierde tabel telt de frequentie van elke klasse uit ruwe gegevens. AANTALLEN.ALS is een functie die de cellen telt die aan voorwaarden voldoen. Zet de twee voorwaarden “10 of meer” en “minder dan 15” naast elkaar en je krijgt de frequentie van die klasse.
Berekenen met Google Spreadsheets
| Frequentie van een klasse f | 6 |
| Totale frequentie n | 20 |
| Relatieve frequentie r = f ÷ n | =B1/B2 |
| Ondergrens van de klasse a | 10 |
| Bovengrens van de klasse b | 15 |
| Klassenmidden m = (a + b) ÷ 2 | =(B1+B2)/2 |
| Klassenmidden 1 (0 tot 5) | 2,5 |
| Klassenmidden 2 (5 tot 10) | 7,5 |
| Klassenmidden 3 (10 tot 15) | 12,5 |
| Klassenmidden 4 (15 tot 20) | 17,5 |
| Klassenmidden 5 (20 tot 25) | 22,5 |
| Klassenmidden 6 (25 tot 30) | 27,5 |
| Frequentie 1 | 1 |
| Frequentie 2 | 5 |
| Frequentie 3 | 6 |
| Frequentie 4 | 4 |
| Frequentie 5 | 3 |
| Frequentie 6 | 1 |
| Som van (klassenmidden × frequentie) | =SOMPRODUCT(B1:B6;B7:B12) |
| Totale frequentie n | =SOM(B7:B12) |
| Geschat gemiddelde | =B13/B14 |
| Waarde 1 | 3 |
| Waarde 2 | 5 |
| Waarde 3 | 8 |
| Waarde 4 | 12 |
| Waarde 5 | 14 |
| Waarde 6 | 17 |
| Waarde 7 | 22 |
| Waarde 8 | 26 |
| Frequentie van 0 tot 5 | =AANTALLEN.ALS(B1:B8;">=0";B1:B8;"<5") |
| Frequentie van 5 tot 10 | =AANTALLEN.ALS(B1:B8;">=5";B1:B8;"<10") |
| Frequentie van 10 tot 15 | =AANTALLEN.ALS(B1:B8;">=10";B1:B8;"<15") |
Berekenen met Python
from fractions import Fraction

# ruwe gegevens (voorbeeld: reistijden van 20 leerlingen, in minuten)
data_values = [5, 12, 8, 14, 3, 22, 15, 9, 11, 26,
               7, 14, 19, 6, 13, 24, 10, 16, 21, 18]
class_width = Fraction(5)   # klassenbreedte
first_lower = Fraction(0)   # ondergrens van de eerste klasse

data_values = [Fraction(v) for v in data_values]
class_count = max(int((v - first_lower) / class_width) for v in data_values) + 1

# zet elke waarde in zijn klasse (ondergrens erbij, bovengrens er niet bij)
freqs = [0] * class_count
for v in data_values:
    freqs[int((v - first_lower) / class_width)] += 1

total = sum(freqs)
mid_times_freq_sum = Fraction(0)
print("Klasse / Klassenmidden / Frequentie / Relatieve frequentie")
for i, f in enumerate(freqs):
    lower = first_lower + i * class_width
    upper = lower + class_width
    midpoint = (lower + upper) / 2
    mid_times_freq_sum += midpoint * f
    print(f"{lower} tot {upper} / {float(midpoint)} / {f} / {float(Fraction(f, total))}")

estimated_mean = mid_times_freq_sum / total
print(f"Geschat gemiddelde (breuk): {estimated_mean}")
print(f"Geschat gemiddelde (decimaal getal): {float(estimated_mean)}")
print(f"Gemiddelde van de ruwe gegevens: {float(sum(data_values) / len(data_values))}")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
r = f ÷ n
r = \dfrac{f}{n}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>r</mi>
    <mo>=</mo>
    <mfrac><mi>f</mi><mi>n</mi></mfrac>
  </mrow>
</math>
r = f/n
r = f/n
r := f/n;
r = f/n;
r = f/n
m = (a + b) ÷ 2
m = \dfrac{a + b}{2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>m</mi>
    <mo>=</mo>
    <mfrac>
      <mrow><mi>a</mi><mo>+</mo><mi>b</mi></mrow>
      <mn>2</mn>
    </mfrac>
  </mrow>
</math>
m = (a + b)/2
m = (a + b)/2
m := (a + b)/2;
m = (a + b)/2;
m = (a + b)/2
x̄ = (m₁×f₁ + m₂×f₂ + … + mₖ×fₖ) ÷ n
\bar{x} = \dfrac{m_1 f_1 + m_2 f_2 + \cdots + m_k f_k}{n}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>m</mi><mn>1</mn></msub><msub><mi>f</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>m</mi><mn>2</mn></msub><msub><mi>f</mi><mn>2</mn></msub>
<mo>+</mo><mo>⋯</mo><mo>+</mo>
<msub><mi>m</mi><mi>k</mi></msub><msub><mi>f</mi><mi>k</mi></msub>
</mrow>
<mi>n</mi>
</mfrac>
</mrow>
</math>
bar x = (m_1 f_1 + m_2 f_2 + cdots + m_k f_k)/n
Total[m*f]/Total[f]
xbar := add(m[i]*f[i], i = 1..k)/n;
xbar = sum(m.*f)/sum(f);
x̄ = (m_1 f_1 + m_2 f_2 + … + m_k f_k)/n
Zo laat je ChatGPT de berekening doen
Je bent een rekenassistent voor statistiek. Doe de volgende berekening door echt Python-code uit te voeren en baseer je antwoord alleen op de getallen uit het resultaat van de uitvoering (geef geen antwoord uit het hoofd of op gevoel).

Maak een frequentietabel voor de volgende gegevens, met klassen die beginnen bij een ondergrens van 0 en een klassenbreedte van 5 (elke klasse bevat zijn ondergrens en bevat zijn bovengrens niet).
Gegevens: 5, 12, 8, 14, 3, 22, 15, 9, 11, 26, 7, 14, 19, 6, 13, 24, 10, 16, 21, 18
Toon elk van de volgende:
1. De frequentietabel (klasse, klassenmidden, frequentie, relatieve frequentie, cumulatieve frequentie, cumulatieve relatieve frequentie)
2. Het gemiddelde geschat uit de klassenmiddens (zowel als breuk in de eenvoudigste vorm als als decimaal getal)
3. De modus en de klasse die de mediaan bevat
4. Het gemiddelde rechtstreeks berekend uit de ruwe gegevens, en hoe ver de schatting ervan afligt

Reken in Python exact met de module fractions uit de standaardbibliotheek en toon de formules die je hebt gebruikt en de getallen uit het resultaat van de uitvoering.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
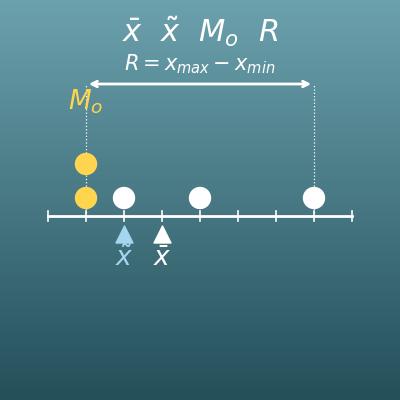
Gemiddelde, mediaan, modus en variatiebreedte berekenen
Berekent het gemiddelde, de mediaan, de modus en de variatiebreedte van ruwe gegevens in één keer en legt uit wanneer je welke gebruikt
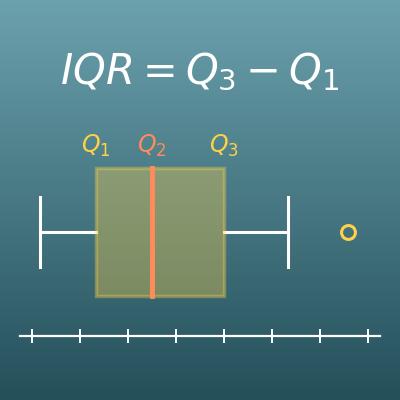
Kwartielen en boxplot berekenen (Q1, Q2, Q3, IQR, uitschieters)
Laat de spreiding van gegevens zien met kwartielen en een boxplot, een ander hulpmiddel naast het histogram om een verdeling te bekijken