Bladwijzers    
Kans A en B    
nPr en nCr    
Ronde tafel    
Met herhaling    
Gemiddelde    
SD berekenen    
Z-score    
P-waarde    
Percentage    
Verschil in %    
Verhoudingen    
Korting    
Btw berekenen    
Winstmarge    
Snelheid    
Dichtheid    
Molariteit    
Molaire massa    
Wet van Ohm    
Schoenmaat    
Staartdeling    
Kgv berekenen    
Ggd berekenen    
Priemfactoren    
Diofantisch    
Gemengd getal    
Afronden    
Abc-formule    
Logaritme    
Poolvorm    
De Moivre    
Rc berekenen    
Evenredigheid    
3D-afstand    
Punt tot lijn    
Afstand GPS    
Kegelsneden    
Kruisproduct    
Determinant    
Sin cos tan    
Opp. driehoek    
Pythagoras    
Cirkelsector    
Omtrekshoek    
Inhoud kubus    
Inhoud balk    
Opp. cilinder    
Inhoud bol    
Inhoud bolkap    
Opp. bolkap    
Inhoud kegel    
Inhoud buis    
Opp. capsule    
Dagen tellen    
Uren vanaf nu    
Tijd optellen    
Tijdsverschil    
Eindwaarde    
ROI berekenen    
IRR berekenen    
Bbp berekenen    
CTR berekenen    
LTV berekenen    
CAC berekenen    
Churn rate    
A/B-test    
SEO-verkeer    
BMI berekenen    
BMR berekenen    
Vetpercentage    
Eiwit per dag    
Koolhydraten    
Vet berekenen    
Golfhandicap    
1RM berekenen    
Hitte-index    
Windchill    
Dauwpunt    
Talstelsels    
Downloadtijd    
Stroomkosten    
kWh naar euro    
Airco kosten    
Kosten kachel    
Gas of stroom    
Besparing led    
Maandbudget    
Laadkosten    
EV vs benzine    
Bandenmaat    
Thuisbatterij    
Aantal tegels    
Gevelopervlak    
Mortel mengen    
Zaagplan hout    
Vloer op rol    
Gordijnmaat    
Graszoden    
Betonblokken    
Bakstenen    
Vlonder    
Hellingbaan    
Voorboren    
Raam opmeten    
Ophanghoogte    
Afschot buis    
Kit berekenen    
Warmteverlies    
Verhuisdozen    
Opbergruimte    
   Toevoegen
Kansrekening en willekeurige getallen: rekenmachines
Kans A en B
Kans A en B
Kans terugrekenen
Kans terugrekenen
Herhaalde kans
Herhaalde kans
Stelling van Bayes
Stelling van Bayes
Verwachtingswaarde
Verwachtingswaarde
Binomiale kans
Binomiale kans
nPr en nCr
nPr en nCr
Ronde tafel
Ronde tafel
Met herhaling
Met herhaling
Willekeurig getal
Willekeurig getal
Gemiddelden en statistiek: rekenmachines
Gemiddelde
Gemiddelde
Modus en mediaan
Modus en mediaan
SD berekenen
SD berekenen
Kwartielen & IQR
Kwartielen & IQR
Frequentietabel
Frequentietabel
Correlatie (r)
Correlatie (r)
Normale verdeling
Normale verdeling
Z-score
Z-score
Interval (95%)
Interval (95%)
Steekproefgrootte
Steekproefgrootte
Vangst-hervangst
Vangst-hervangst
P-waarde
P-waarde
Procenten en verhoudingen: rekenmachines
Percentage
Percentage
Verandering in %
Verandering in %
Verschil in %
Verschil in %
Afwijking in %
Afwijking in %
Verhoudingen
Verhoudingen
Korting
Korting
Btw berekenen
Btw berekenen
Winstmarge
Winstmarge
Snelheid: rekenmachines
Snelheid
Snelheid
Dichtheid en concentratie: rekenmachines
Dichtheid
Dichtheid
Molariteit
Molariteit
Molaire massa
Molaire massa
Natuurkunde en elektriciteit: rekenmachines
Wet van Ohm
Wet van Ohm
Watt naar ampère
Watt naar ampère
Weerstand kleur
Weerstand kleur
Spanningsverlies
Spanningsverlies
Eenheden omrekenen: rekenmachines
Gewicht omrekenen
Gewicht omrekenen
Schoenmaat
Schoenmaat
Gehele getallen: rekenmachines
Staartdeling
Staartdeling
Kgv berekenen
Kgv berekenen
Ggd berekenen
Ggd berekenen
Negatieve getallen
Negatieve getallen
Priemfactoren
Priemfactoren
Diofantisch
Diofantisch
Modulo rekenen
Modulo rekenen
Delers berekenen
Delers berekenen
Romeinse cijfers
Romeinse cijfers
Breuken, decimalen en afronden: rekenmachines
Breuken rekenen
Breuken rekenen
Gemengd getal
Gemengd getal
Vereenvoudigen
Vereenvoudigen
Breuk omzetten
Breuk omzetten
Decimaal naar breuk
Decimaal naar breuk
Afronden
Afronden
Vergelijkingen en ongelijkheden: rekenmachines
Vergelijking (x)
Vergelijking (x)
Stelsel oplossen
Stelsel oplossen
Abc-formule
Abc-formule
Absolute waarde
Absolute waarde
Ongelijkheid x²
Ongelijkheid x²
Veeltermen: rekenmachines
Binomium Newton
Binomium Newton
Wortels: rekenmachines
Wortel herleiden
Wortel herleiden
Wortel berekenen
Wortel berekenen
Machten en logaritmen: rekenmachines
Machten berekenen
Machten berekenen
Logaritme
Logaritme
Aantal cijfers
Aantal cijfers
Wetensch. notatie
Wetensch. notatie
Rekenen ×10ⁿ
Rekenen ×10ⁿ
Halveringstijd
Halveringstijd
Complexe getallen: rekenmachines
Complexe getal
Complexe getal
Poolvorm
Poolvorm
De Moivre
De Moivre
Functies en grafieken: rekenmachines
Rc berekenen
Rc berekenen
Lineaire functie
Lineaire functie
Evenredigheid
Evenredigheid
y = ax² berekenen
y = ax² berekenen
Afstandsformule
Afstandsformule
3D-afstand
3D-afstand
Verdelingspunt
Verdelingspunt
Punt tot lijn
Punt tot lijn
Afstand GPS
Afstand GPS
Kwadraat afsplitsen
Kwadraat afsplitsen
Cirkelvergelijking
Cirkelvergelijking
Kegelsneden
Kegelsneden
Poolcoördinaten
Poolcoördinaten
Rijen: rekenmachines
Rekenkundige rij
Rekenkundige rij
Meetkundige rij
Meetkundige rij
Rij van Fibonacci
Rij van Fibonacci
Recursieve rij
Recursieve rij
Vectoren: rekenmachines
Vectoren berekenen
Vectoren berekenen
Kruisproduct
Kruisproduct
Matrices: rekenmachines
Matrix berekenen
Matrix berekenen
Determinant
Determinant
Inverse matrix
Inverse matrix
Vlakke meetkunde: rekenmachines
Sin cos tan
Sin cos tan
Graden ⇔ radialen
Graden ⇔ radialen
a sin θ + b cos θ
a sin θ + b cos θ
Driehoek berekenen
Driehoek berekenen
Opp. driehoek
Opp. driehoek
Rechthoekige driehoek
Pythagoras
Pythagoras
Hoeken veelhoek
Hoeken veelhoek
Gelijkvormigheid
Gelijkvormigheid
Evenwijdige lijnen
Evenwijdige lijnen
Oppervlakte rechthoek
Parallellogram
Parallellogram
Oppervlakte trapezium
Cirkel berekenen
Cirkel berekenen
Cirkelsector
Cirkelsector
Omtrekshoek
Omtrekshoek
Oppervlakte ellips
Oppervlakte ellips
Ruimtemeetkunde: rekenmachines
Inhoud kubus
Inhoud kubus
Oppervlakte kubus
Oppervlakte kubus
Inhoud balk
Inhoud balk
Oppervlakte balk
Oppervlakte balk
Inhoud cilinder
Inhoud cilinder
Opp. cilinder
Opp. cilinder
Inhoud bol
Inhoud bol
Oppervlakte bol
Oppervlakte bol
Inhoud bolkap
Inhoud bolkap
Opp. bolkap
Opp. bolkap
Inhoud ellipsoïde
Inhoud ellipsoïde
Opp. ellipsoïde
Opp. ellipsoïde
Inhoud piramide
Inhoud piramide
Piramideoppervlak
Piramideoppervlak
Inhoud kegel
Inhoud kegel
Oppervlakte kegel
Oppervlakte kegel
Inhoud kegelstomp
Inhoud kegelstomp
Opp. kegelstomp
Opp. kegelstomp
Inhoud buis
Inhoud buis
Inhoud capsule
Inhoud capsule
Opp. capsule
Opp. capsule
Datum en tijd: rekenmachines
Leeftijd berekenen
Leeftijd berekenen
Dagen tellen
Dagen tellen
Datum berekenen
Datum berekenen
Uren vanaf nu
Uren vanaf nu
Dag van de week
Dag van de week
Tijd optellen
Tijd optellen
Tijdzones omrekenen
Tijdzones omrekenen
Werktijd berekenen
Werktijd berekenen
Tijdsverschil
Tijdsverschil
Urenregistratie
Urenregistratie
Financiën en economie: rekenmachines
Rente op rente
Rente op rente
Enkelvoudige rente
Enkelvoudige rente
Rente berekenen
Rente berekenen
TVM-rekenmachine
TVM-rekenmachine
Contante waarde
Contante waarde
Eindwaarde
Eindwaarde
ROI berekenen
ROI berekenen
IRR berekenen
IRR berekenen
Terugverdientijd
Terugverdientijd
Gem. rendement
Gem. rendement
Bbp berekenen
Bbp berekenen
Online marketing en advertentiecijfers: rekenmachines
CTR berekenen
CTR berekenen
Conversie (CVR)
Conversie (CVR)
CPC, CPM en CPA
CPC, CPM en CPA
ROAS berekenen
ROAS berekenen
Break-even-CPA
Break-even-CPA
LTV berekenen
LTV berekenen
CAC berekenen
CAC berekenen
Churn rate
Churn rate
A/B-test
A/B-test
A/B-steekproef
A/B-steekproef
SEO-verkeer
SEO-verkeer
Break-evenpunt
Break-evenpunt
Marge en opslag
Marge en opslag
CAGR berekenen
CAGR berekenen
Gezondheid en fitness: rekenmachines
BMI berekenen
BMI berekenen
Slaapcalculator
Slaapcalculator
Caloriebehoefte
Caloriebehoefte
BMR berekenen
BMR berekenen
TDEE berekenen
TDEE berekenen
Ideaal gewicht
Ideaal gewicht
Vetpercentage
Vetpercentage
Vetvrije massa
Vetvrije massa
Calorieverbruik
Calorieverbruik
Eiwit per dag
Eiwit per dag
Macro’s berekenen
Macro’s berekenen
Koolhydraten
Koolhydraten
Vet berekenen
Vet berekenen
Lengte voorspellen
Lengte voorspellen
Sport: rekenmachines
Golfhandicap
Golfhandicap
Tempo berekenen
Tempo berekenen
1RM berekenen
1RM berekenen
Streefhartslag
Streefhartslag
Weer: rekenmachines
Hitte-index
Hitte-index
Windchill
Windchill
Dauwpunt
Dauwpunt
Informatica: rekenmachines
Talstelsels
Talstelsels
Subnetcalculator
Subnetcalculator
Downloadtijd
Downloadtijd
Energie in huis en budget: rekenmachines
Stroomkosten
Stroomkosten
kWh naar euro
kWh naar euro
Kosten per jaar
Kosten per jaar
Airco vermogen
Airco vermogen
Airco kosten
Airco kosten
Kosten kachel
Kosten kachel
Gas of stroom
Gas of stroom
Besparing led
Besparing led
Salaris omrekenen
Salaris omrekenen
Maandbudget
Maandbudget
Auto: rekenmachines
Brandstofkosten
Brandstofkosten
Laadkosten
Laadkosten
EV vs benzine
EV vs benzine
Verbruik berekenen
Verbruik berekenen
Bandenmaat
Bandenmaat
Zonne-energie en batterijen: rekenmachines
Zonne-opbrengst
Zonne-opbrengst
Aantal panelen
Aantal panelen
Terugverdientijd
Terugverdientijd
Thuisbatterij
Thuisbatterij
Wonen en klussen: rekenmachines
Aantal tegels
Aantal tegels
Trap berekenen
Trap berekenen
Beton berekenen
Beton berekenen
Wandoppervlakte
Wandoppervlakte
Behang berekenen
Behang berekenen
Verf berekenen
Verf berekenen
Vloer berekenen
Vloer berekenen
Gevelopervlak
Gevelopervlak
Grind en split
Grind en split
Mortel mengen
Mortel mengen
Helling berekenen
Helling berekenen
Zaagplan hout
Zaagplan hout
Bebouwing en FSI
Bebouwing en FSI
Vloer op rol
Vloer op rol
Isolatie berekenen
Isolatie berekenen
Gordijnmaat
Gordijnmaat
Tv kijkafstand
Tv kijkafstand
Potgrond berekenen
Potgrond berekenen
Graszoden
Graszoden
Betonblokken
Betonblokken
Bakstenen
Bakstenen
Vlonder
Vlonder
Hellingbaan
Hellingbaan
Voorboren
Voorboren
Ventilatievoud
Ventilatievoud
Verf verdunnen
Verf verdunnen
Plint berekenen
Plint berekenen
Raam opmeten
Raam opmeten
Ophanghoogte
Ophanghoogte
Afschot buis
Afschot buis
Aantal schroeven
Aantal schroeven
Houtvolume (m³)
Houtvolume (m³)
Palen en panelen
Palen en panelen
Krimp van hout
Krimp van hout
Kit berekenen
Kit berekenen
Warmteverlies
Warmteverlies
Past het door?
Past het door?
Verhuisdozen
Verhuisdozen
Opbergruimte
Opbergruimte
Zaagplan platen
Zaagplan platen
Doorbuiging plank
Doorbuiging plank

Correlatiecoëfficiënt en covariantie berekenen (met spreidingsdiagram en regressielijn)

Vul de twee reeksen gegevens in waarvan je het verband wilt onderzoeken, elk gescheiden door puntkomma’s (;). Je krijgt de correlatiecoëfficiënt r, de covariantie en de vergelijking van de regressielijn, en de regressielijn wordt getekend in een spreidingsdiagram.

De x- en y-waarden horen in volgorde bij elkaar - de 1e x met de 1e y, de 2e x met de 2e y, enzovoort. Vul van elk evenveel waarden in (2 paren of meer). Decimalen (met een komma, zoals 3,5) en negatieve getallen mogen.
Resultaat en grafiek
Vul links je x- en y-gegevens in, gescheiden door puntkomma’s, en klik op “Berekenen”. Hier verschijnen het resultaat en een spreidingsdiagram.

Wat je op deze pagina kunt doen

  • Vul paren \(x\)- en \(y\)-gegevens in (twee variabelen) en je ziet meteen de correlatiecoëfficiënt \(r\) en de covariantie \(s_{xy}\)
  • Het gemiddelde, de variantie en de standaardafwijking van \(x\) en van \(y\), en de vergelijking van de regressielijn (kleinste kwadraten) \(y = ax + b\) worden tegelijk berekend
  • Er wordt een spreidingsdiagram getekend met de regressielijn en het gemiddelde punt erbovenop, zodat je in één oogopslag ziet hoe de twee reeksen samenhangen (stijgend, dalend of verspreid)
  • Je krijgt ook een vuistregel voor de waarde, zoals “sterke positieve correlatie” of “weinig of geen correlatie”
  • Een uitleg van de formules in gewone taal en formules om te kopiëren voor Excel, Google Spreadsheets en Python staan ook op deze pagina
De covariantie en de varianties worden berekend met de populatieversie: delen door het aantal paren \(n\). Veel leerboeken en statistiekprogramma’s gebruiken de steekproefversie, die deelt door \(n-1\) (in het onderdeel over Excel staat het verschil). De correlatiecoëfficiënt \(r\) en de regressielijn komen in beide gevallen hetzelfde uit. Je hebt evenveel \(x\)- als \(y\)-waarden nodig, minstens 2 paren.

Waarvoor is deze berekening handig?

De samenhang tussen leertijd en cijfers met getallen controleren (onderwijs)

Een klassiek gebruik van de correlatiecoëfficiënt is controleren of “je cijfers omhooggaan als je meer leert” met gegevens in plaats van op gevoel. Bereken \(r\) uit paren van leertijd en score van elke leerling, en één getal laat zien hoe sterk het verband is.
Scholen en bijlesinstituten kijken soms naar de correlatie tussen vakken bij proefwerken (zijn leerlingen die goed zijn in wiskunde ook goed in natuurkunde?) om hun onderwijs bij te sturen. Maar houd in gedachten dat een correlatie de oorzaak niet bewijst, zoals in “als je maar langer leert, gaat je score altijd omhoog”.

Aan de hand van temperatuur en verkoop bepalen wat je inkoopt (detailhandel en horeca)

De verkoop van ijs en koude dranken heeft bekend een positieve correlatie met de temperatuur, en de verkoop van warme soep en warme chocolademelk een negatieve. Winkels en horecazaken bekijken de correlatie in gegevens uit het verleden over “temperatuur en verkochte aantallen” en passen hun bestellingen en uitstallingen aan op de weersverwachting.
Ga je een stap verder en bepaal je de regressielijn, dan kun je een concrete schatting maken zoals “als de verwachte maximumtemperatuur morgen 30 °C is, verkopen we ongeveer zoveel”.

Risico verlagen door beleggingen te combineren waarvan de koersen verschillend bewegen (financiën en beleggen)

Bij beleggen is de correlatiecoëfficiënt tussen de koersbewegingen van beleggingen zoals aandelen, obligaties en goud een basisinstrument voor spreiding. Combineer je beleggingen met een lage (of negatieve) correlatie, dan is de kans kleiner dat de ene ook daalt als de andere daalt, en blijven de schommelingen van de hele portefeuille kleiner.
Pensioenfondsen en beleggingsfondsen analyseren altijd de correlaties tussen beleggingen voordat ze besluiten hoe ze hun geld verdelen.

De oorzaken van defecten opsporen aan de hand van productieomstandigheden (productie en kwaliteitsbeheersing)

Als er in een fabriek meer defecte producten komen, helpt het om de correlatiecoëfficiënt te bepalen tussen het uitvalpercentage en omstandigheden zoals bewerkingstemperatuur, luchtvochtigheid en draaitijd van de machine. Zo zie je welke omstandigheden samen met de defecten bewegen. Dit is zo’n basismethode dat het spreidingsdiagram ervoor een van de zeven basisinstrumenten van kwaliteitsbeheersing is.
Als je een omstandigheid met een sterke correlatie vindt, is de volgende stap een experiment waarin je die omstandigheid verandert om het causaal verband te bevestigen. Daarna volgen de verbeteringen.

Een beginpunt voor onderzoek naar gezondheid en ziekte (geneeskunde en epidemiologie)

Ook onderzoek naar leefstijl en gezondheid, zoals “beweging en bloeddruk” of “roken en het risico op een ziekte”, begint met het controleren van de correlatie in de gegevens.
Het is ook de plek waar je leert niet van correlatie naar oorzaak te springen. Een bekend voorbeeld is dat de verkoop van ijs en het aantal verdrinkingen een positieve correlatie hebben. Beide nemen gewoon toe door een gemeenschappelijke factor: warm weer. Medisch onderzoek gebruikt veel methoden om het effect van zulke derde factoren weg te halen en dichter bij het echte causaal verband te komen.

Formules en figuren

Covariantie \(s_{xy}\)
Figuur
Wiskundige notatie (de gebruikelijke schrijfwijze)
\(s_{xy}\) \(=\) \(\displaystyle\sum_{i=1}^{n}\) \((x_i - \bar{x})\) \((y_i - \bar{y})\) \(\div\) \(n\)
In woorden (symbolen vervangen door woorden)
⑤ \(s_{xy}\): covariantie \(=\) ③ \(\displaystyle\sum\): alles optellen ① \((x_i - \bar{x})\): afwijking van \(x\) ② \((y_i - \bar{y})\): afwijking van \(y\) \(\div\) ④ \(n\): aantal paren
De formule in woorden
① Neem voor elk paar de afwijking van \(x\) (de \(x\)-waarde min het gemiddelde van \(x\))
② en vermenigvuldig die met de afwijking van \(y\) (de \(y\)-waarde min het gemiddelde van \(y\))
③ Tel daarna al deze producten op \(\displaystyle\sum\)
④ Deel het totaal door \(n\): aantal paren
⑤ en je krijgt de \(s_{xy}\): covariantie
Een eenvoudig voorbeeld
Als de leertijden \(x\) (uren) van 5 leerlingen 1, 2, 3, 4, 5 zijn en hun punten \(y\) 2, 4, 4, 4, 6 (gemiddelden \(\bar{x} = 3\), \(\bar{y} = 4\)), dan is
\(s_{xy}\): covariantie \(=\) som van de producten van de afwijkingen (8) \(\div\) aantal paren (5)
\((-2)(-2) + (-1)(0) + (0)(0) + (1)(0) + (2)(2) = 4 + 0 + 0 + 0 + 4 = 8\)
\(s_{xy} = 8 \div 5 = 1{,}6\)
Het belangrijkste idee
De covariantie drukt “de neiging van twee reeksen gegevens om samen te bewegen” uit in één getal. Hebben veel paren zowel \(x\) als \(y\) boven hun gemiddelde (+ × +) of allebei eronder (− × −), dan is de som van de producten positief. Hebben veel paren maar één van de twee boven het gemiddelde (+ × −), dan is de som negatief. Een positieve covariantie betekent dus: “hoe groter \(x\), hoe groter \(y\) meestal is” (het spreidingsdiagram stijgt naar rechts), een negatieve betekent: “hoe groter \(x\), hoe kleiner \(y\) meestal is” (het diagram daalt naar rechts), en een waarde dicht bij 0 betekent: “geen duidelijke trend”. Op deze pagina wordt gedeeld door het aantal paren \(n\), net als bij de variantie op deze pagina (de populatieversie). Statistiekprogramma’s kennen ook de steekproefcovariantie, die deelt door \(n-1\), en Excel maakt het verschil met de functienaam (zie het onderdeel over Excel).
Correlatiecoëfficiënt \(r\)
Figuur
Wiskundige notatie (de gebruikelijke schrijfwijze)
\(r\) \(=\) \(s_{xy}\) \(\div\) \((\) \(s_x\) \(\times\) \(s_y\) \()\)
In woorden (symbolen vervangen door woorden)
④ \(r\): correlatiecoëfficiënt \(=\) ① \(s_{xy}\): covariantie \(\div\) \((\) ② \(s_x\): standaardafwijking van \(x\) \(\times\) ③ \(s_y\): standaardafwijking van \(y\) \()\)
De formule in woorden
① Deel de \(s_{xy}\): covariantie
② door het product van de \(s_x\): standaardafwijking van \(x\)
③ en de \(s_y\): standaardafwijking van \(y\)
④ en je krijgt de \(r\): correlatiecoëfficiënt (\(r\) ligt altijd tussen \(-1\) en \(1\))
Een eenvoudig voorbeeld
Voor hetzelfde voorbeeld met leertijd en punten (\(s_{xy} = 1{,}6\), \(s_x = \sqrt{2}\), \(s_y = \sqrt{1{,}6}\)) geldt
\(r\): correlatiecoëfficiënt \(=\) covariantie (1,6) \(\div\) \((\) \(\sqrt{2}\) \(\times\) \(\sqrt{1{,}6}\) \()\)
\(s_x \times s_y = \sqrt{2} \times \sqrt{1{,}6} = \sqrt{3{,}2} \approx 1{,}789\)
\(r = 1{,}6 \div 1{,}789 \approx 0{,}894\)
Het belangrijkste idee
De covariantie is handig, maar hangt af van de eenheden (als je alleen uren in minuten omrekent, wordt ze 60 keer zo groot). Deel je de covariantie door de standaardafwijkingen van \(x\) en \(y\), dan krijg je een getal van \(-1\) tot \(1\) dat niet van de eenheden afhangt. Dat is de correlatiecoëfficiënt \(r\). Hoe dichter \(r\) bij \(1\) ligt, hoe sterker de positieve correlatie (dicht bij een rechte lijn die naar rechts stijgt); hoe dichter bij \(-1\), hoe sterker de negatieve correlatie (dicht bij een lijn die naar rechts daalt); en hoe dichter bij \(0\), hoe zwakker het lineaire verband. Een gangbare vuistregel is \(0{,}7 \le |r|\) voor een sterke correlatie, \(0{,}4 \le |r| < 0{,}7\) voor een matige, \(0{,}2 \le |r| < 0{,}4\) voor een zwakke en \(|r| < 0{,}2\) voor weinig of geen correlatie (de grenzen verschillen per vakgebied). Houd er rekening mee dat de correlatiecoëfficiënt alleen een lineair verband meet. Bij een dalparabool kan \(r\) dicht bij 0 liggen, ook al is er wel een verband. Verder is correlatie niet hetzelfde als causaal verband (het ene veroorzaakt het andere).
Regressielijn (kleinste kwadraten) \(y = ax + b\)
Figuur
Wiskundige notatie (de gebruikelijke schrijfwijze)
\(a\) \(=\) \(s_{xy}\) \(\div\) \(s_x^{2}\)
\(b\) \(=\) \(\bar{y}\) \(-\) \(a\,\bar{x}\)
In woorden (symbolen vervangen door woorden)
③ \(a\): richtingscoëfficiënt van de regressielijn \(=\) ① \(s_{xy}\): covariantie \(\div\) ② \(s_x^2\): variantie van \(x\)
⑥ \(b\): snijpunt van de regressielijn met de y-as \(=\) ④ \(\bar{y}\): gemiddelde van \(y\) \(-\) ⑤ richtingscoëfficiënt \(a\) × gemiddelde van \(x\) \(\bar{x}\)
De formule in woorden
① Deel de \(s_{xy}\): covariantie
② door de \(s_x^2\): variantie van \(x\)
③ en je krijgt de \(a\): richtingscoëfficiënt van de regressielijn .
④ Neem het \(\bar{y}\): gemiddelde van \(y\)
⑤ en trek daar het product van de richtingscoëfficiënt \(a\) en het gemiddelde van \(x\), \(\bar{x}\), van af
⑥ en je krijgt het \(b\): snijpunt van de regressielijn met de y-as
Een eenvoudig voorbeeld
Voor hetzelfde voorbeeld (\(s_{xy} = 1{,}6\), \(s_x^2 = 2\), \(\bar{x} = 3\), \(\bar{y} = 4\)) geldt
richtingscoëfficiënt \(a\) \(=\) covariantie (1,6) \(\div\) variantie van \(x\) (2)
\(a = 1{,}6 \div 2 = 0{,}8\)
\(b = 4 - 0{,}8 \times 3 = 1{,}6\)
\(y = 0{,}8x + 1{,}6\)
Het belangrijkste idee
De regressielijn is de rechte lijn die het best past bij de puntenwolk van een spreidingsdiagram. De lijn wordt zo gekozen dat de verticale afstanden (fouten) tussen elk punt en de lijn, gekwadrateerd en bij elkaar opgeteld, zo klein mogelijk zijn. Deze manier om de lijn te kiezen heet de kleinste-kwadratenmethode (je hebt alleen de deling en aftrekking hierboven nodig). De regressielijn gaat altijd door het gemiddelde punt \((\bar{x},\ \bar{y})\). Dat kun je controleren in het spreidingsdiagram op deze pagina. Met de regressielijn kun je voorspellingen doen, zoals “bij 3,5 uur leren is het aantal punten ongeveer \(0{,}8 \times 3{,}5 + 1{,}6 = 4{,}4\)”. Maar voorspellingen waarbij je de lijn ver buiten het bereik van de gegevens doortrekt, zijn niet betrouwbaar, en bij een zwakke correlatie zegt een voorspelling met de lijn heel weinig. Deze pagina schrijft de lijn als \(y = ax + b\) (\(a\) is de richtingscoëfficiënt, \(b\) het snijpunt met de y-as), zoals in de wiskundeboeken van havo en vwo. Sommige statistiekboeken schrijven \(\hat{y} = a + bx\), met de letters voor richtingscoëfficiënt en snijpunt omgewisseld.
Zo vind je de correlatiecoëfficiënt: (1) bepaal de gemiddelden van \(x\) en \(y\), (2) tel alle producten van afwijkingen \((x_i - \bar{x})(y_i - \bar{y})\) op en deel door het aantal paren \(n\) voor de covariantie \(s_{xy}\), en (3) deel de covariantie door het product van de standaardafwijkingen van \(x\) en \(y\). \(r\) ligt altijd tussen \(-1\) en \(1\). Hoe dichter bij \(1\), hoe sterker het lineaire verband dat naar rechts stijgt; hoe dichter bij \(-1\), hoe sterker het verband dat naar rechts daalt.

Symbolen en begrippen

Symbolen

\(x_i,\ y_i\) x index i, y index i De \(x\)-waarde en de \(y\)-waarde van het \(i\)-de paar. (Voorbeeld: de leertijd \(x_3\) en de score \(y_3\) van de 3e leerling.) \(i\) is een letter die vaak voor een index (volgnummer) wordt gebruikt.
\(n\) n Het aantal paren, van de eerste letter van “aantal”. (Voorbeeld: bij paren van 5 leerlingen is \(n = 5\))
\(\bar{x},\ \bar{y}\) x-streep, y-streep De gemiddelden van \(x\) en van \(y\). Een streep boven een letter is de gebruikelijke manier om een gemiddelde aan te geven.
\(x_i - \bar{x}\) x index i min x-streep De afwijking van \(x\). Ze laat zien hoever elke waarde van het gemiddelde van \(x\) af ligt. \(y_i - \bar{y}\) is de afwijking van \(y\).
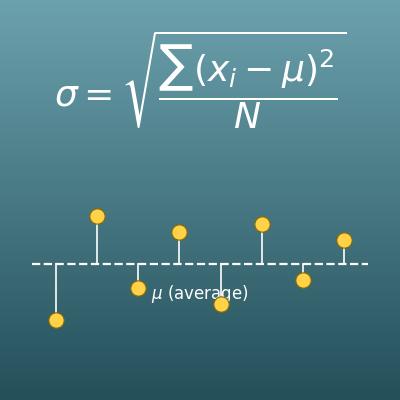
\(s_{xy}\) s index x y De covariantie van \(x\) en \(y\), het gemiddelde van de producten van de afwijkingen. Ze laat de neiging van de twee reeksen zien om samen te bewegen. De letter \(s\) wordt gebruikt voor grootheden uit dezelfde familie als de standaardafwijking.
\(s_x,\ s_y\) s index x, s index y De standaardafwijkingen van \(x\) en van \(y\) (hoe verspreid elk is). Ze zijn de wortels van de varianties.
\(s_x^2,\ s_y^2\) s index x kwadraat, s index y kwadraat De varianties van \(x\) en van \(y\), het gemiddelde van de gekwadrateerde afwijkingen (gedeeld door \(n\)).
\(r\) r De correlatiecoëfficiënt. De letter komt van de \(r\) in “correlatie” of “relatie”. Ze ligt altijd tussen \(-1\) en \(1\).
\(\sum\) sigma (somteken) Een symbool dat “alles optellen” betekent. \(\sum_{i=1}^{n}\) lees je als “de som van \(i = 1\) tot \(n\)”.
\(a,\ b\) a, b De richtingscoëfficiënt en het snijpunt met de y-as van de regressielijn \(y = ax + b\). Ze hebben dezelfde rol als \(a\) en \(b\) in een lineaire formule.

Begrippen

correlatie Een lineaire samenhang tussen twee reeksen gegevens, waarbij de ene toeneemt als de andere toeneemt (of afneemt). Hoe sterker ze is, hoe dichter de punten in een spreidingsdiagram bij een rechte lijn liggen.
positieve correlatie De neiging van \(y\) om toe te nemen als \(x\) toeneemt. Het spreidingsdiagram stijgt naar rechts en de correlatiecoëfficiënt is positief.
negatieve correlatie De neiging van \(y\) om af te nemen als \(x\) toeneemt. Het spreidingsdiagram daalt naar rechts en de correlatiecoëfficiënt is negatief.
correlatiecoëfficiënt Eén getal van \(-1\) tot \(1\) dat de sterkte en de richting van een correlatie aangeeft (ook wel de correlatiecoëfficiënt van Pearson). Je vindt het door de covariantie te delen door het product van de standaardafwijkingen van \(x\) en \(y\). Omdat het niet van de eenheden afhangt, kun je de sterkte bij verschillende gegevens met elkaar vergelijken.
covariantie Het gemiddelde van de producten van de afwijkingen van \(x\) en \(y\). Positief betekent een neiging om naar rechts te stijgen, negatief een neiging om naar rechts te dalen. Op deze pagina wordt gedeeld door het aantal paren \(n\) (de populatieversie).
spreidingsdiagram Een grafiek die paargewijze gegevens \((x,\ y)\) als punten in een assenstelsel zet. Aan de ligging van de punten zie je in één oogopslag de richting en de sterkte van een correlatie.
variabele Een grootheid die je als gegeven meet, zoals lengte, score of temperatuur. Deze pagina onderzoekt het verband tussen twee variabelen, \(x\) en \(y\).
afwijking Het verschil tussen een waarde en het gemiddelde. Positief betekent boven het gemiddelde, negatief eronder. De covariantie, de variantie en de standaardafwijking zijn allemaal opgebouwd uit afwijkingen.
variantie Het gemiddelde van de gekwadrateerde afwijkingen. Ze geeft aan hoe groot de spreiding van de gegevens is. Ze komt voor in de noemer van de richtingscoëfficiënt van de regressielijn.
standaardafwijking De wortel uit de variantie. De eenheid is weer dezelfde als die van de gegevens, waardoor ze handig is als maat voor de spreiding. Ze komt voor in de noemer van de correlatiecoëfficiënt.
regressielijn De rechte lijn \(y = ax + b\) die het best past bij de puntenwolk van een spreidingsdiagram. Je gebruikt haar om een \(y\)-waarde te voorspellen uit een \(x\)-waarde.
kleinste-kwadratenmethode Een manier om de richtingscoëfficiënt en het snijpunt van een lijn te kiezen zodat de verticale afstanden (fouten) tussen elk punt en de lijn, gekwadrateerd en opgeteld, zo klein mogelijk zijn. De regressielijn is de lijn die op deze manier is gekozen.
uitschieter Een waarde die ver van de andere punten af ligt. De correlatiecoëfficiënt wordt sterk beïnvloed door uitschieters, dus bekijk haar altijd samen met het spreidingsdiagram.
samenhang Een verband waarbij twee grootheden samen bewegen (als de ene toeneemt, neemt de andere toe of af). Ook bij een correlatie is het ene niet per se de oorzaak van het andere (causaal verband). Er kan gewoon een gemeenschappelijke oorzaak achter beide zitten (een derde factor, ook wel verstorende variabele genoemd).
causaal verband (oorzakelijk verband) Een verband waarbij het ene de oorzaak is en het andere het gevolg. Alleen een samenhang (samen bewegen) laat geen causaal verband zien; er kan gewoon een gemeenschappelijke oorzaak achter beide zitten (een derde factor).

Handig om vooraf te weten

Dit is wat je helpt om de berekening op deze pagina echt te begrijpen, en niet alleen op de knop te drukken.
Loop je vast, dan is het de snelste weg vooruit om deze onderwerpen te herhalen.

Het gemiddelde (groep 7-8, 10-12 jaar)
  • Weten dat gemiddelde = som ÷ aantal
  • Weten dat het gemiddelde ongeveer aangeeft waar het midden van de gegevens ligt
Negatieve getallen (klas 1, 12-13 jaar)
  • Kunnen vermenigvuldigen met negatieve getallen, zoals in \((-1) \times 2 = -2\) en \((-2) \times (-2) = 4\)
  • Weten dat min keer min plus is (dit is de basis voor wat het teken van de covariantie betekent)
Coördinaten en lineaire functies (klas 1-2, 12-14 jaar)
  • Een paar \((x,\ y)\) kunnen uitzetten als punt in het assenstelsel (een spreidingsdiagram is een verzameling van zulke punten)
  • Weten dat in een lineaire functie \(y = ax + b\) de \(a\) de richtingscoëfficiënt is en \(b\) het snijpunt met de y-as (de regressielijn heeft deze vorm)
Wortels (klas 3, 14-15 jaar)
  • Een wortel kennen als “het getal dat dit getal geeft als je het kwadrateert”, zoals in \(\sqrt{9} = 3\)
  • Wortels kunnen vermenigvuldigen, zoals in \(\sqrt{2} \times \sqrt{1{,}6} = \sqrt{3{,}2}\)
Statistiek (onderbouw en bovenbouw havo/vwo, 13-17 jaar)
  • Weten wat een afwijking (het verschil tussen een waarde en het gemiddelde) aangeeft
  • Weten dat de variantie en de standaardafwijking de grootte van de spreiding in een getal uitdrukken (je kunt ze herhalen op de verwante pagina over de standaardafwijking berekenen)
  • Kunnen aflezen uit een spreidingsdiagram of de punten naar rechts stijgen, naar rechts dalen of verspreid liggen

Berekenen met Excel

Kopieer de hele tabel hieronder en plak die in cel A1 van Excel. Het werkt direct.
Tabel om de covariantie s_xy te vinden
x van paar 1 1
x van paar 2 2
x van paar 3 3
x van paar 4 4
x van paar 5 5
y van paar 1 2
y van paar 2 4
y van paar 3 4
y van paar 4 4
y van paar 5 6
Covariantie s_xy (delen door n) =COVARIANTIE.P(B1:B5;B6:B10)
(Ter vergelijking) steekproefcovariantie, delen door n−1 =COVARIANTIE.S(B1:B5;B6:B10)
Tabel om de correlatiecoëfficiënt r te vinden
x van paar 1 1
x van paar 2 2
x van paar 3 3
x van paar 4 4
x van paar 5 5
y van paar 1 2
y van paar 2 4
y van paar 3 4
y van paar 4 4
y van paar 5 6
Correlatiecoëfficiënt r =CORRELATIE(B1:B5;B6:B10)
(Ter vergelijking) dezelfde waarde met PEARSON =PEARSON(B1:B5;B6:B10)
Tabel om de regressielijn y = ax + b te vinden
x van paar 1 1
x van paar 2 2
x van paar 3 3
x van paar 4 4
x van paar 5 5
y van paar 1 2
y van paar 2 4
y van paar 3 4
y van paar 4 4
y van paar 5 6
Richtingscoëfficiënt a =RICHTING(B6:B10;B1:B5)
Snijpunt met de y-as b =SNIJPUNT(B6:B10;B1:B5)
Tabel om de gemiddelden, varianties en standaardafwijkingen te vinden (delen door n)
x van paar 1 1
x van paar 2 2
x van paar 3 3
x van paar 4 4
x van paar 5 5
y van paar 1 2
y van paar 2 4
y van paar 3 4
y van paar 4 4
y van paar 5 6
Gemiddelde van x x̄ =GEMIDDELDE(B1:B5)
Gemiddelde van y ȳ =GEMIDDELDE(B6:B10)
Variantie van x s_x² =VARP(B1:B5)
Standaardafwijking van x s_x =STDEVP(B1:B5)
Variantie van y s_y² =VARP(B6:B10)
Standaardafwijking van y s_y =STDEVP(B6:B10)
Na het plakken zijn B1 tot en met B5 de cellen voor x, B6 tot en met B10 de cellen voor y, en worden de cellen in vet groen automatisch berekend.
De covariantie in de eerste tabel is 1,6 (de steekproefcovariantie is 2), de correlatiecoëfficiënt in de tweede tabel is ongeveer 0,8944 en de derde tabel geeft een richtingscoëfficiënt van 0,8 en een snijpunt van 1,6.
Let op: er zijn twee functies voor de covariantie. COVARIANTIE.P is de covariantie die deelt door n (hetzelfde als deze rekenmachine) en COVARIANTIE.S is de steekproefcovariantie die deelt door n − 1. In oude versies van Excel (2007 en eerder) gebruik je COVARIANTIE in plaats van COVARIANTIE.P.
CORRELATIE en PEARSON geven dezelfde correlatiecoëfficiënt (r is hetzelfde of je nu deelt door n of door n − 1, dus er valt niets te kiezen).
RICHTING en SNIJPUNT vragen “het y-bereik, het x-bereik” in die volgorde (let op: x komt niet eerst).
Wil je een ander aantal paren gebruiken, voeg dan rijen met getallen toe (of haal ze weg) en pas “B1:B5” en “B6:B10” in de formules aan naar je eigen gegevensbereiken.

Berekenen met Google Spreadsheets

Kopieer de hele tabel hieronder en plak die in cel A1 van Google Spreadsheets. Het werkt direct.
Tabel om de covariantie s_xy te vinden
x van paar 1 1
x van paar 2 2
x van paar 3 3
x van paar 4 4
x van paar 5 5
y van paar 1 2
y van paar 2 4
y van paar 3 4
y van paar 4 4
y van paar 5 6
Covariantie s_xy (delen door n) =COVARIANTIE(B1:B5;B6:B10)
Tabel om de correlatiecoëfficiënt r te vinden
x van paar 1 1
x van paar 2 2
x van paar 3 3
x van paar 4 4
x van paar 5 5
y van paar 1 2
y van paar 2 4
y van paar 3 4
y van paar 4 4
y van paar 5 6
Correlatiecoëfficiënt r =CORRELATIE(B1:B5;B6:B10)
Tabel om de regressielijn y = ax + b te vinden
x van paar 1 1
x van paar 2 2
x van paar 3 3
x van paar 4 4
x van paar 5 5
y van paar 1 2
y van paar 2 4
y van paar 3 4
y van paar 4 4
y van paar 5 6
Richtingscoëfficiënt a =RICHTING(B6:B10;B1:B5)
Snijpunt met de y-as b =SNIJPUNT(B6:B10;B1:B5)
Bijna dezelfde functies als in Excel werken ongewijzigd. Kopieer de hele tabel, plak ze in cel A1 en vervang B1 tot en met B10 door je eigen getallen.
In Google Spreadsheets vind je de covariantie die deelt door n met de functie COVARIANTIE (dezelfde definitie als deze rekenmachine; ook de naam COVARIANTIE.P roept dezelfde functie aan). De correlatiecoëfficiënt gebruikt CORRELATIE, net als Excel.

Berekenen met Python

import statistics

xs = [1, 2, 3, 4, 5]      # x-gegevens (voorbeeld: leertijd)
ys = [2, 4, 4, 4, 6]      # y-gegevens (voorbeeld: punten voor een overhoring)

n = len(xs)
mean_x = statistics.mean(xs)      # gemiddelde van x
mean_y = statistics.mean(ys)      # gemiddelde van y

# covariantie s_xy (populatieversie: delen door n)
covariance = sum((x - mean_x) * (y - mean_y) for x, y in zip(xs, ys)) / n

sd_x = statistics.pstdev(xs)      # standaardafwijking van x (delen door n)
sd_y = statistics.pstdev(ys)      # standaardafwijking van y (delen door n)

r = covariance / (sd_x * sd_y)    # correlatiecoëfficiënt

slope = covariance / statistics.pvariance(xs)   # richtingscoëfficiënt a van de regressielijn
intercept = mean_y - slope * mean_x             # snijpunt b van de regressielijn met de y-as

print(f"Covariantie s_xy: {covariance}")
print(f"Correlatiecoëfficiënt r: {r}")
# het snijpunt kan een afrondingsfout van drijvende komma tonen (1.5999...), dus rond af op 10 significante cijfers
print(f"Regressielijn: y = {slope:.10g}x + {intercept:.10g}")
Werkt met alleen de standaardbibliotheek (de module statistics). pstdev en pvariance, die met “p” beginnen, delen door n. Voer je dit voorbeeld uit, dan zie je een covariantie van 1,6, een correlatiecoëfficiënt van 0,894… en de regressielijn y = 0,8x + 1,6. In Python 3.10 en later geeft statistics.correlation(xs, ys) dezelfde correlatiecoëfficiënt (r is hetzelfde of je nu deelt door n of door n − 1). Let op dat statistics.covariance(xs, ys) de steekproefcovariantie is die deelt door n − 1. Wil je dezelfde covariantie als op deze pagina, bereken die dan zoals in het voorbeeld hierboven.

De formule in LaTeX en andere wiskundenotaties (om te kopiëren)

Covariantie \(s_{xy}\)
s_xy = {(x₁ − x̄)(y₁ − ȳ) + … + (xₙ − x̄)(yₙ − ȳ)} ÷ n
s_{xy} = \dfrac{1}{n}\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
    <mo>=</mo>
    <mfrac><mn>1</mn><mi>n</mi></mfrac>
    <munderover>
      <mo>&#x2211;</mo>
      <mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
      <mi>n</mi>
    </munderover>
    <mrow>
      <mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>&#x2212;</mo><mover><mi>x</mi><mo>&#x00AF;</mo></mover><mo>)</mo>
      <mo>(</mo><msub><mi>y</mi><mi>i</mi></msub><mo>&#x2212;</mo><mover><mi>y</mi><mo>&#x00AF;</mo></mover><mo>)</mo>
    </mrow>
  </mrow>
</math>
s_(xy) = (1/n) sum_(i=1)^n (x_i - bar x)(y_i - bar y)
Covariance[xdata, ydata]*(Length[xdata] - 1)/Length[xdata]  (* Covariance deelt door n-1, dus dit rekent om naar de waarde gedeeld door n *)
s_xy := add((x[i] - x_bar)*(y[i] - y_bar), i = 1 .. n)/n;
s_xy = mean((x - mean(x)).*(y - mean(y)));
s_xy = (1/n) ∑_(i=1)^n (x_i − x̄)(y_i − ȳ)
Correlatiecoëfficiënt \(r\)
r = s_xy ÷ (s_x × s_y)
r = \dfrac{s_{xy}}{s_x\, s_y}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>r</mi>
    <mo>=</mo>
    <mfrac>
      <msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
      <mrow><msub><mi>s</mi><mi>x</mi></msub><msub><mi>s</mi><mi>y</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
r = s_(xy) / (s_x s_y)
Correlation[xdata, ydata]
r := s_xy/(s_x*s_y);
R = corrcoef(x, y); r = R(1, 2);
r = s_xy/(s_x s_y)
Regressielijn (kleinste kwadraten) \(y = ax + b\)
y = ax + b,  a = s_xy ÷ s_x²,  b = ȳ − a·x̄
y = ax + b, \quad a = \dfrac{s_{xy}}{s_x^{2}}, \quad b = \bar{y} - a\bar{x}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>y</mi><mo>=</mo><mi>a</mi><mi>x</mi><mo>+</mo><mi>b</mi>
    <mo>,</mo><mspace width="1em"/>
    <mi>a</mi><mo>=</mo>
    <mfrac>
      <msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
      <msubsup><mi>s</mi><mi>x</mi><mn>2</mn></msubsup>
    </mfrac>
    <mo>,</mo><mspace width="1em"/>
    <mi>b</mi><mo>=</mo>
    <mover><mi>y</mi><mo>&#x00AF;</mo></mover>
    <mo>&#x2212;</mo>
    <mi>a</mi><mover><mi>x</mi><mo>&#x00AF;</mo></mover>
  </mrow>
</math>
y = a x + b, a = s_(xy)/s_x^2, b = bar y - a bar x
lm = LinearModelFit[Transpose[{xdata, ydata}], t, t]; lm["BestFitParameters"]
a := s_xy/s_x^2; b := y_bar - a*x_bar;
p = polyfit(x, y, 1);  % p(1) = richtingscoëfficiënt a, p(2) = snijpunt b
y = ax + b,  a = s_xy/s_x^2,  b = ȳ − ax̄

Zo laat je ChatGPT  de berekening doen

Je bent een assistent voor statistische berekeningen. Voer de volgende berekening uit door echt Python-code uit te voeren, en baseer je antwoord alleen op de getallen uit het uitvoerresultaat (geen hoofdrekenen of gokken).

Zoek voor de volgende gepaarde gegevens elk van de onderstaande waarden.
x: 1, 2, 3, 4, 5
y: 2, 4, 4, 4, 6
1. De gemiddelden van x en y, en hun varianties en standaardafwijkingen met delen door n
2. De covariantie s_xy (de som van de producten van de afwijkingen gedeeld door het aantal paren n; deel niet door n − 1)
3. De correlatiecoëfficiënt r
4. De richtingscoëfficiënt a en het snijpunt b van de regressielijn y = ax + b (kleinste kwadraten)

Laat de formules zien die je hebt gebruikt en de getallen uit het uitvoerresultaat.

Zo werkt het
  1. 1
    Vul je getallen in
    Typ de getallen waarmee je wilt rekenen in de invoervelden
  2. 2
    Bereken
    Klik op de knop “Berekenen”
  3. 3
    Bekijk het resultaat
    Het resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
  Kenmerken van DataChef
Eenvoudig en gratis
Onbeperkt gratis converteren
Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Geen registratie nodig
Direct te gebruiken
Zonder persoonlijke gegevens op te geven

Veilig en betrouwbaar
Sterk versleutelde verbinding (SSL)
Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt

Snel
Snelle laadtijden en snelle conversie
Zonder watermerk
Geen watermerk
Geen bronvermelding vereist
Commercieel gebruik toegestaan
Gratis voor commercieel gebruik
Geen toestemming vooraf nodig