Vul maar één veld in: Z (de toetsingsgrootheid) of een van de vijf kansen. Alle andere waarden worden berekend (het rekent in beide richtingen om, van Z naar een p-waarde en van een p-waarde naar Z).
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formule en grafiek
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Vul de toetsingsgrootheid Z in uit een z-toets of iets dergelijks en je krijgt in één keer de p-waarden voor linkszijdig, rechtszijdig en tweezijdig toetsen
- Je kunt ook van een p-waarde terugrekenen naar Z (vind bijvoorbeeld Z = 1,96 bij een tweezijdige p-waarde van 0,05). Handig om de rand van het verwerpingsgebied (de kritieke waarde) te vinden
- De kansen “tussen 0 en Z” en “tussen −Z en Z” worden ook getoond, dus je kunt het ook gebruiken in plaats van een tabel van de standaardnormale verdeling (z-tabel)
- Een uitleg van de formules in gewone taal en formules om te kopiëren voor Excel, Google Spreadsheets en Python staan ook op deze pagina
Waarvoor is deze berekening handig?
Klinische studies naar een nieuw medicijn gebruiken een hypothesetoets om na te gaan “valt het verschil tussen de groep die het medicijn nam en de groep die het niet nam binnen het bereik van toeval?”, en de p-waarde is het bewijs voor die beslissing. Een toetsingsgrootheid van \(Z = 2{,}5\) geeft bijvoorbeeld een tweezijdige p-waarde van ongeveer 0,012, en dat lees je als “als het medicijn geen effect had, is de kans op een verschil zo groot ongeveer 1,2%”.
Medische artikelen over de hele wereld rapporteren effecten zo. Als je weet wat een p-waarde is, kun je gezondheidsnieuws een stap dieper lezen (echte medische beslissingen worden genomen door deskundigen die niet alleen de p-waarde meewegen maar ook de grootte van het effect en de bijwerkingen).
“We hebben de kleur van de knop veranderd en het doorklikpercentage ging omhoog. Maar was het gewoon toeval?” De toets in een A/B-test beantwoordt dat. Een toetsingsgrootheid van \(Z = 2{,}17\) geeft bijvoorbeeld een tweezijdige p-waarde van ongeveer 0,03, kleiner dan het significantieniveau van 0,05, dus je kunt concluderen “een verbetering die moeilijk door toeval te verklaren is”.
Online bedrijven gebruiken deze p-waarde elke dag om te beslissen of ze veranderingen in ontwerp en tekst overnemen.
Gegevens uit steekproefcontroles worden getoetst om te zien of het gemiddelde gewicht of de gemiddelde afmeting van producten van de doelwaarde is afgedreven. Een toetsingsgrootheid van \(Z = 2\) geeft bijvoorbeeld een tweezijdige p-waarde van ongeveer 0,046, dus bij een significantieniveau van 5% concludeer je “er is iets veranderd in het proces” en zoek je de oorzaak.
De kracht van de p-waarde is dat ze “toevallige variatie” scheidt van “een echt probleem”, zodat de beslissing om een machine stil te zetten met getallen kan worden genomen en niet op gevoel.
Wetenschappelijke artikelen staan vol met zinnen als “significant bij p < 0,05” en “p = 0,003”. Bij een tweezijdige toets komt p < 0,05 overeen met “\(|Z|\) is groter dan 1,96” en p < 0,01 met “groter dan ongeveer 2,58”.
Als je dit verband kent, kun je statistische resultaten in scripties en verslagen juist rapporteren en onthoud je makkelijker een belangrijk punt bij het lezen van artikelen: “significant” is niet altijd hetzelfde als belangrijk (de grootte van het verschil is een aparte vraag).
Met een hypothesetoets kun je ook nagaan of een verandering zoals “de tevredenheid met het kabinet is 2 procentpunt hoger dan vorige maand” een echte verandering is of alleen de variatie (fout) van de peiling. Een toetsingsgrootheid van \(Z = 1\) geeft bijvoorbeeld een tweezijdige p-waarde van ongeveer 0,32, “ongeveer 1 keer op de 3 bij toeval, ook zonder echt verschil”, dus het is natuurlijk om het binnen de foutmarge te noemen.
Het is een handige, alledaagse manier van denken met statistiek: voordat je blij of bezorgd wordt over getallen in het nieuws, vraag je “is dat verschil significant?”.
Formule en grafiek
Symbolen en begrippen
Symbolen
| \(P\) | pee | De p-waarde: de kans om bij toeval een uitkomst te krijgen die minstens zo extreem is als de waargenomen uitkomst, als de nulhypothese waar is. Hoe kleiner ze is, hoe moeilijker het is de uitkomst door toeval te verklaren. |
| \(Z\) | zet | De toetsingsgrootheid (de z-waarde), berekend uit de gegevens en beschouwd als verdeeld volgens de standaardnormale verdeling. Deze pagina vindt p-waarden uit Z. Het berekenen van een z-score zelf staat op de verwante pagina, de rekenmachine voor de z-score. |
| \(\Phi(Z)\) | fi van Z | De cumulatieve verdelingsfunctie van de standaardnormale verdeling (gemiddelde 0, standaardafwijking 1). Ze geeft de kans op een waarde kleiner dan \(Z\), dat is de oppervlakte onder de kromme links van \(Z\). |
| \(\Phi^{-1}\) | fi invers (inverse van Φ) | De functie die andersom werkt dan \(\Phi\). Ze neemt een kans (oppervlakte) en geeft de Z die daarbij hoort. Deze rekenmachine gebruikt haar om van een p-waarde terug te rekenen naar Z. (Voorbeeld: \(\Phi^{-1}(0{,}975) \approx 1{,}96\)) |
| \(|Z|\) | absolute waarde van Z | De grootte van \(Z\) zonder het teken. Een tweezijdige toets telt een afwijking aan de plus-kant en aan de min-kant als dezelfde “extremiteit”, dus gebruikt ze de absolute waarde. (Voorbeeld: \(|-1{,}5| = 1{,}5\)) |
| \(\alpha\) | alfa | Het significantieniveau: de grenskans die je vooraf kiest, zoals in “verwerp de nulhypothese als de p-waarde gelijk is aan of kleiner is dan dit”. Gebruikelijk zijn 0,05 (5%) en 0,01 (1%). |
Begrippen
| p-waarde (overschrijdingskans) | De kans om een uitkomst te krijgen die minstens zo extreem is als de waargenomen uitkomst, als de nulhypothese waar is. Hoe kleiner de p-waarde, hoe moeilijker te geloven is dat de uitkomst door toeval is ontstaan, en hoe sterker de redenen om de nulhypothese te verwerpen. |
| hypothesetoets | Een procedure waarbij je eerst aanneemt dat “er geen verschil is”, met een p-waarde meet hoe onwaarschijnlijk de werkelijke gegevens onder die aanname zijn, en beslist of je de aanname laat vallen. Het werkt ongeveer als een bewijs uit het ongerijmde: als er iets heel zeldzaams gebeurde, twijfel dan aan de aanname waarmee je begon. |
| nulhypothese | De standaardaanname die je wilt weerleggen, zoals “er is geen verschil tussen de twee groepen” of “er is geen effect”. De p-waarde wordt berekend onder de aanname dat de nulhypothese waar is. |
| alternatieve hypothese | De bewering die tegenover de nulhypothese staat (“er is een verschil”, “er is een effect”). Het is de hypothese die je aanneemt als de nulhypothese wordt verworpen. |
| significantieniveau | De grenskans om de nulhypothese te verwerpen, geschreven als \(\alpha\) (alfa). De regel is dat je haar kiest voordat je de toets uitvoert, en 0,05 wordt het meest gebruikt. Is de p-waarde gelijk aan of kleiner dan het significantieniveau, dan heet de uitkomst “statistisch significant”. |
| verwerpen | De nulhypothese aan de kant zetten als “moeilijk te geloven” op grond van de toets. Je verwerpt haar als de p-waarde gelijk is aan of kleiner is dan het significantieniveau. Let op: niet verwerpen zegt niet “de nulhypothese is waar”; het zegt alleen “er is niet genoeg bewijs om haar te verwerpen”. |
| tweezijdige toets | Een toets die een afwijking in beide richtingen, te groot of te klein, als verschil beschouwt. De p-waarde is de som van de oppervlakten in beide staarten van de verdeling. Het is de gebruikelijke keuze als je de richting niet vooraf kunt bepalen. |
| eenzijdige toets | Een toets die alleen naar afwijkingen in één richting kijkt, alleen groter (rechtszijdig) of alleen kleiner (linkszijdig). Je gebruikt hem als de theorie je vooraf de richting vertelt, en de p-waarde is de oppervlakte in die ene staart. |
| toetsingsgrootheid | De waarde die je uit de gegevens berekent voor een toets. Bij een z-toets is het omgezet in een vorm die wordt beschouwd als verdeeld volgens de standaardnormale verdeling (de z-waarde), en die zegt hoeveel standaardafwijkingen de uitkomst van het gemiddelde ligt. |
| standaardnormale verdeling | De normale verdeling met gemiddelde 0 en standaardafwijking 1 (een symmetrische klokvorm). De oppervlakte onder de kromme is de kans, en de totale oppervlakte is precies 1. De p-waarde van een z-toets wordt berekend als de oppervlakte in de staarten van deze verdeling. |
| kritieke waarde | De grenswaarde van de toetsingsgrootheid waarboven je de nulhypothese verwerpt. Bij een tweezijdige toets met een significantieniveau van 5% is ze \(|Z| \approx 1{,}96\) en bij 1% is ze \(|Z| \approx 2{,}576\). Je kunt dit controleren door met deze rekenmachine van een p-waarde terug te rekenen naar Z. |
Handig om vooraf te weten
Dit is wat je helpt om de berekening op deze pagina echt te begrijpen, en niet alleen op de knop te drukken.
| Basis van kansrekening (klas 2-3, 13-15 jaar) |
|
| Gegevens analyseren en standaardafwijking (bovenbouw havo/vwo, 15-18 jaar) |
|
| De normale verdeling en oppervlakten lezen (bovenbouw havo/vwo, 15-18 jaar) |
|
| Het idee van toetsen (bovenbouw havo/vwo, 16-18 jaar) |
|
Berekenen met Excel
| Z (toetsingsgrootheid) | -1,5 |
| Linkszijdig P(x<Z) | =NORM.S.VERD(B1;WAAR) |
| Z (toetsingsgrootheid) | 2 |
| Rechtszijdig P(x>Z) | =1-NORM.S.VERD(B1;WAAR) |
| Z (toetsingsgrootheid) | 1,96 |
| Tweezijdige p-waarde | =2*(1-NORM.S.VERD(ABS(B1);WAAR)) |
“NORM.S.VERD(waarde; WAAR)” is de functie voor de cumulatieve verdelingsfunctie \(\Phi\) (de oppervlakte links van Z), en WAAR zegt dat ze “de cumulatieve waarde (de oppervlakte links) moet geven”. “ABS” geeft de absolute waarde (de grootte zonder teken).
De eerste tabel toont in B2 ongeveer 0,0668 (ongeveer 6,7%), de tweede ongeveer 0,02275 (ongeveer 2,3%) en de derde ongeveer 0,05 (5%). Vervang gewoon B1 door je eigen Z.
Wil je de andere kant op, “van een p-waarde naar Z”, gebruik dan “=NORM.S.INV(kans)” (voorbeeld: de Z voor een tweezijdige p-waarde van 0,05 is `=NORM.S.INV(1-0,05/2)`, ongeveer 1,95996).
Berekenen met Google Spreadsheets
| Z (toetsingsgrootheid) | -1,5 |
| Linkszijdig P(x<Z) | =STAND.NORM.VERD(B1) |
| Z (toetsingsgrootheid) | 2 |
| Rechtszijdig P(x>Z) | =1-STAND.NORM.VERD(B1) |
| Z (toetsingsgrootheid) | 1,96 |
| Tweezijdige p-waarde | =2*(1-STAND.NORM.VERD(ABS(B1))) |
De resultaten zijn dezelfde als in de Excel-versie: ongeveer 0,0668 in de eerste tabel, ongeveer 0,02275 in de tweede en ongeveer 0,05 in de derde.
Om Z te vinden uit een p-waarde gebruik je “=STAND.NORM.INV(kans)” (voorbeeld: `=STAND.NORM.INV(1-0,05/2)` is ongeveer 1,95996).
Berekenen met Python
import math

def phi(z):
    # Cumulatieve verdelingsfunctie van de standaardnormale verdeling, Φ(z) (berekend met de foutfunctie erf)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

z = 1.96  # Z (toetsingsgrootheid)

p_left = phi(z)                       # linkszijdige p-waarde P(x<Z)
p_right = 1 - phi(z)                  # rechtszijdige p-waarde P(x>Z)
p_two_sided = 2 * (1 - phi(abs(z)))   # tweezijdige p-waarde

print(f"Linkszijdige p-waarde: {p_left}")
print(f"Rechtszijdige p-waarde: {p_right}")
print(f"Tweezijdige p-waarde: {p_two_sided}")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
P = Φ(Z)
P = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = Phi(Z)
CDF[NormalDistribution[0, 1], z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), z);
p = normcdf(z);
P = Φ(Z)
P = 1 − Φ(Z)
P = 1 - \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = 1 - Phi(Z)
1 - CDF[NormalDistribution[0, 1], z]
with(Statistics): 1 - CDF(RandomVariable(Normal(0, 1)), z);
p = 1 - normcdf(z);
P = 1 - Φ(Z)
P = 2(1 − Φ(|Z|))
P = 2\left(1 - \Phi(|Z|)\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>2</mn>
<mo>(</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>Z</mi><mo>|</mo><mo>)</mo>
<mo>)</mo>
</mrow>
</math>
P = 2(1 - Phi(|Z|))
2 (1 - CDF[NormalDistribution[0, 1], Abs[z]])
with(Statistics): 2*(1 - CDF(RandomVariable(Normal(0, 1)), abs(z)));
p = 2*(1 - normcdf(abs(z)));
P = 2(1 - Φ(|Z|))
Zo laat je ChatGPT de berekening doen
Je bent een assistent voor statistische berekeningen. Voer de volgende berekening uit door echt Python-code uit te voeren, en baseer je antwoord alleen op de getallen uit het uitvoerresultaat (geen hoofdrekenen of gokken).

Een z-toets gaf een toetsingsgrootheid Z = 2,5. Neem aan dat de toetsingsgrootheid de standaardnormale verdeling volgt (je mag de standaardbibliotheek van Python gebruiken, zoals math.erf of statistics.NormalDist).
Bereken elk van de volgende waarden:
1. De linkszijdige p-waarde P(x<Z)
2. De rechtszijdige p-waarde P(x>Z)
3. De tweezijdige p-waarde P(x<−Z of x>Z)
4. Of de nulhypothese kan worden verworpen bij een tweezijdige toets met significantieniveau 0,05

Laat de formules zien die je hebt gebruikt en de getallen uit het uitvoerresultaat.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
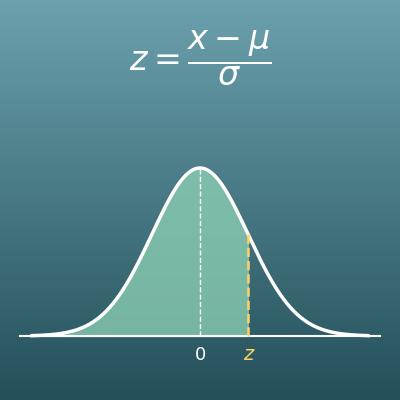
Z-score berekenen: z-score naar kans en terug
Berekent de z-score uit een waarde, gemiddelde en standaardafwijking. Je kunt het ook gebruiken in plaats van een z-tabel
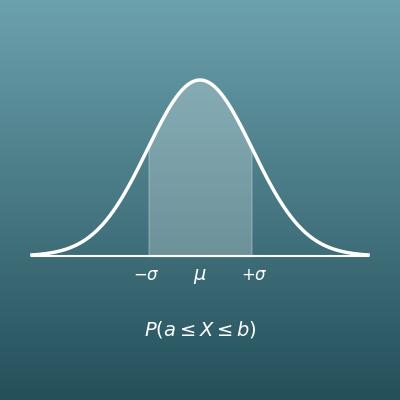
Normale verdeling berekenen (kans tussen twee waarden en z-tabel)
Berekent uit het gemiddelde en de standaardafwijking de kans op een bereik of de bovenste hoeveel procent