






























































































































사용법은 두 가지입니다. ① 신뢰수준, 모비율, 허용오차를 넣어 ‘필요한 표본 크기’를 구합니다. ② 신뢰수준, 모비율, 표본 크기를 넣어 ‘허용오차’를 구합니다. 모집단의 크기는 알고 있을 때만 입력하세요.
이 페이지에서 할 수 있는 것
- ‘신뢰수준 95%, 오차 ±5%로 조사하려면 몇 명에게 설문해야 할까?’ 조사에 필요한 표본 크기를 그 자리에서 알 수 있습니다
- 반대로 ‘1,000명에게 조사한 결과는 ±몇 %까지 믿을 수 있을까?’ 허용오차(표본오차)도 같은 페이지에서 계산할 수 있습니다
- 모집단의 크기를 알고 있다면(직원 500명, 회원 1,000명 등) 유한모집단 수정으로 ‘정말 필요한 인원’까지 줄일 수 있습니다
- 공식의 쉬운 해설과 Excel·Google 스프레드시트·Python에 그대로 복사해 쓸 수 있는 수식도 이 페이지에 정리되어 있습니다
이 계산은 어디에 쓰일까요?
신문이나 방송의 여론조사는 4,000만 명이 넘는 전국 유권자(한국 기준) 가운데 1,000명 안팎을 무작위로 뽑아 실시합니다. 기사에 자주 나오는 ‘95% 신뢰수준에 표본오차 ±3.1%p’는 응답자 1,000명, 모비율 50%일 때 \(1.96 \times \sqrt{0.25 \div 1000} \fallingdotseq 0.031\)로 계산한 값입니다. 반대로 허용오차를 ±3%로 정하면 필요한 표본 크기는 \(1.96^2 \times 0.25 \div 0.03^2 \fallingdotseq 1067.1\)(약 1,068명)입니다. ‘겨우 1,000명으로 수천만 명의 의견을 알 수 있을까?’라는 의문에 이 공식이 근거를 줍니다.
또 ‘지지율 45%와 47%의 차이’가 오차 ±3%p 범위 안이라면, 통계적으로는 차이가 있다고 단정할 수 없다는 식으로 읽을 수도 있게 됩니다.
‘회원 1,000명 중 몇 명에게 물으면 충분할까’는 유한모집단 수정까지 쓰는 대표적인 예입니다. 신뢰수준 95%, 허용오차 ±5%, 모비율 50%라면 수정 전의 계산값 384.16이 \(384.16 \div (1 + 383.16 \div 1000) \fallingdotseq 277.7\)(올림해서 278명)까지 줄어듭니다.
모두에게 거듭 응답을 독촉하기 전에 ‘몇 명이 모이면 목표 정밀도에 충분한가’를 먼저 정해 두면, 조사 비용과 정밀도의 균형을 숫자로 판단할 수 있습니다.
대량 생산한 부품의 불량률을 전수검사 없이 어림할 때도 이 공식을 씁니다. 과거 실적으로 불량률을 10% 안팎으로 예상하고 신뢰수준 90%, 허용오차 ±4%로 계산하면 \(1.65^2 \times 0.1 \times 0.9 \div 0.04^2 \fallingdotseq 153.1\)(약 154개)만 뽑아 검사하면 충분합니다.
모비율이 50%에서 멀어질수록 흩어진 정도 \(\hat{p}(1-\hat{p})\)가 작아져 필요한 개수가 줄어든다는 것도 이 예에서 알 수 있습니다.
‘어느 지역에서 이 증상이 있는 사람의 비율’을 알아보는 역학 조사에서는 연구 계획 단계에서 필요한 대상자 수를 밝히도록 요구됩니다. 선행 연구에서 유병률을 20% 안팎으로 예상하고 신뢰수준 95%, 허용오차 ±3%로 하면 \(1.96^2 \times 0.2 \times 0.8 \div 0.03^2 \fallingdotseq 683.0\)(약 683명)이 기준이 됩니다.
실제 임상 연구에서는 연구 설계에 맞춘 더 정밀한 방법(검정력 분석 등)을 함께 씁니다. 이 공식은 그 출발점이 되는 기본형입니다.
TV 시청률은 수천 가구 규모의 패널 조사로 추정합니다(실제 조사 방법은 더 복잡합니다). 단순화한 기준으로, 패널이 2,700가구이고 시청률 10%인 프로그램을 신뢰수준 95%로 생각하면 허용오차는 \(1.96 \times \sqrt{0.1 \times 0.9 \div 2700} \fallingdotseq 0.0113\)(±약 1.1%)입니다.
‘시청률 9.5%와 10.5%의 차이는 오차 범위일지도 모른다’는 식으로 볼 수 있게 되어, 숫자가 나오는 뉴스를 한층 깊이 읽을 수 있습니다.
공식
용어·기호 해설
기호
| \(n\) | 엔 | 표본 크기입니다. 설문이라면 실제로 응답을 모을 인원, 검사라면 조사할 개수입니다. |
| \(n_0\) | 엔 제로 | 모집단을 충분히 크다고 보았을 때 필요한 표본 크기의 계산값입니다. 유한모집단 수정을 하기 전의 값입니다. |
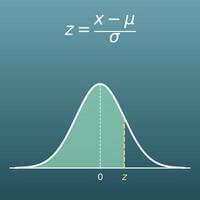
| \(z\) | 제트 | 신뢰수준에 대응하는 z점수(표준정규분포의 값)입니다. 신뢰수준 95%라면 1.96, 99%라면 2.58이 관례적인 값입니다. |
| \(\hat{p}\) | 피 햇 | 모비율(알아보고 싶은 ‘예’의 비율 등)입니다. 표본 크기를 구할 때는 ‘예상하는 값’을, 허용오차를 구할 때는 ‘조사에서 실제로 얻은 비율(표본비율)’을 넣습니다. 0~1 사이의 소수로 나타냅니다(50%라면 0.5). |
| \(\varepsilon\) | 엡실론 | 허용오차입니다. 조사 결과와 실제 값의 차이로 허용하는 폭으로, ‘±5%’처럼 ±를 붙여 나타냅니다. |
| \(N\) | 엔(대문자) | 모집단의 크기입니다. 알아보고 싶은 집단 전체의 인원이나 개수입니다(예: 전 직원 500명). |
용어
| 모집단 | 정말로 알고 싶은 대상의 전체를 말합니다. ‘전국의 유권자 전원’, ‘전 직원 500명’ 등입니다. |
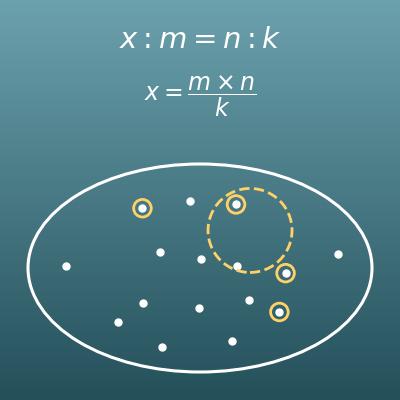
| 표본 (샘플) | 모집단 중에서 실제로 조사하기 위해 뽑은 일부를 말합니다. 표본의 인원이나 개수를 표본 크기(샘플 사이즈)라고 합니다. |
| 무작위 추출 | 제비뽑기처럼 모집단의 모두가 같은 확률로 뽑히도록 표본을 고르는 것입니다. 임의추출이라고도 합니다. 이 페이지의 공식은 무작위 추출이 전제이며, ‘답하고 싶은 사람만 답하는’ 설문에는 쓸 수 없습니다. |
| 모비율 | 모집단 전체에서의 ‘예’의 비율처럼, 정말로 알고 싶은 비율을 말합니다. 표본에서 얻은 비율은 ‘표본비율’이라고 불러 구별합니다. |
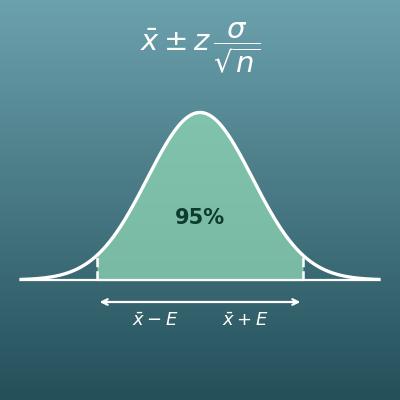
| 신뢰수준 | ‘같은 조사를 여러 번 되풀이했을 때, 그중 몇 %에서 결과가 오차 범위에 들어오는가’라는 확실성의 정도입니다. 95%를 가장 많이 씁니다. |
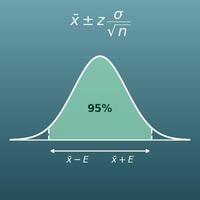
| 신뢰구간 | 조사 결과를 ‘52% ± 3%(49%~55%)’처럼 폭을 두어 나타낼 때의 그 범위를 말합니다. 이 페이지의 허용오차 ±ε가 그 폭에 해당합니다. |
| 허용오차 (표본오차) | 조사 결과와 실제 값의 차이로 허용하는 폭입니다. 뉴스의 여론조사에서 ‘95% 신뢰수준에 표본오차 ±3.1%p’라고 적혀 있는 것이 바로 이것입니다. |
| 유한모집단 수정 | 모집단의 크기가 유한하다고 알고 있을 때 필요한 표본 크기나 허용오차를 조금 작게 고치는 수정입니다. 모집단의 대부분을 조사할수록 결과가 확실해진다는 것을 반영합니다. |
먼저 알아 두면 좋은 내용
이 페이지의 계산을 ‘뜻을 이해하고’ 쓸 수 있도록, 미리 알아 두면 좋은 내용을 정리했습니다.
| 비와 비율·백분율(초등학교 6학년, 11~12세) |
|
| 제곱근(중학교 3학년, 14~15세) |
|
| 모집단과 표본(고등학교 확률과 통계, 16~18세) |
|
| 정규분포와 통계적 추정(고등학교 확률과 통계, 16~18세) |
|
Excel로 계산하는 방법
| z점수(신뢰수준 95%라면 1.96) | 1.96 |
| 예상 모비율(%) | 50 |
| 허용오차(%) | 5 |
| 계산값 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 필요한 표본 크기(올림) | =ROUNDUP(B4,0) |
| z점수(신뢰수준 95%라면 1.96) | 1.96 |
| 예상 모비율(%) | 50 |
| 허용오차(%) | 5 |
| 모집단의 크기 N | 500 |
| 수정 전의 계산값 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 필요한 표본 크기(수정 + 올림) | =ROUNDUP(B5/(1+(B5-1)/B4),0) |
| z점수(신뢰수준 95%라면 1.96) | 1.96 |
| 조사에서 얻은 비율(%) | 60 |
| 표본 크기 n | 100 |
| 허용오차(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| z점수(신뢰수준 95%라면 1.96) | 1.96 |
| 조사에서 얻은 비율(%) | 30 |
| 표본 크기 n | 200 |
| 모집단의 크기 N | 1000 |
| 수정 전의 허용오차(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| 수정 후의 허용오차(%) | =B5*SQRT((B4-B3)/(B4-1)) |
첫 번째 표라면 B4에 384.16, B5에 385가 표시됩니다. 두 번째 표의 답은 218, 세 번째는 약 9.60(%), 네 번째는 약 5.68(%)입니다.
‘^’는 거듭제곱(제곱), ‘SQRT’는 제곱근, ‘ROUNDUP’은 올림 함수입니다.
참고로 이 페이지의 계산기는 계산값이 딱 정수일 때도 안전한 쪽으로 1을 더해 올리므로, 끝수가 없는 계산값에서는 Excel의 ROUNDUP과 1만큼 차이가 날 수 있습니다.
Google 스프레드시트로 계산하는 방법
| z점수(신뢰수준 95%라면 1.96) | 1.96 |
| 예상 모비율(%) | 50 |
| 허용오차(%) | 5 |
| 계산값 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 필요한 표본 크기(올림) | =ROUNDUP(B4,0) |
| z점수(신뢰수준 95%라면 1.96) | 1.96 |
| 예상 모비율(%) | 50 |
| 허용오차(%) | 5 |
| 모집단의 크기 N | 500 |
| 수정 전의 계산값 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 필요한 표본 크기(수정 + 올림) | =ROUNDUP(B5/(1+(B5-1)/B4),0) |
| z점수(신뢰수준 95%라면 1.96) | 1.96 |
| 조사에서 얻은 비율(%) | 60 |
| 표본 크기 n | 100 |
| 허용오차(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| z점수(신뢰수준 95%라면 1.96) | 1.96 |
| 조사에서 얻은 비율(%) | 30 |
| 표본 크기 n | 200 |
| 모집단의 크기 N | 1000 |
| 수정 전의 허용오차(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| 수정 후의 허용오차(%) | =B5*SQRT((B4-B3)/(B4-1)) |
Python으로 계산하는 방법
import math

# 신뢰수준(%) → z점수 조견표(관례적인 반올림 값)
z_table = {80: 1.28, 85: 1.44, 90: 1.65, 95: 1.96, 98: 2.33, 99: 2.58}

# ---- 사용법 ①: 필요한 표본 크기 구하기 ----
confidence_level = 95    # 신뢰수준(%)
population_ratio = 50    # 예상 모비율(%)
margin_of_error = 5      # 허용오차(%)
population_size = None   # 모집단의 크기(모르거나 충분히 크면 None)

z = z_table[confidence_level]
p = population_ratio / 100
e = margin_of_error / 100

raw_size = z ** 2 * p * (1 - p) / e ** 2   # 수정 전의 계산값
if population_size is not None:
    raw_size = raw_size / (1 + (raw_size - 1) / population_size)   # 유한모집단 수정
required_size = math.floor(raw_size) + 1   # 계산값보다 큰 가장 작은 정수(안전한 쪽으로 올림)
print(f"필요한 표본 크기: {required_size}")

# ---- 사용법 ②: 허용오차 구하기 ----
sample_size = 1000       # 실제로 조사한 표본 크기
sample_ratio = 50 / 100  # 조사에서 얻은 비율(50%라면 0.5)

error_ratio = z * math.sqrt(sample_ratio * (1 - sample_ratio) / sample_size)
print(f"허용오차: ±{error_ratio * 100:.2f}%")
LaTeX 등 수식 언어로 쓰는 법(복사 가능)
n₀ = z² × p̂(1 − p̂) ÷ ε²
n_0 = \dfrac{z^2 \, \hat{p}(1-\hat{p})}{\varepsilon^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>n</mi><mn>0</mn></msub>
<mo>=</mo>
<mfrac>
<mrow>
<msup><mi>z</mi><mn>2</mn></msup>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<msup><mi>ε</mi><mn>2</mn></msup>
</mfrac>
</mrow>
</math>
n_0 = (z^2 hat(p)(1 - hat(p)))/(epsilon^2)
z^2*p*(1 - p)/err^2
n0 := z^2*p*(1 - p)/err^2;
n0 = z^2*p*(1 - p)/err^2;
n_0 = (z^2 p̂(1 − p̂))/ε^2
n = n₀ ÷ (1 + (n₀ − 1) ÷ N)
n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msub><mi>n</mi><mn>0</mn></msub>
<mrow>
<mn>1</mn><mo>+</mo>
<mfrac>
<mrow><msub><mi>n</mi><mn>0</mn></msub><mo>−</mo><mn>1</mn></mrow>
<mi>N</mi>
</mfrac>
</mrow>
</mfrac>
</mrow>
</math>
n = n_0/(1 + (n_0 - 1)/N)
n0/(1 + (n0 - 1)/nPop)
n := n0/(1 + (n0 - 1)/N);
n = n0/(1 + (n0 - 1)/N);
n = n_0/(1 + (n_0 − 1)/N)
ε = z × √(p̂(1 − p̂) ÷ n)
\varepsilon = z \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<mi>z</mi>
<msqrt>
<mfrac>
<mrow>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<mi>n</mi>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = z sqrt((hat(p)(1 - hat(p)))/n)
z*Sqrt[p*(1 - p)/n]
err := z*sqrt(p*(1 - p)/n);
err = z*sqrt(p*(1 - p)/n);
ε = z√((p̂(1 − p̂))/n)
ε = ε₀ × √((N − n) ÷ (N − 1))
\varepsilon = \varepsilon_0 \sqrt{\dfrac{N-n}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<msub><mi>ε</mi><mn>0</mn></msub>
<msqrt>
<mfrac>
<mrow><mi>N</mi><mo>−</mo><mi>n</mi></mrow>
<mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = epsilon_0 sqrt((N - n)/(N - 1))
err0*Sqrt[(nPop - n)/(nPop - 1)]
err := err0*sqrt((N - n)/(N - 1));
err = err0*sqrt((N - n)/(N - 1));
ε = ε_0 √((N − n)/(N − 1))
ChatGPT 에게 물어서 계산하는 방법
당신은 통계 조사 계산 도우미입니다. 다음 계산을 반드시 Python 코드를 실제로 실행해서 하고, 실행 결과의 숫자만을 근거로 답해 주세요(암산이나 추측으로 답하지 마세요).

회원 1,000명인 서비스에서 만족도 설문을 합니다. 신뢰수준 95%(z점수 1.96), 예상 모비율 50%, 허용오차 ±5%로 합니다.
다음 값을 각각 구해 주세요.
1. 모집단을 충분히 크다고 보았을 때 필요한 표본 크기(계산값과 올림한 인원)
2. 모집단을 1,000명으로 보고 유한모집단 수정을 했을 때 필요한 표본 크기
3. 만약 응답이 200명밖에 모이지 않았을 때의 허용오차(유한모집단 수정 포함, %)

계산에 쓴 식과 실행 결과의 숫자를 보여 주세요.
사용법
-
1숫자 입력계산하고 싶은 숫자를 입력란에 입력합니다
-
2계산‘계산’ 버튼을 누릅니다
-
3결과 확인계산 결과가 바로 표시됩니다. 계산의 원리와 공식 해설도 같은 페이지에서 확인할 수 있습니다
DataChef의 특징

전문 지식 없이도 직관적이고 간단하게 사용

개인정보를 등록하지 않고도 이용할 수 있습니다

"다운로드"를 누르면 파일이 자동으로 삭제됩니다


출처 표기 불필요

상업적 이용 허가 연락도 필요 없습니다
관련 기능
신뢰구간 계산기(모평균의 구간추정)
평균이나 비율의 신뢰구간(95% 신뢰구간 등)을 계산합니다
z점수 계산기(z값과 확률 상호 변환)
값, 평균, 표준편차로 z점수를 계산하고 확률과도 서로 바꿀 수 있습니다
정규분포 확률 계산기
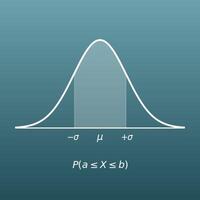
평균과 표준편차로 지정한 범위에 들어갈 확률을 계산합니다